英伟达全模态大模型 Nemotron 3 Nano Omni 来了,几秒搞定老黄3分钟演讲,吞吐量同类9倍(在新窗口打开)
英伟达于昨日正式推出全新多模态推理模型Nemotron 3 Nano Omni,将文本、视觉、语音三大模态能力深度融合至单一模型体系,目前可免费使用。
共 438 篇
英伟达于昨日正式推出全新多模态推理模型Nemotron 3 Nano Omni,将文本、视觉、语音三大模态能力深度融合至单一模型体系,目前可免费使用。
OmniVinci是英伟达推出的全模态大模型,能精准解析视频和音频,尤其擅长视觉和听觉信号的时序对齐。它以90亿参数规模,性能超越同级别甚至更高级别模型,训练数据效率是对手的6倍,大幅降低成本。在视频内容理解、语音转录、机器人导航等场景中,OmniVinci能提供高效支持,展现出卓越的多模态应用能力。
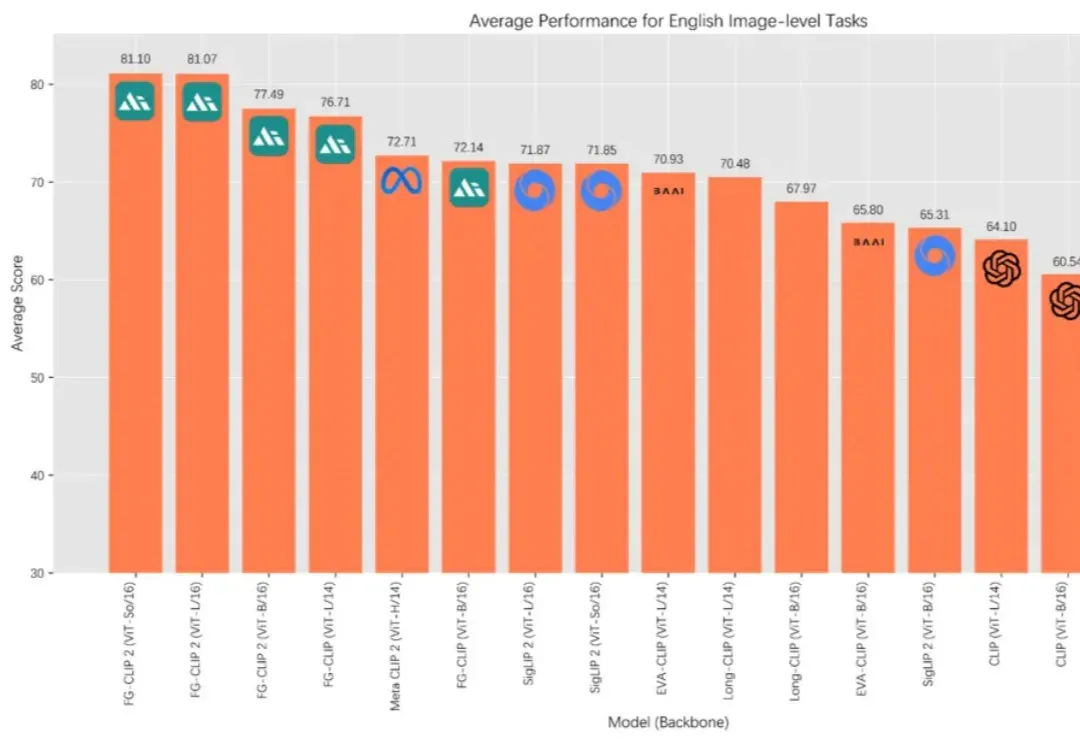
在 AI 多模态的发展历程中,OpenAI 的 CLIP 让机器第一次具备了“看懂”图像与文字的能力,为跨模态学习奠定了基础。如今,来自 360 人工智能研究院冷大炜团队的 FG-CLIP 2 正式发布并开源,在中英文双语任务上全面超越 MetaCLIP 2 与 SigLIP 2,并通过新的细粒度对齐范式,补足了第一代模型在细节理解上的不足。
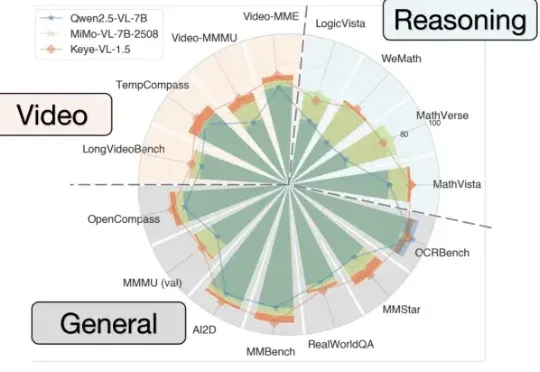
能看懂视频并进行跨模态推理的大模型Keye-VL 1.5,快手开源了。
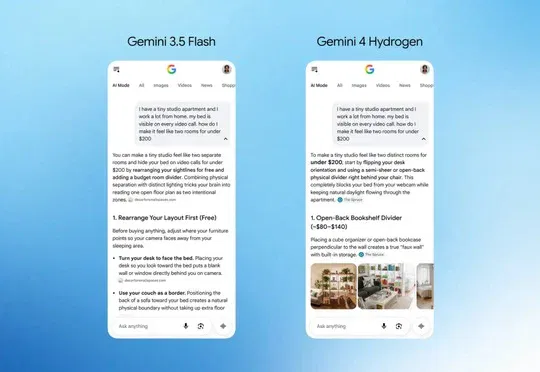
新版模型主打快速执行,覆盖编码与多模态任务。谷歌同步介绍不同入口的开放范围、API 价格和模型调度测试。
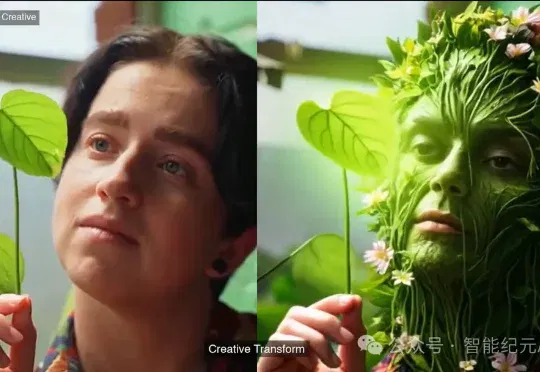
独家获悉,字节跳动日前低调公布全球首个25B级、基于混合专家 (MoE) -扩散自注意力机制(DiT) 的开源增强统一多模态模型Mamoda2.5。Mamoda2.5依托Qwen3-VL-8B、128 个专家,Top-8 路由的MoE+DiT架构搭建,最终模型参数高达250亿,而每次仅激活约30亿参数(约12%)。
国产大模型阵营再添硬核选手,智谱开放平台GLM5.1正式上线,推理、代码、智能体能力拉满,还为新用户准备了2000万Tokens免费体验包,覆盖多模型使用额度,有效期3个月。不管是日常编程开发、智能体搭建,还是多模态内容创作,这个免费额度都能轻松拿捏,新手也能零门槛上手,这波福利可别错过。
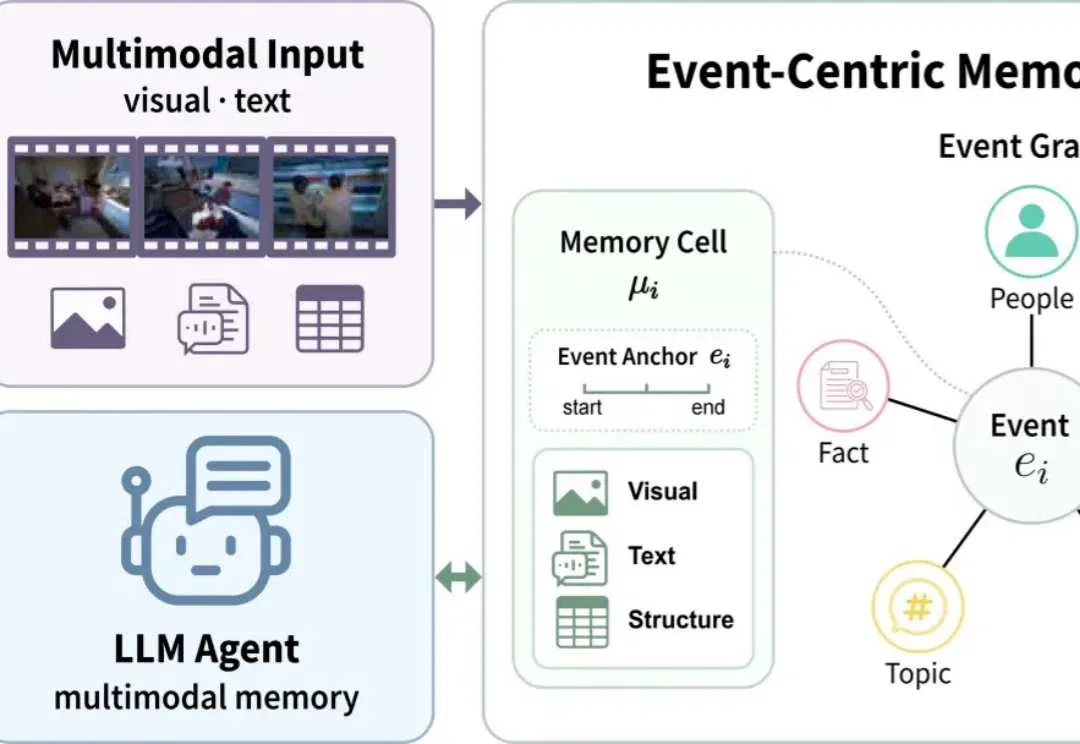
浙大与联想团队把跨模态对齐提前到记忆构建,测试长视频问答和证据定位;查询更轻,但需计入前期构建开销。

就在刚刚,OpenAI又进化了。 现在,备受瞩目的ChatGPT Sites正式开启公测! 哪怕你一行代码都不会写,只需几句自然语言提示或上传一张草图,就能像写Google文档一样,在十几分钟内生成一个高度专业、功能复杂的交互式网站。 只用自然语言就能完成前端开发,传统的建站SaaS行业正遭受巨大的颠覆。 而且,还有一个新消息传出。 在底层技术侧,GPT-6展现出了惊人的跨模态能力。 在无音频播放、完全断网的状态下,仅凭一张Mel频谱图(声音的波形可视化图像),GPT-6就能认出深海蓝鲸的叫声,甚至还能认出《星球大战》中的光剑音效。 这就显示着,AI的多模态理解,已经彻底打破了人类的感官壁垒。
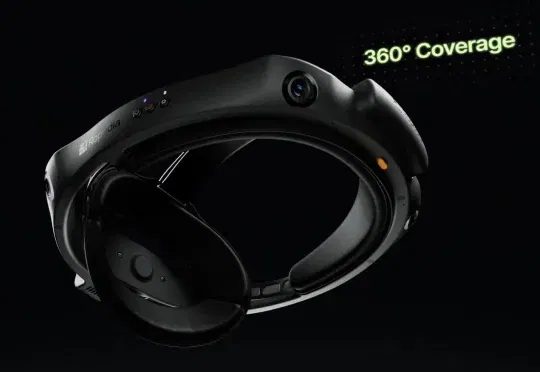
新加坡Physical AI公司Ropedia正式发布新一代多模态采集系统HOMIE Gen2,以4目全景360°、十余种模态同步采集与开箱即用的高精度训练级数据,将人类经验规模化为机器人可直接学习的训练数据,推动Physical AI的经验规模化落地。