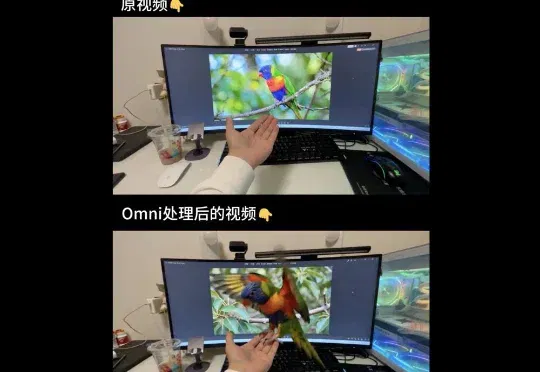
P视频这个事儿终于有工具能搞定了!(在新窗口打开)
其实Omni Flash和Seedance 2.0还真不一样,Omni Flash的能力是编辑视频,对原有视频的极度控制,而非直接生成视频。先给朋友们看几个实测案例吧,你可能就会有更深的体感。
共 163 篇
其实Omni Flash和Seedance 2.0还真不一样,Omni Flash的能力是编辑视频,对原有视频的极度控制,而非直接生成视频。先给朋友们看几个实测案例吧,你可能就会有更深的体感。
两万多名快手员工,今年以来最关心的话题就是可灵。 这不仅因为它已成为快手最具想象力的AI业务,还因为5月传出拆分上市的消息后,可灵估值一度超过母公司快手的三分之二。 可灵几乎成为全村的希望。过去的舆论
走在风口浪尖,拥抱最新的技术。 “世界模型”并不是新概念。但在2026 年,具身智能的“泛化瓶颈”,直接把“世界模型”推向了风口。 大洋彼岸,李飞飞的 World Labs 估值突破 50 亿美元,杨立昆的 AMI Labs 获超 10 亿美元种子轮融资,迅速推高了“世界模型”赛道的热度。资本加速涌来。世界模型及相关赛道国内已有超 33 家企业完成融资,累计吸金超 260 亿人民币。 与此同时,巨头们也在提速。阿里的 Qwen-RobotWorld、腾讯的 HY-World、字节的 Seed3D 迅速更迭;华为虽不常公开提及"世界模型",却已将盘古大模型定位为具身与自动驾驶的"训练底座"。 大
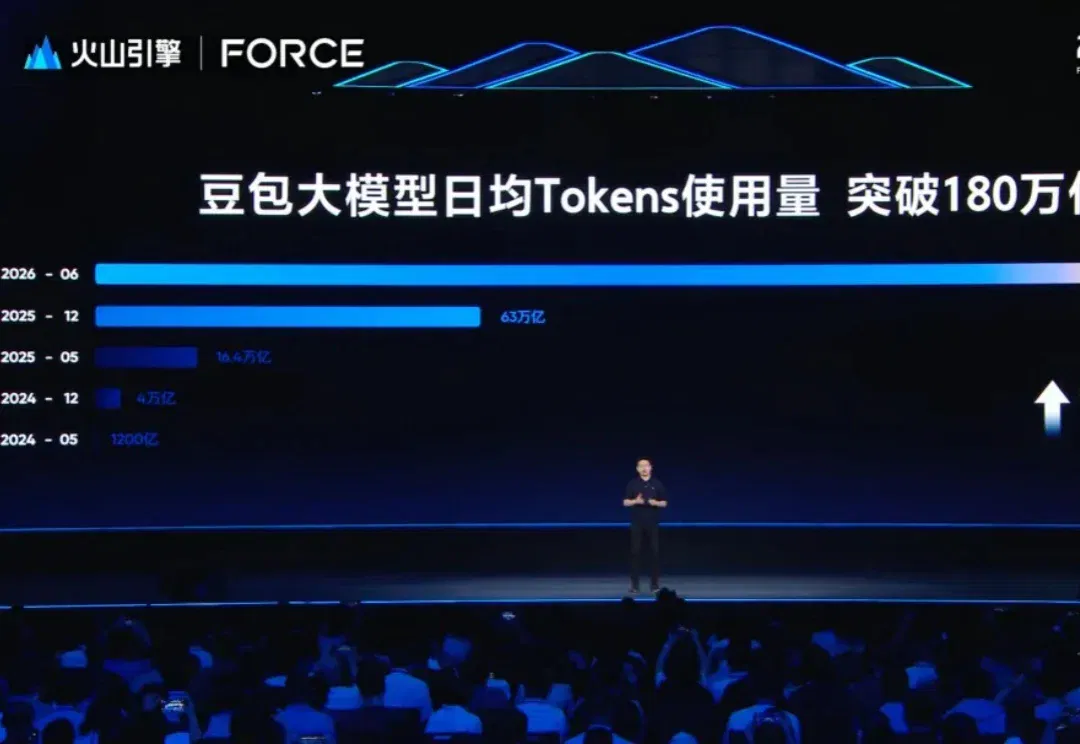
180 万亿。这是截至今年 6 月,豆包大模型的日均 token 调用量。
从 Founder Park 出去后,Muji 去新加坡深造了一年,然后以 COO 的身份加入了 Seede AI。
你为什么选了做视觉有关的方向呢?跟你对市场、对成都的观察有关吗?我们现在用的很多传统的 APP,包括很多操作系统,我觉得未来会被替代掉的。因为很多是很“反人类”的设计。这些东西的本质是“系统状态的流转”,没有一个正常人喜欢用这些系统。而这部分,数据的流转,是 Agent 能替我们做的。最终一定会剩下一些简洁的信息要呈现给人——我们做的,反而应该是这个部分。
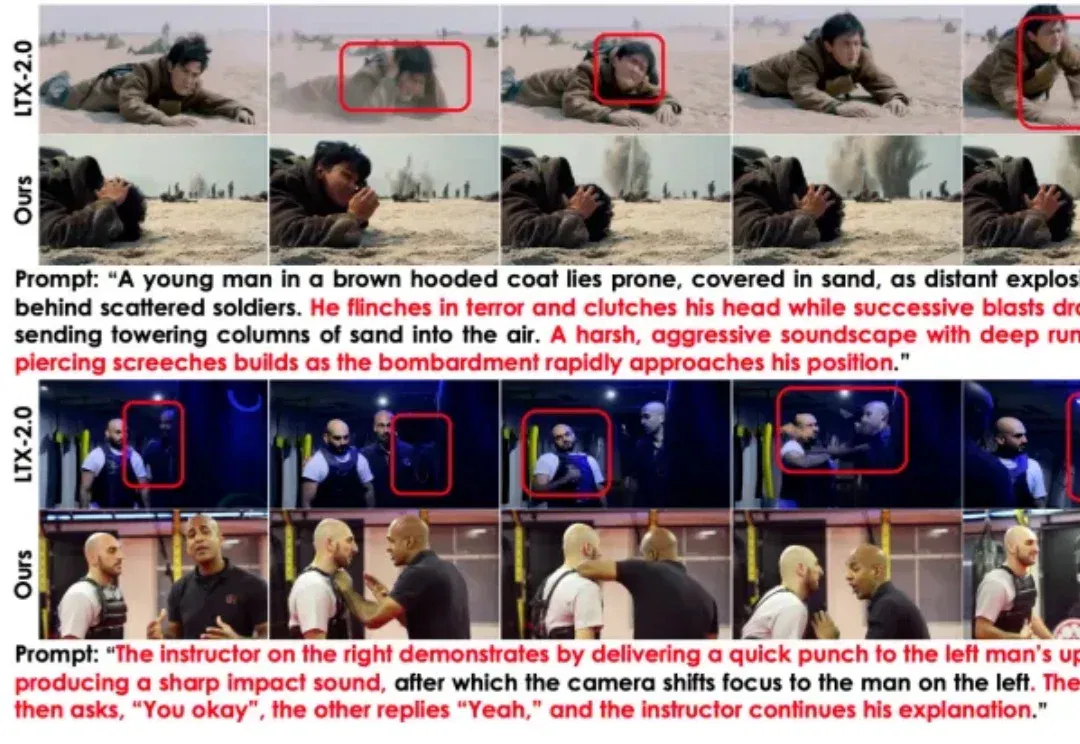
视频生成,早已不止于视觉。 随着生成式AI发展,联合视频—音频生成正成为重要研究方向。与视频优先、音频后期合成的传统流水线相比,原生同步生成的视听内容跨模态一致性更强,用户体验更沉浸。 但问题在于,现有开源模型面对复杂语义时力不从心。 遇到多阶段动作的组合式指令、涉及人与物体交互的复杂任务时,模型往往无法准确建模场景中的时序逻辑和因果关系——不仅要求长程语义推理能力,还必须在推理中维持视频与音频的时空一致性。 核心矛盾在于:现有方法依赖粗粒度全局文本嵌入指导扩散过程,无法将多阶段动作与多说话人对话分解为具有时间对齐的指导信息,视频和音频去噪轨迹因此各自演化,最终跨模态失配。 为解决这一问题,复
如果模型能力断层领先,那么买单的人自然会出现。
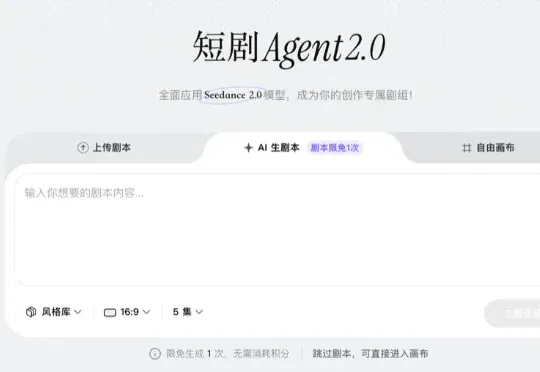
近日,字节旗下AI视频创作工具小云雀的短剧Agent正式更新到2.0版本。自Seedance 2.0这一视频生成模型横空出世以来,小云雀一直是其原生支持的平台。由于整体使用门槛相对较低,小云雀也逐渐积累起一批AI短剧和AI短片创作者。
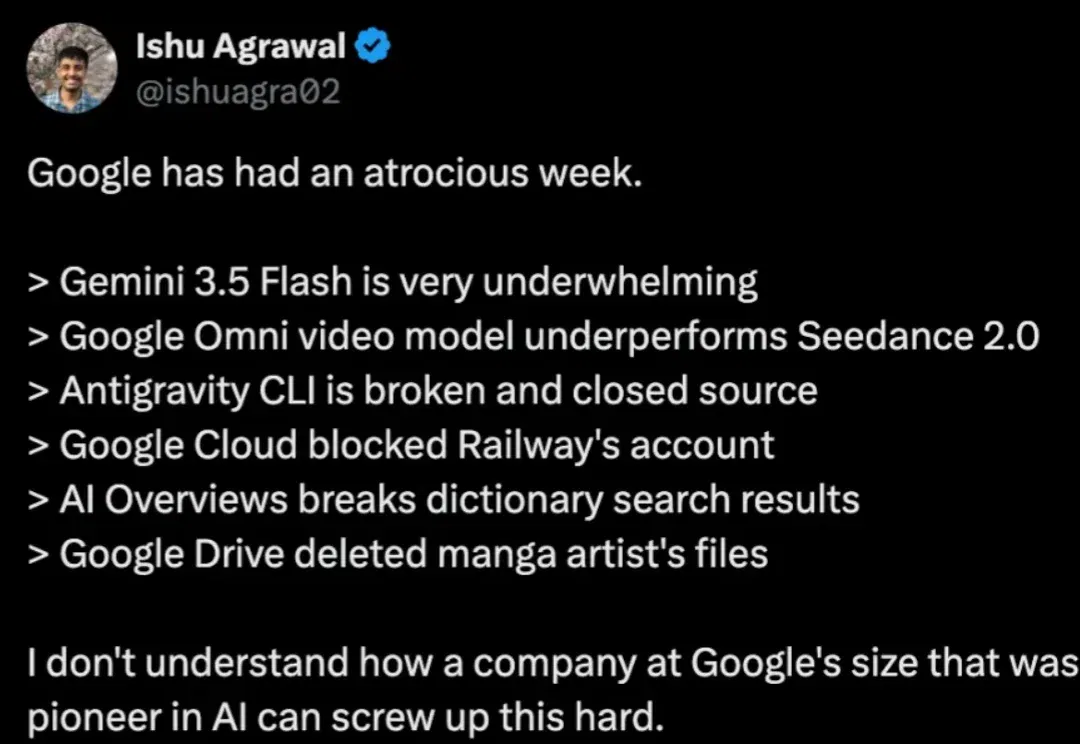
最近,谷歌的日子不太好过。 自从 I/O 大会以来,谷歌经历了连环翻车: Gemini 3.5 Flash 被网友吐槽实际体验、额度消耗和稳定性不及预期;Gemini Omni Flash 原生多模态视频生成与编辑模型,表现不如 Seedance 2.0;Antigravity CLI 闭源、bug 多、且还被抓到演示视频里出现 Codex 文件;Google Cloud 自动风控系统错误封禁了知名 PaaS 平台 Railway 的账号,导致 Railway 服务大面积宕机好几个小时;AI Overviews 搜索 disregard、ignore 等单词时,AI 不正常显示字典释义,把搜索