视频生成不再「断片」:OneStory给模型装上「选择性记忆」,跨镜头讲故事人物场景始终如一丨CVPR'26(在新窗口打开)
最近,来自Meta与University of Copenhagen的研究者提出了OneStory: Coherent Multi-Shot Video Generation with Adaptive Memory(收录于CVPR 2026)。这项工作聚焦于一个核心问题:如何在生成多镜头视频时,有效保留长程跨镜头上下文,从而实现更强的叙事一致性。
共 129 篇
最近,来自Meta与University of Copenhagen的研究者提出了OneStory: Coherent Multi-Shot Video Generation with Adaptive Memory(收录于CVPR 2026)。这项工作聚焦于一个核心问题:如何在生成多镜头视频时,有效保留长程跨镜头上下文,从而实现更强的叙事一致性。
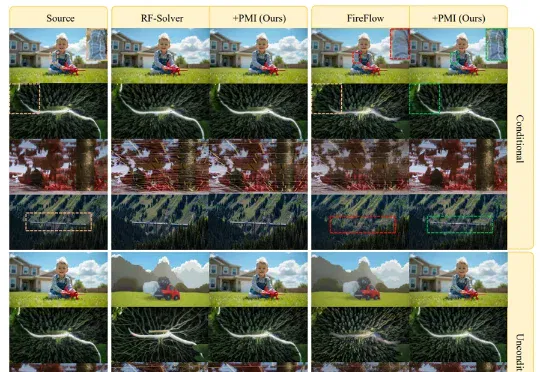
现有Rectified Flow(RF)模型在反演阶段面临的核心挑战,是逆向ODE对微小误差高度敏感,容易沿着数值不稳定方向偏离前向流形,导致轨迹发散、重建不一致、编辑不可控。为解决这一问题,团队提出PMI(Prox-Mean-Inversion),一种针对RF反演稳定性的轻量化修正机制。
Matt Shumer 是 AI 创业者和投资者,已在 AI 领域深耕超过 6 年。他是 OthersideAI 的联合创始人兼 CEO,同时通过个人投资基金 Shumer Capital 投资了 Groq、Etched、OpenRouter 等多家前沿 AI 初创公司。
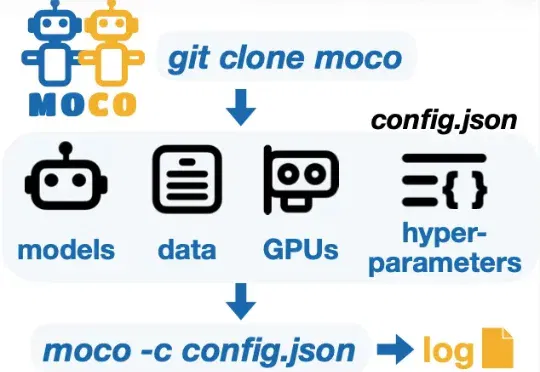
为了支持多模型协同研究并加速这一未来愿景的实现,华盛顿大学 (University of Washington) 冯尚彬团队联合斯坦福大学、哈佛大学等研究人员提出 MoCo—— 一个针对多模型协同研究的 Python 框架。MoCo 支持 26 种在不同层级实现多模型交互的算法,研究者可以灵活自定义数据集、模型以及硬件配置,比较不同算法,优化自身算法,以此构建组合式人工智能系统。MoCo 为设计、
该事故目前已得到谷歌官方技术团队的确认,官方承认属于 “Systemic path-parsing failure ”“Catastrophic impact”“Have seen before”,正在紧急硬编码修复上线中(自 2 月 6 日回复起,截止目前,暂未有修复完成的正式通知)
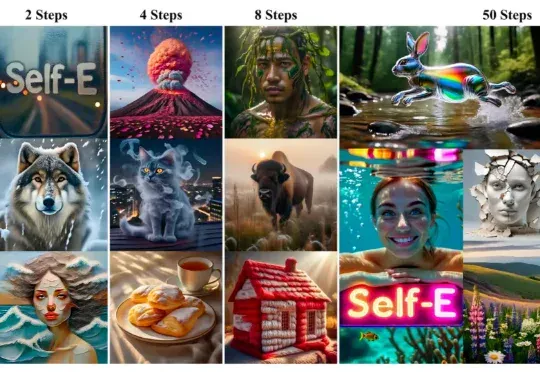
香港大学(The University of Hong Kong)与 Adobe Research 联合发布 Self-E(Self-Evaluating Model):一种无需预训练教师蒸馏、从零开始训练的任意步数文生图框架。其目标非常直接:让同一个模型在极少步数也能生成语义清晰、结构稳定的图像,同时在 50 步等常规设置下保持顶级质量,并且随着步数增加呈现单调提升。
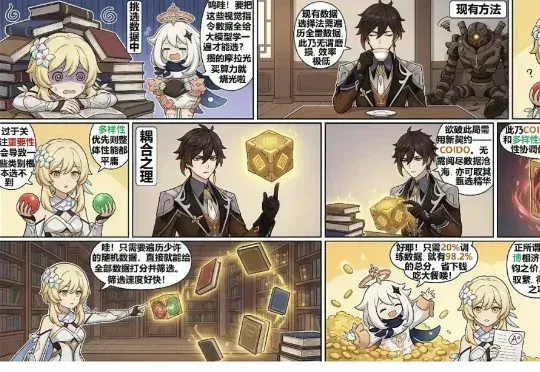
在深入技术细节之前,我们先用一张漫画来直观理解 COIDO (Coupled Importance-Diversity Optimization) 解决的核心问题与方案:正如钟离在漫画中所言,面对海量视觉指令数据的选择任务,传统方法需要遍历全部数据才能进行筛选造成大量「磨损」(高昂计算成本)。同时在面对数据重要性和多样性问题时,传统方法往往顾此失彼。
复杂的简历,AI也能读懂了。 阿里巴巴集团研究团队,开发出了一套基于布局感知的简历解析框架。 该框架在简历解析任务上的准确率逼近Claude-4等业界顶尖大模型,处理整份简历仅需1-2秒。 而且这项创新直击自动化简历解析的三大痛点——版面格式多样、大模型成本高昂及响应速度慢,为智能招聘树立了新的效率与精度标杆。 该技术框架的论文《Layout-Aware Parsing Meets Efficient LLMs: A Unified, Scalable Framework for Resume Information Extraction and Evaluation》已发布。 长久以来,自动
近日,新西兰林肯大学(Lincoln University)的一门课程引发争议:因怀疑部分学生在作业中使用了生成式 AI 工具,任课教师决定让全班 100 多名学生重新接受线下考核。