搜索

关于“RL”的结果

共 362 篇

灵巧手能帮女友拧瓶盖了!同济清华上海交大等新成果 | CoRL 2025

灵巧手能帮女友拧瓶盖了!同济清华上海交大等新成果 | CoRL 2025(在新窗口打开)

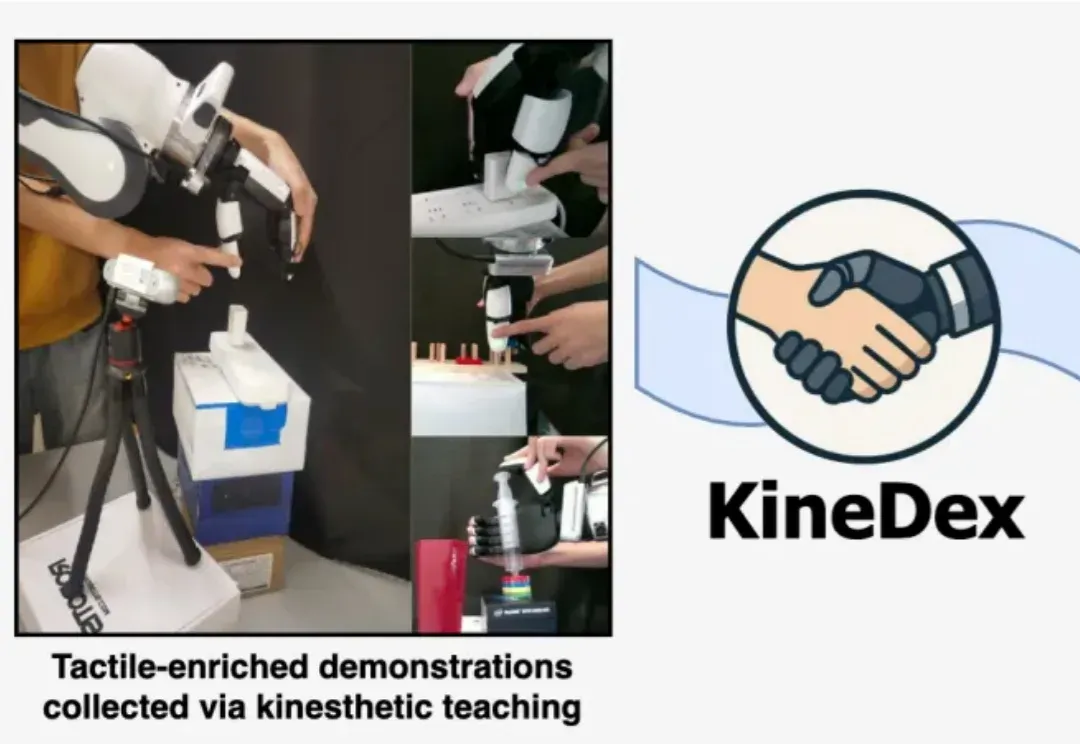
灵巧手技能+1,能帮女友拧瓶盖了! 不仅如此,还能帮忙挤牙膏、插充电器。 来自同济大学、清华、上海交大、香港大学等研究团队提出面向灵巧操作任务的示教与策略学习新方法KineDex框架—— 真·手把手指导的方式,让人类动作直接传递到灵巧手,并同步采集高保真触觉信息。 结果让星动纪元灵巧手星动XHAND 1成功解锁了各种复杂精细操作。 在瓶盖旋紧、牙膏挤压、注射器按压等九项复杂任务中,KineDex平均成功率达74.4%,且数据采集效率相较于遥操提升两倍以上。 该论文已被CoRL 2025接收。 真·手把手引导灵巧操作学习 当前,机器人学习精细操作(尤其那种需要精确力度控制的任务)的难点在于缺乏高
AI技术文章
0
从「知题」到「知人」:UserRL让智能体学会「以人为本」

从「知题」到「知人」:UserRL让智能体学会「以人为本」(在新窗口打开)

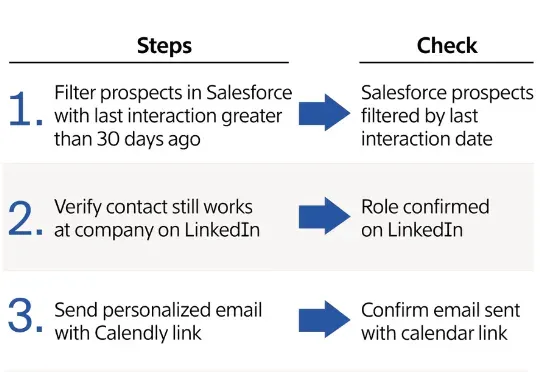
来自 UIUC 与 Salesforce 的研究团队提出了一套系统化方案:UserBench —— 首次将 “用户特性” 制度化,构建交互评测环境,用于专门检验大模型是否真正 “懂人”;UserRL —— 在 UserBench 及其他标准化 Gym 环境之上,搭建统一的用户交互强化学习框架,并系统探索以用户为驱动的奖励建模。

AI技术文章
0
清华、NVIDIA、斯坦福提出DiffusionNFT:基于前向过程的扩散强化学习新范式,训练效率提升25倍

清华、NVIDIA、斯坦福提出DiffusionNFT:基于前向过程的扩散强化学习新范式,训练效率提升25倍(在新窗口打开)

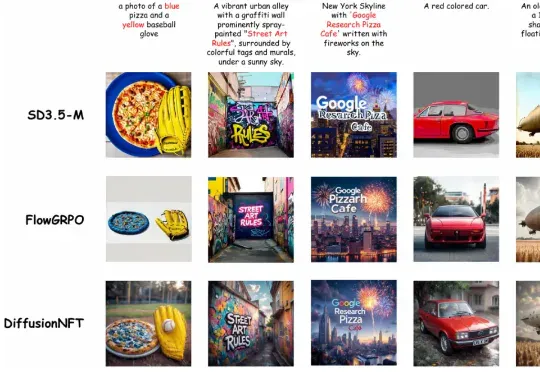
清华大学朱军教授团队,NVIDIA Deep Imagination 研究组与斯坦福 Stefano Ermon 团队联合提出了一种全新的扩散模型强化学习(RL)范式 ——Diffusion Negative-aware FineTuning (DiffusionNFT)。该方法首次突破现有 RL 对扩散模型的基本假设,直接在前向加噪过程(forward process)上进行优化

AI技术文章
0