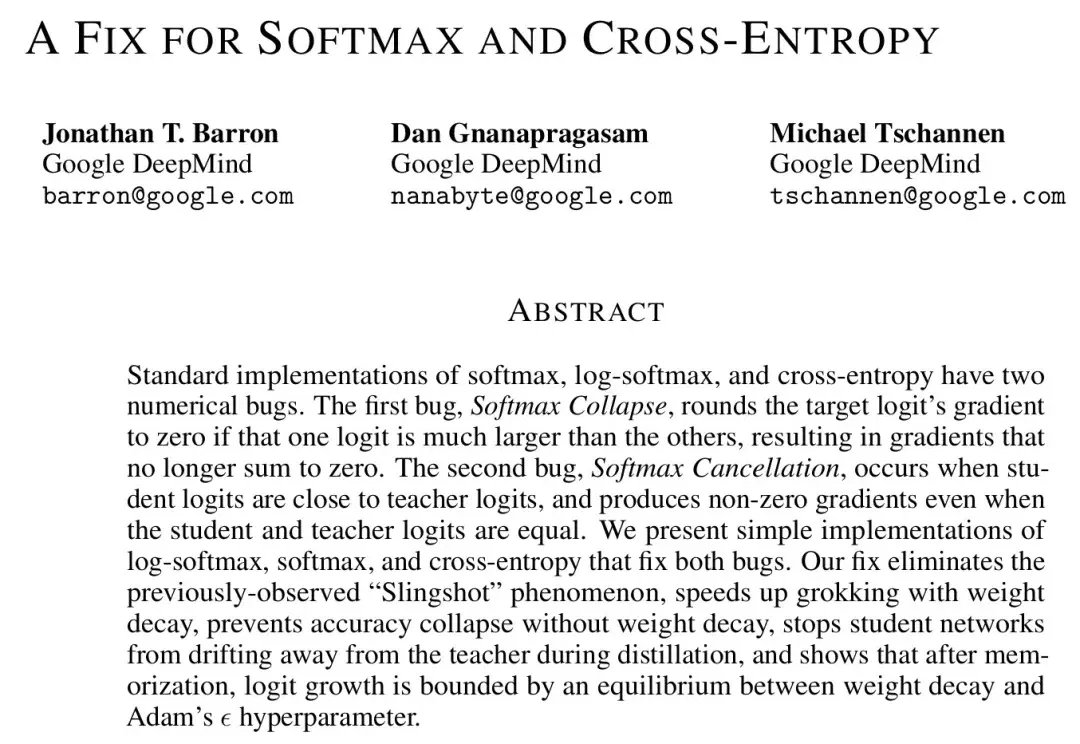
PyTorch、JAX都被点名!Softmax曝出隐藏Bug,Gemini立功(在新窗口打开)
深度学习中最基础、使用最广泛的两个函数,竟然藏着两个隐蔽的 Bug。
共 278 篇
深度学习中最基础、使用最广泛的两个函数,竟然藏着两个隐蔽的 Bug。
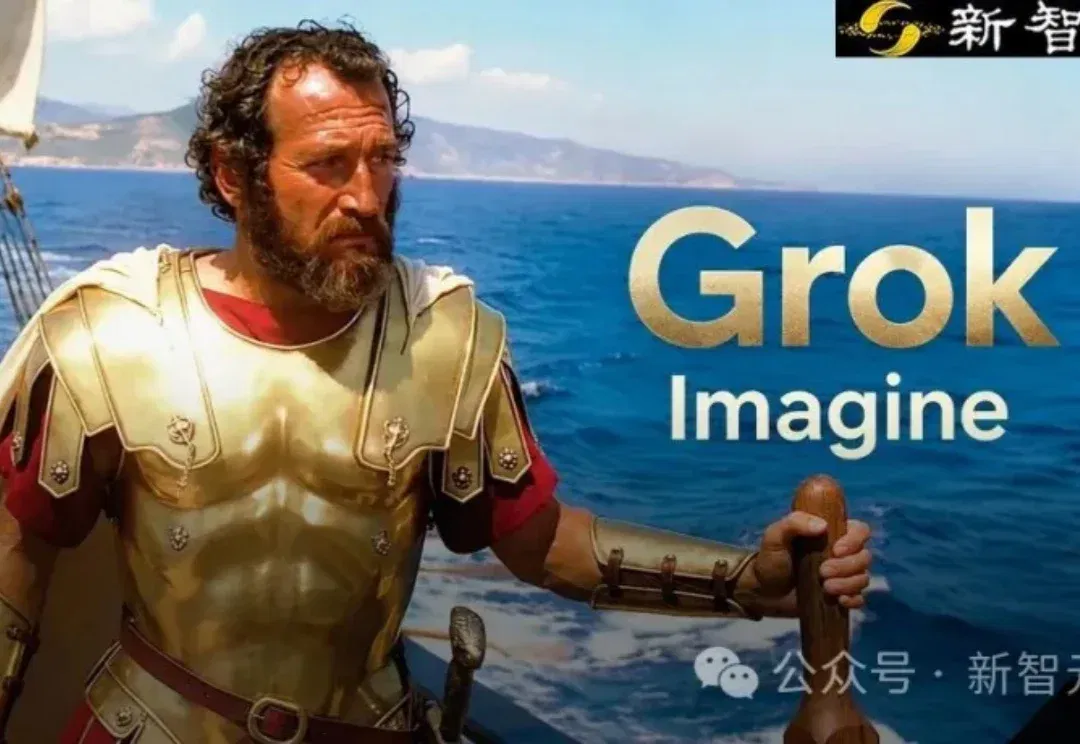
一段3分钟的AI短片,炸了。 X上一个叫Heavy Pulp的创作者,用Grok Imagine生成了一段《奥德赛》的对话场景——卡吕普索挽留奥德修斯的那场戏。 海风、岩洞、光影、人物的微表情,几个机位来回切,镜头语言竟然像模像样。 评论区直接疯了,被吹成「AI电影的iPhone时刻」。 网友直接说:「荷马会对这个作品感到骄傲!」。 有人感慨:「这正是我阅读时想象中的奥德修斯。」 更是有人原地开始拉踩诺兰。 然后,马斯克看见了。 他转发了这段短片,紧跟着甩出一句话: 「在今年结束之前,Grok Imagine将制作一部全长电影版《奥德赛》——历史准确、忠于荷马的艺术。」 注意措辞:不是预告片,
一觉醒来,AI的新潮流变成了养猫???火速围观一下,刚刚全球流式音视频模型赛道闯进了一匹黑马,能力SOTA级,模型名字就叫缅因猫(MaineCoon)。养过缅因猫的朋友都知道,这个品种有个外号叫「猫狗」,意思是几乎你走到哪儿,它就跟到哪儿,相当粘人,互动感MAX。
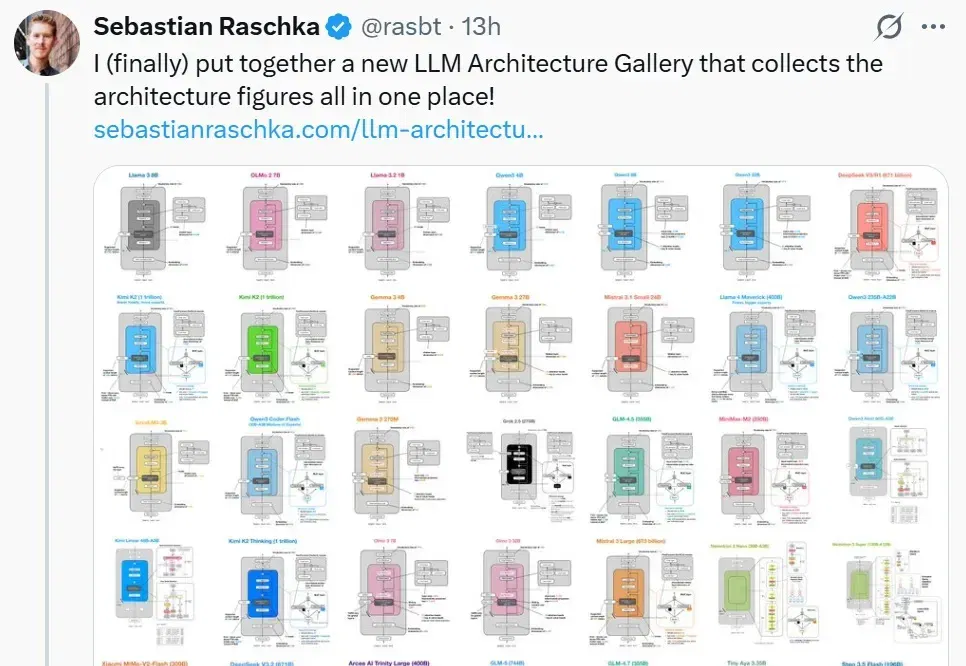
最近几年,大模型赛道好不热闹。 叫得上名字的几乎数都数不过来:从 GPT、Llama、Gemma、Mistral,到 DeepSeek、Qwen、Kimi、GLM、MiniMax 等等,新模型几乎以周更的速度出现。 但问题是,当架构创新越来越多时,理解它们反而变得越来越困难。不同论文里的模型结构图风格各异、模块命名不统一,即便是研究者,也很难快速看清一个模型究竟在哪些地方做出了关键改动。 如果把过去几年主流模型的架构放在一起,你会发现一个明显的空白:我们拥有大量模型,却缺少一张清晰的大模型架构图。 最近,AI 研究者 Sebastian Raschka 就尝试给了这样一张图,他将过去几年主流大
从未见过如此凡尔赛的名场面。云计算一哥亚马逊云科技CEO Matt Garman,在自家年度盛宴re:Invent 2025中,因为还要发布的新产品太多了,于是他在现场来了一句: 我挑战一下10分钟内发布25个产品!
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。

一周之内大语言、图片、视频模型都迎来新赛季:OpenAI的GPT-6 Astra让编码 Agent更好地使用游戏引擎和Blender,自己改场景、自己跑、自己测;GPT-image-2.5上线,更快更强,图片编辑和关键帧动画显著提升;fal和Yoroll分别发布 H3 MaxTurbo和H3 Superfast后训练加速模型,5秒视频3秒内推理,实时生成和互动玩法纷纷涌现。
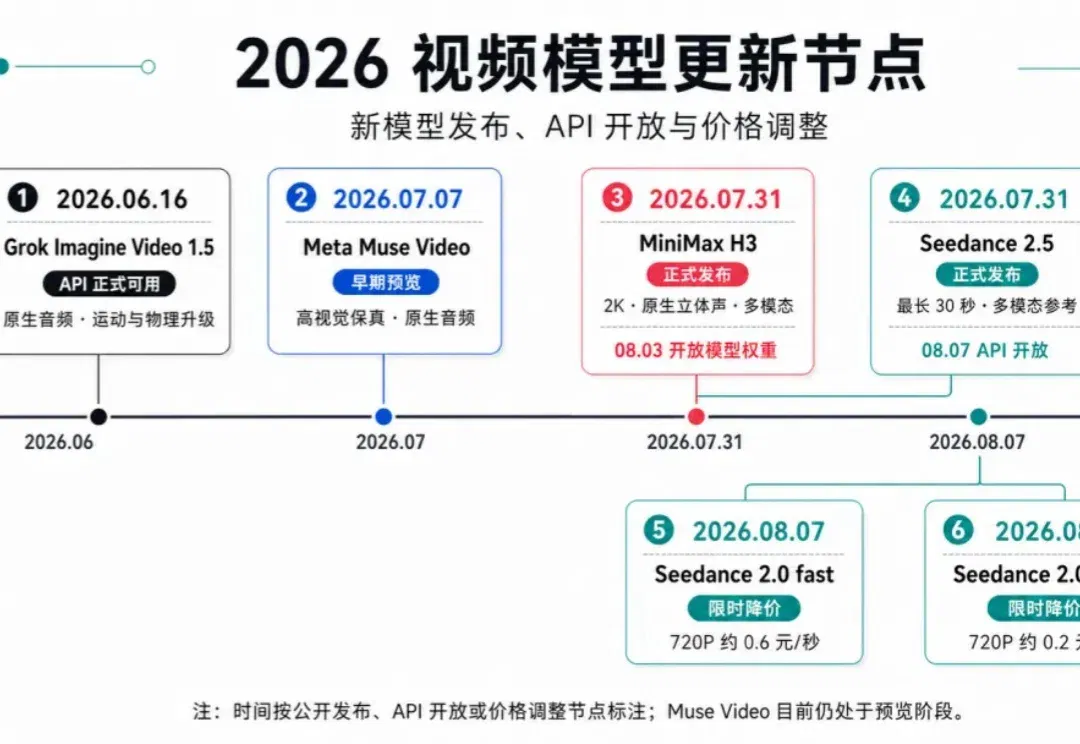
大家好,这里是K姐。 一个帮助你把AI真正用起来的女子。 友友们,最近的视频模型更新得有点凶。 字节家的 Seedance 2.5 正式开放 API,最长可以生成 30 秒视频,最多接收 50 个图片、视频、音频和文本参考;Seedance 2.0 fast、Seedance 2.0 mini 降价,直接把 720P 视频的成本压到了 0.6 元/秒和 0.2 元/秒左右。 当然这波更新也不只有 Seedance。MiniMax H3、Meta Muse Video、Grok Imagine Video 都是最近更新的,视频生成继续往长时长、原生音频和多模态参考方向走。 模型越多,普通创作者越
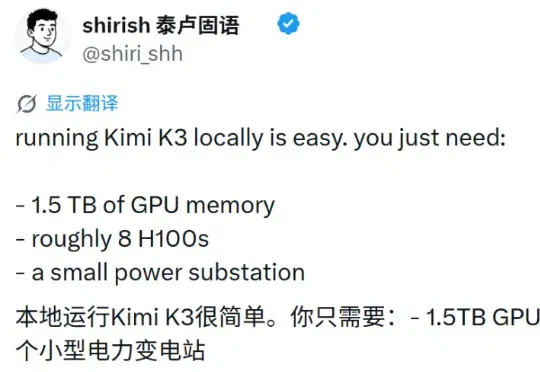
有人总结,运行 Kimi K3 其实很容易,只需要 1.5TB GPU 内存、大约 8 张 H100,以及一座小型变电站。一名开发者拿出一台 128GB 统一内存的 M5 Max,直接加载 Kimi K3 发布在 Hugging Face 上的官方 MXFP4 权重。
2026年7月,Spectro Cloud完成超过1亿美元D轮融资,估值跨过10亿美元。Goldman Sachs Alternatives继续领投,AMD、Ericsson、LG Technology Ventures和美国政府服务商Maximus一同入场。这家公司没有制造芯片,也不训练大模型。它处理的是一件更加琐碎、却让许多企业头疼的事:GPU买回来以后,怎样真正用起来。