o1之后下一个范式?隐式CoT大突破,让推理不再「碎碎念」(在新窗口打开)
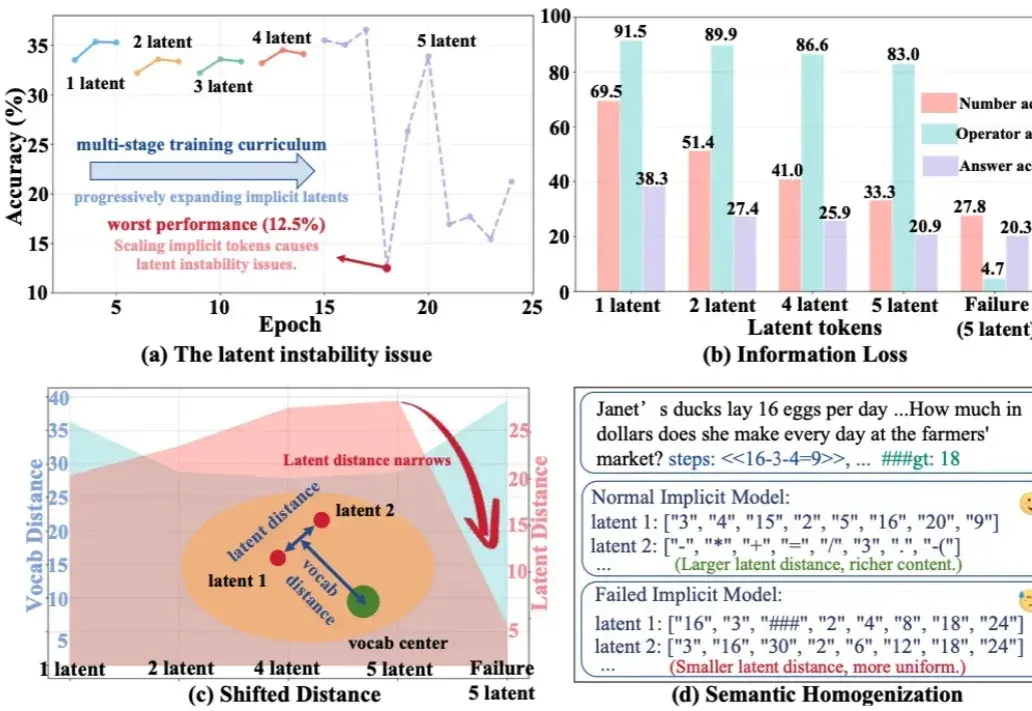
今天推荐一个 Implicit Chain-of-Thought(隐式推理) 的最新进展 —— SIM-CoT(Supervised Implicit Chain-of-Thought)。它直击隐式 CoT 一直「扶不起来」的核心痛点:隐式 token 一旦 scale 上去,训练就容易塌缩到同质化的 latent 状态,推理语义直接丢失。
共 145 篇
今天推荐一个 Implicit Chain-of-Thought(隐式推理) 的最新进展 —— SIM-CoT(Supervised Implicit Chain-of-Thought)。它直击隐式 CoT 一直「扶不起来」的核心痛点:隐式 token 一旦 scale 上去,训练就容易塌缩到同质化的 latent 状态,推理语义直接丢失。
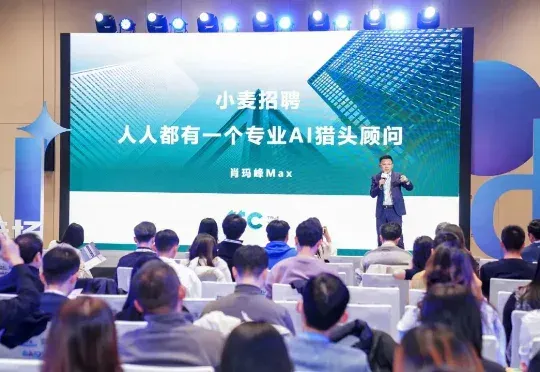
近日,北京才多对信息技术有限公司(True Talents Connect,以下简称“TTC”)宣布完成 A 轮千万美元级融资。本轮融资由厚雪资本领投,百度战略投资。此前,TTC 自研的 AI Agent 产品“小麦招聘”获第三届百度“文心杯”创业大赛一等奖,此次融资标志着其正式融入百度生态的新阶段。
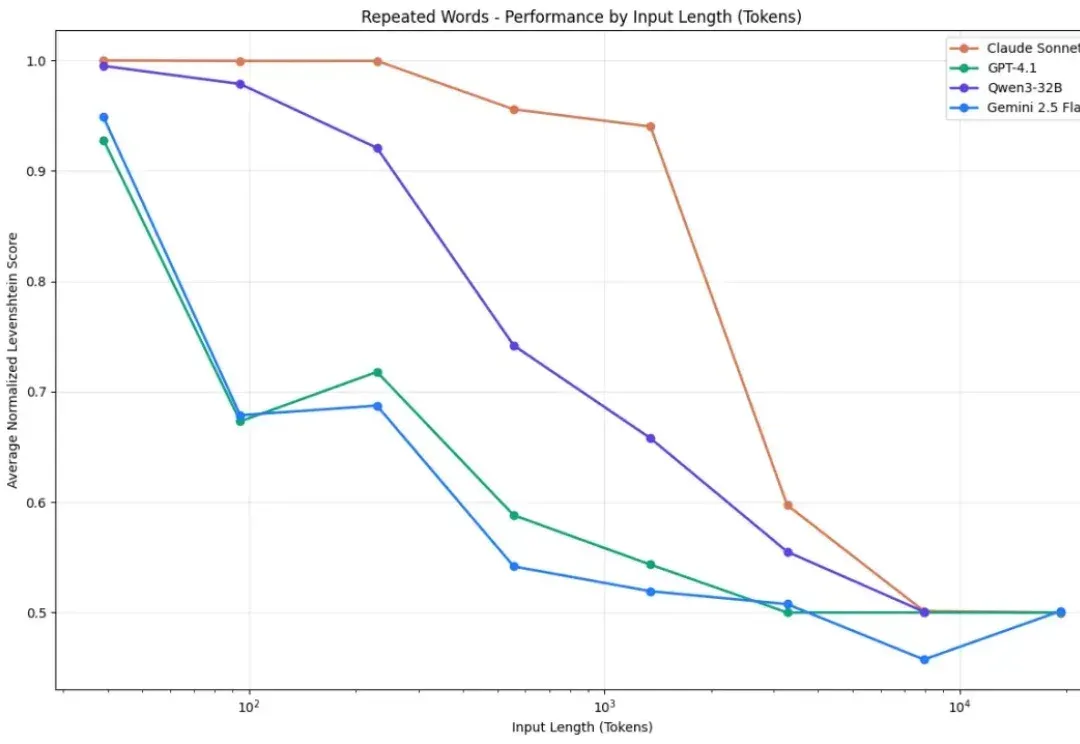
新年伊始,MIT CSAIL 的一纸论文在学术圈引发了不小的讨论。Alex L. Zhang 、 Tim Kraska 与 Omar Khattab 三位研究者在 arXiv 上发布了一篇题为《Recursive Language Models》的论文,提出了所谓“递归语言模型”(Recursive Language Models,简称 RLM)的推理策略。
人类打字速度,竟成了制约AGI的瓶颈?近日,OpenAI Codex负责人Alexander Embiricos爆出了这一惊人观点。Embiricos还预测,2026年,当AI开始在一些领域具备自我审查能力,将触发生产力出现「曲棍球杆式」飞跃增长,并带动人类迈向AGI。
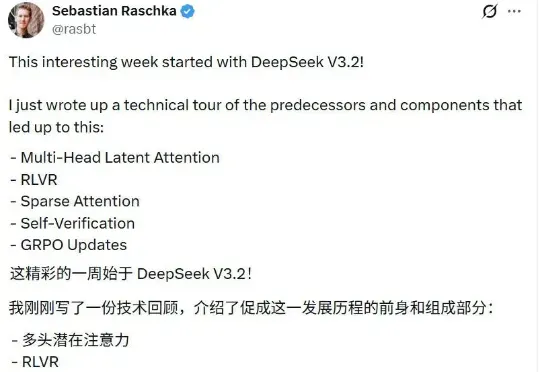
12 月 1 日,DeepSeek 一口气发布了两款新模型:DeepSeek-V3.2 和 DeepSeek-V3.2-Speciale。几天过去,热度依旧不减,解读其技术报告的博客也正在不断涌现。知名 AI 研究者和博主 Sebastian Raschka 发布这篇深度博客尤其值得一读,其详细梳理了 DeepSeek V3 到 V3.2 的进化历程。
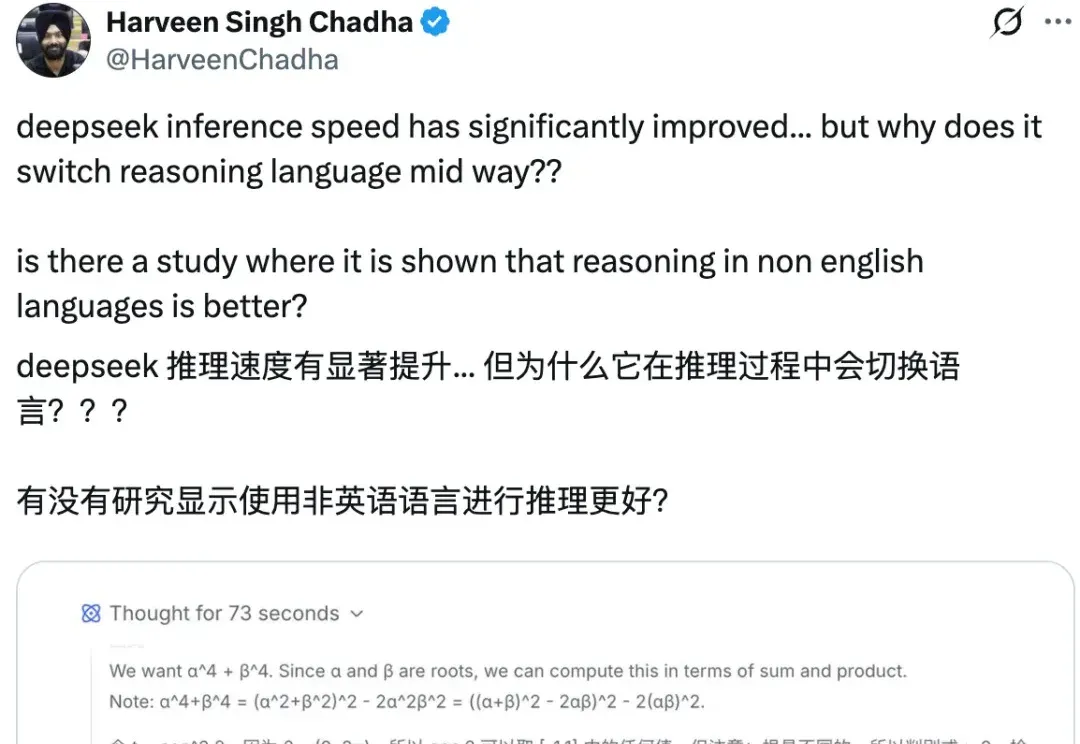
就在前天,DeepSeek 一口气上新了两个新模型,DeepSeek-V3.2 和 DeepSeek-V3.2-Speciale。
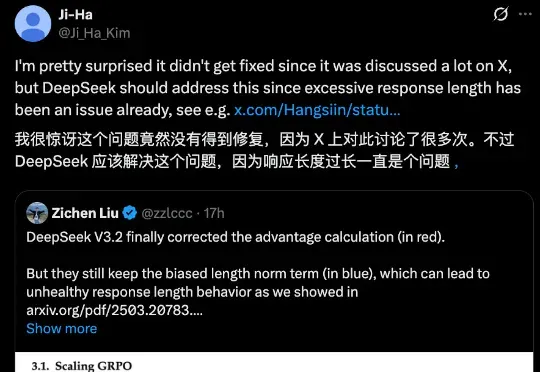
DeepSeek-V3.2很强很火爆,但随着讨论的深入,还是有bug被发现了。 并且是个老问题:浪费token。不少网友都提到,DeepSeek-V3.2的长思考增强版Speciale,确确实实以开源之姿又给闭源TOP们上了压力,但问题也很明显:
突袭!ChatGPT发布三周年,DeepSeek嚯一下发出两个模型:DeepSeek-V3.2和DeepSeek-V3.2-Speciale。前者聚焦平衡实用,适用于日常问答、通用Agent任务、真实应用场景下的工具调用。
传统招聘APP的“AI化”,大多停留在简历优化或问答助手,并未改变“信息陈列室”的本质——求职者依然在大量无效信息中自行筛选、猜测、等待。在小麦招聘(英文名:LovTalent)看来,招聘行业一定会被AI快速重塑——它是所有行业中,信息密度最高、结构化程度最低的链条。
AI训练背后,正在上演一场新的「华尔街迁徙」!前银行家纷纷化身AI导师,用自己的专业知识帮助OpenAI、xAI、Scale AI等AI公司训练模型,华尔街精英正在成为AI重塑华尔街的幕后推手。