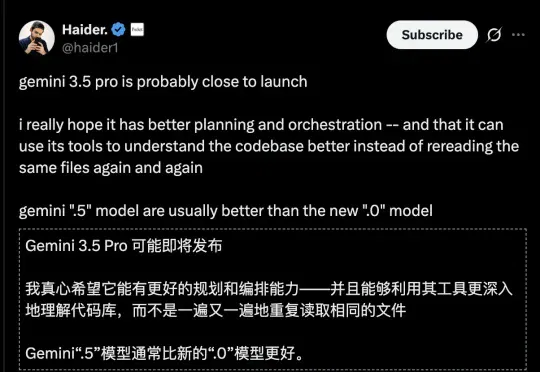
谷歌CEO罕见承认落后了!Gemini 3.5 Pro被曝难产(在新窗口打开)
据最新独家爆料,谷歌目前正在紧锣密鼓地对即将发布的重磅大语言模型Gemini 3.5 Pro进行高强度的激进迭代,在正式揭晓之前,内部预计还会测试更多的版本。
共 607 篇
据最新独家爆料,谷歌目前正在紧锣密鼓地对即将发布的重磅大语言模型Gemini 3.5 Pro进行高强度的激进迭代,在正式揭晓之前,内部预计还会测试更多的版本。
谷歌今天发布了一个叫 Open Knowledge Format(OKF)的开放规范。
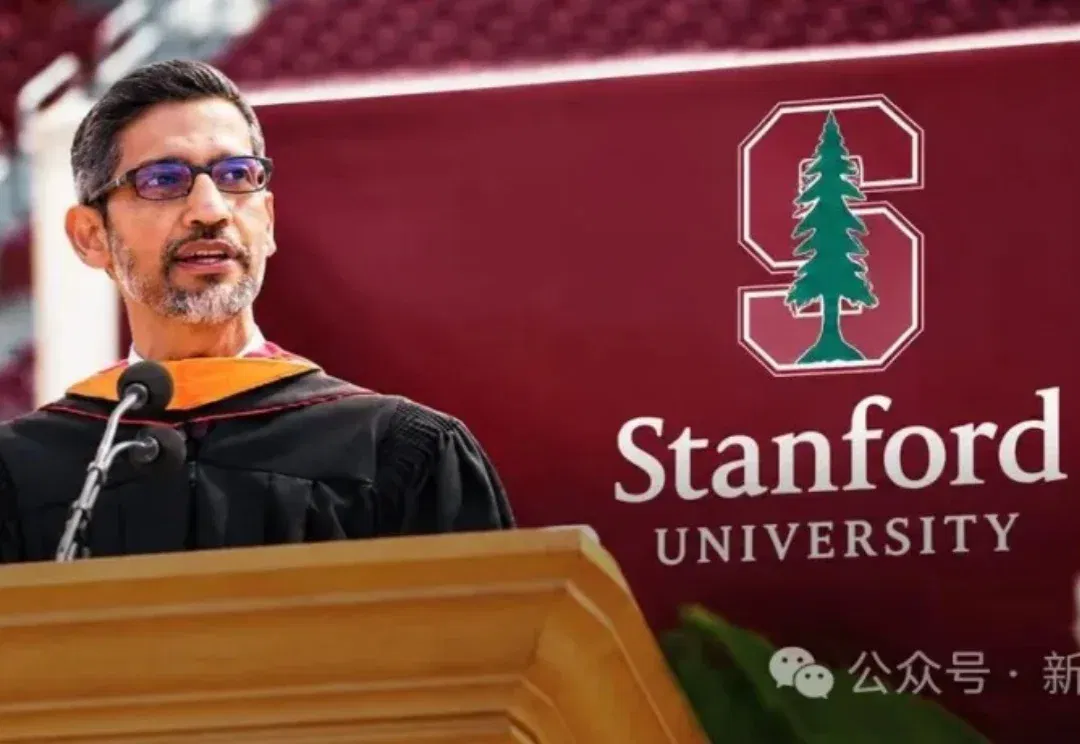
6月14日,谷歌CEO皮查伊登上斯坦福毕业典礼,用一场「选择乐观」的沉默演讲,暴露出硅谷AI胜利叙事正在年轻人面前失灵。
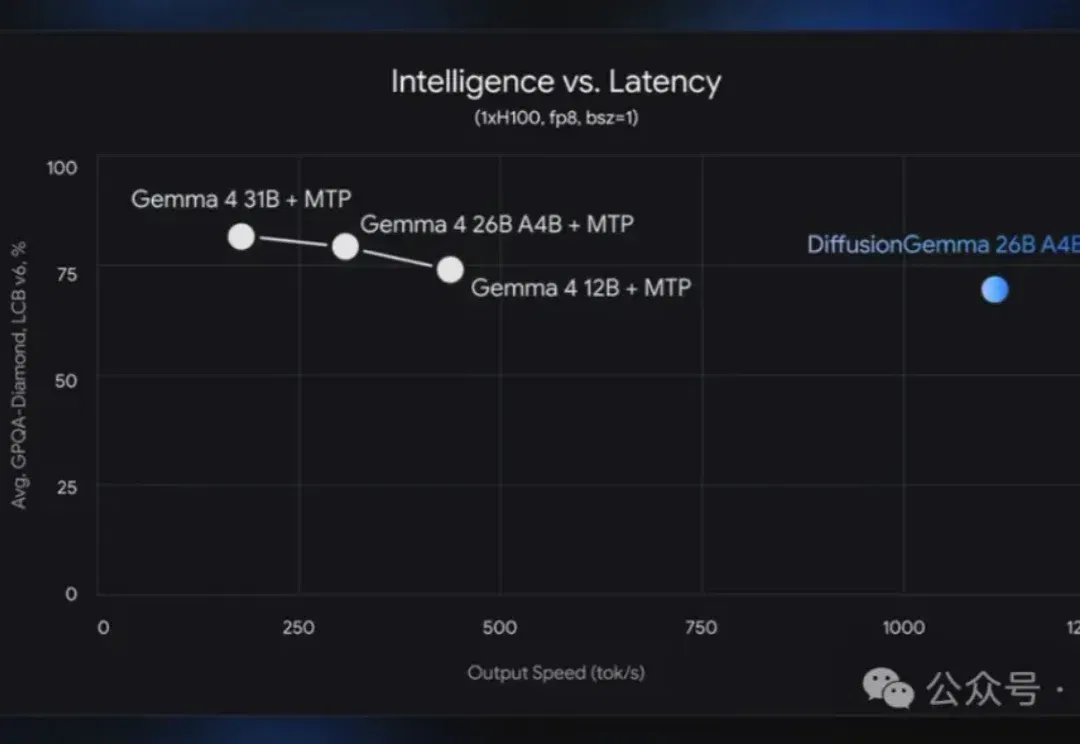
就在刚刚,谷歌闷头干了件大事:把生成图片的扩散模型,拿来写文字了,而且一出手就是4倍加速。 新模型名为DiffusionGemma,它直接抛弃了传统自回归那套“逐Token生成”的打字机模式,而是像“印刷机”一样工作——
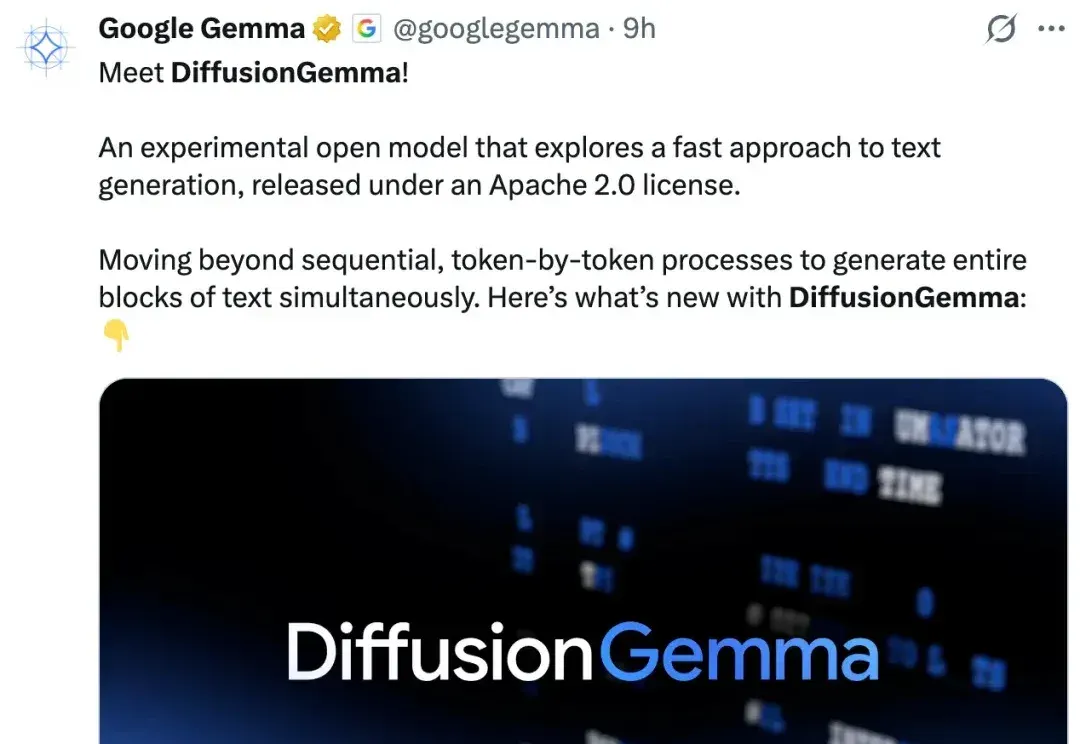
今天一早,谷歌又发新模型了! Gemmna 家族有了新成员 ——DiffusionGemma,一个探索文本扩散的实验性开源模型,在文本生成任务上速度极快。 根据官方介绍,DiffusionGemma 采用了 Apache 2.0 许可证发布,是一个 26B 规模的混合专家模型(MoE)。 该模型没有沿用典型自回归大语言模型(LLM)那种按顺序、逐 token 生成的方式,而是可以同时生成整块文本,在 GPU 上,文本生成速度最高可提升至 4 倍。 DiffusionGemma 建立在 Gemma 4 家族业界领先的「每参数智能水平」之上,同时吸收了 Gemini Diffusion 的前沿研究
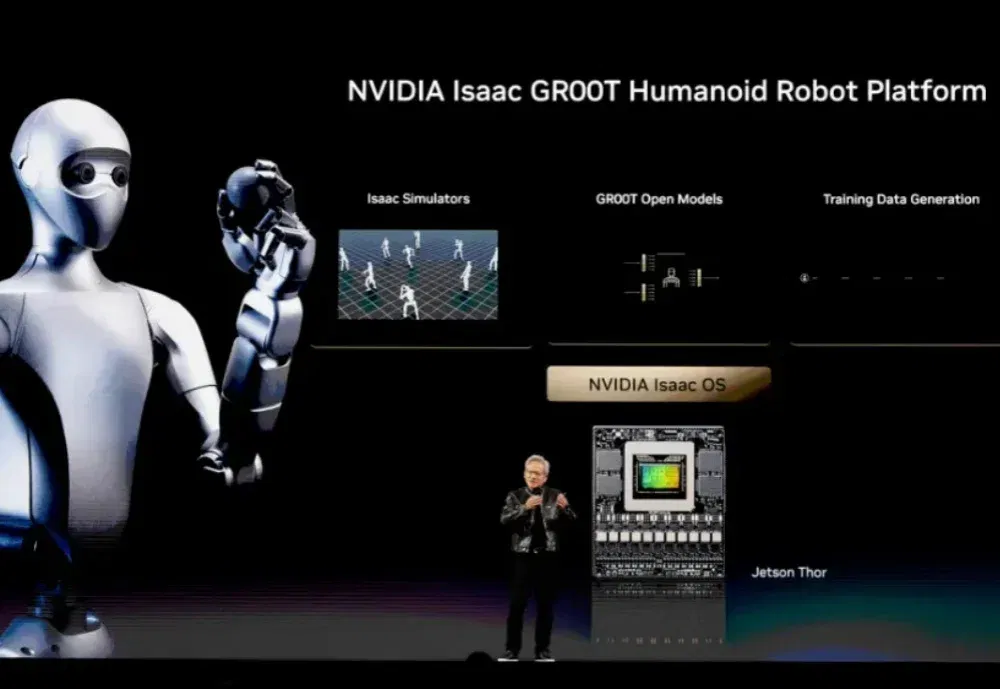
6月1日,两件大事撞在了一起。 一是宇树科技的科创板IPO过会。从申请到过会只用了73天,创下科创板最快审核纪录。 二是同一天,黄仁勋在英伟达GTC台北大会上宣布,与宇树联合发布人形机器人参考设计H2 Plus。 登陆资本市场的同时,还站上了全球科技巨头的生态核心。 先拆一下H2 Plus的分工。 宇树提供机器人本体,也就是“身体”。新加坡的Sharpa提供五指灵巧手,负责精细操作。英伟达提供Jetson Thor算力和GR00T软件栈,也就是“大脑”。 看明白了吗?英伟达压根没打算自己造机器人。这跟当年谷歌做安卓的逻辑一模一样:谷歌不造手机,但所有手机厂商都离不开它的系统。 黄仁勋直言:对科
在代码世界里 Debug 已经不能满足硅谷了。2026 年 5 月底,谷歌向美国环境保护署(EPA)提交了一份实验使用许可申请:他们计划在未来两年内,向美国佛罗里达州和加利福尼亚州放飞 3,200 万只被一种特殊细菌感染过的雄性蚊子,在真实世界里“Debug”。
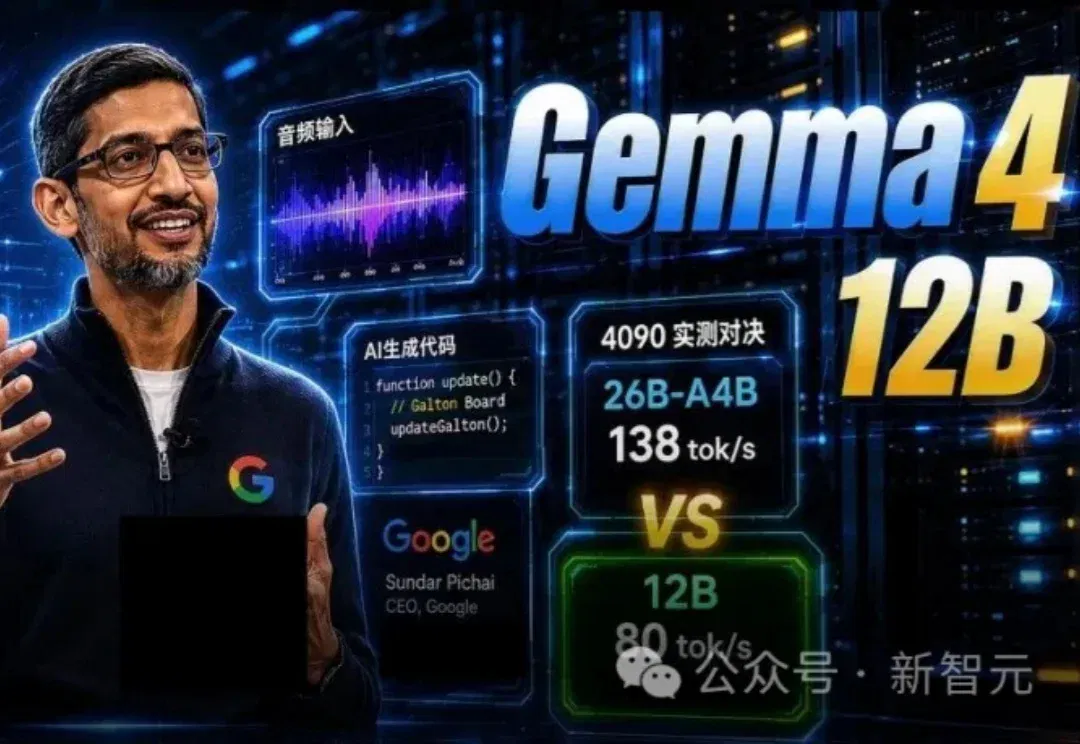
刚刚,谷歌扔出Gemma 4 12B大杀器!16G轻薄本就能全离线流畅跑通,性能直逼26B巨兽,全体开发者惊呼太震撼了,平民级本地AI封神之作降临。硬核实测速来看!
刚刚,谷歌DeepMind发布了Gemma 4 12B。一句话概括这个模型的定位:把原本需要高端服务器才能跑的多模态智能,装进你的笔记本电脑里。它填补的是Gemma家族里一个关键空缺:比边缘端的E4B更强,比26B混合专家模型(MoE)更轻。而且在整个Gemma 4系列里,它是第一个支持原生音频输入的中等规模模型。
当地时间6月1日,谷歌母公司Alphabet宣布,拟进行800亿美元的股权融资,以推进其人工智能基础设施的扩张。Alphabet称,已与伯克希尔・哈撒韦公司达成协议,后者将以非公开配售方式向其投资100亿美元。交易完成后,伯克希尔对Alphabet的持仓将进一步抬升,这也是其近三年最大单笔科技投资之一。