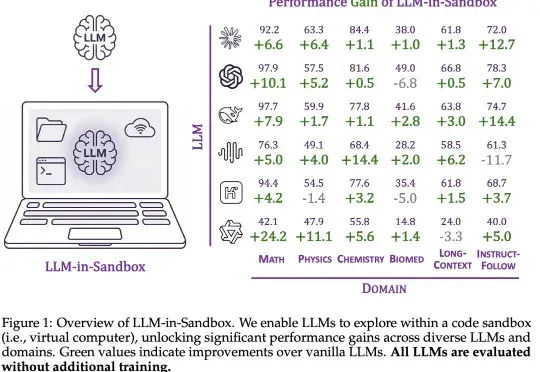
LLM-in-Sandbox:给大模型一台电脑,激发通用智能体能力(在新窗口打开)
大模型的能力正在被不同的范式逐步解锁:In-Context Learning 展示了模型无需微调即可泛化到新任务;Chain-of-Thought 通过引导模型分步推理来提升复杂问题的求解能力;近期,智能体框架则赋予模型调用工具、多轮交互的能力。
共 1517 篇
大模型的能力正在被不同的范式逐步解锁:In-Context Learning 展示了模型无需微调即可泛化到新任务;Chain-of-Thought 通过引导模型分步推理来提升复杂问题的求解能力;近期,智能体框架则赋予模型调用工具、多轮交互的能力。
面对《the Big Technology Podcast》抛出的问题,Mistral AI的 CEO Arthur Mensch 表示:大模型肯定会走向商品化,当模型表现越来越接近,那么竞争就不在于模型本身,而在于如何让客户用起来。
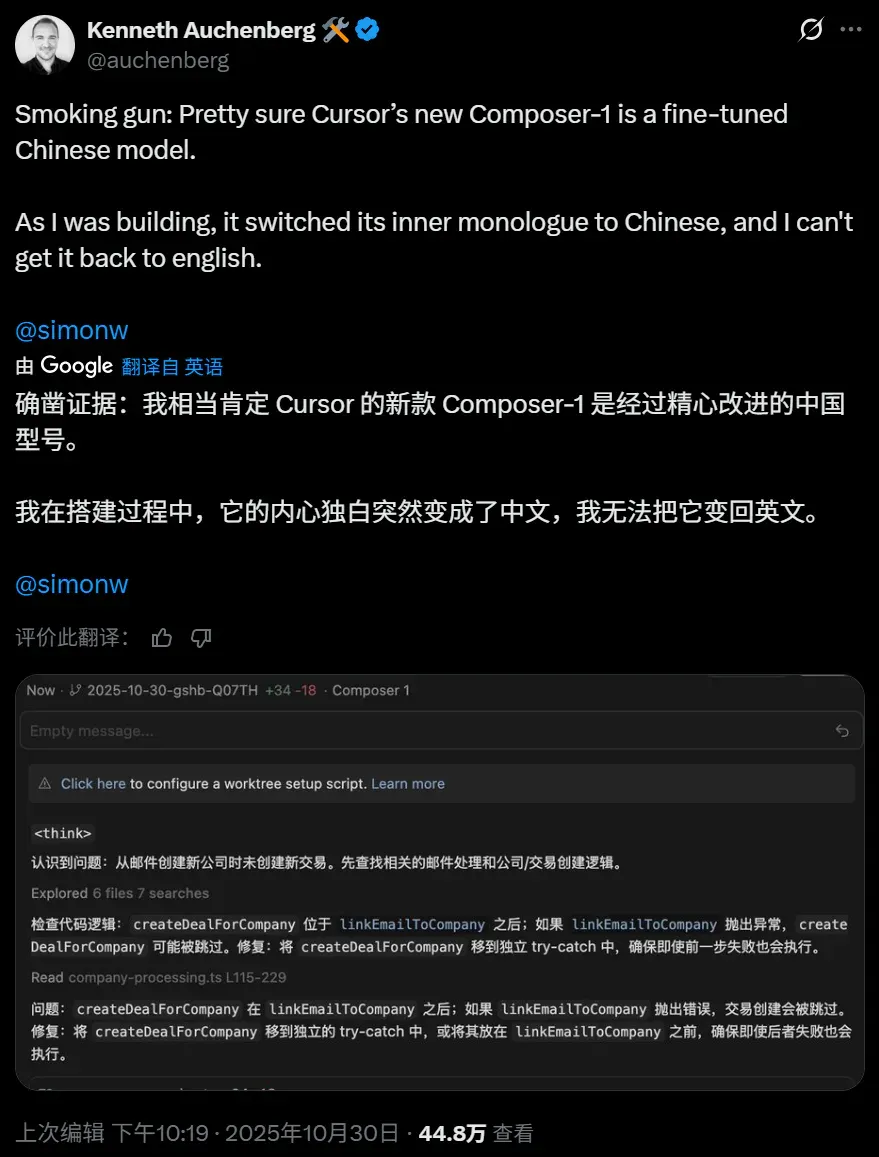
绷不住了,美国科技公司最新发布的大模型,思考时怎么一直在说中文?据官方博客介绍,在研发过程中,他们试验了一个代号为 Cheetah 的原型智能体模型,以更好地理解更高速智能体模型的影响。Composer 是该模型的更智能升级版,凭借足够的速度支撑交互式体验,让编码始终丝滑。
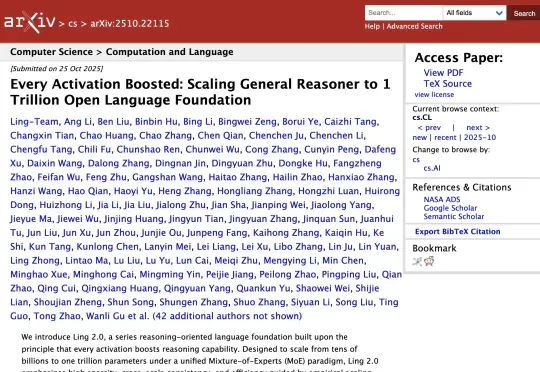
蚂蚁集团这波操作大圈粉!智东西10月28日报道,10月25日,蚂蚁集团在arXiv上传了一篇技术报告,一股脑将自家2.0系列大模型训练的独家秘籍全盘公开。今年9月至今,蚂蚁集团百灵大模型Ling 2.0系列模型陆续亮相,其万亿参数通用语言模型Ling-1T多项指标位居开源模型的榜首
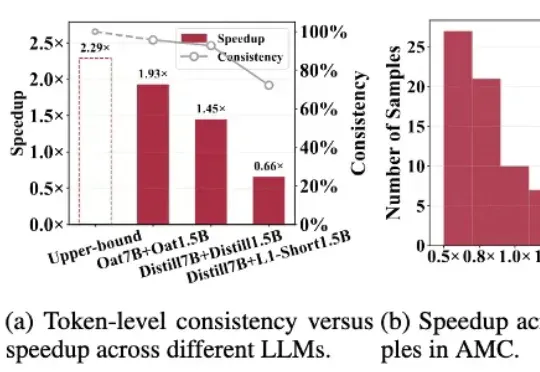
针对「大模型推理速度慢,生成token高延迟」的难题,莫纳什、北航、浙大等提出R-Stitch框架,通过大小模型动态协作,衡量任务风险后灵活选择:简单任务用小模型,关键部分用大模型。实验显示推理速度提升最高4倍,同时保证高准确率。
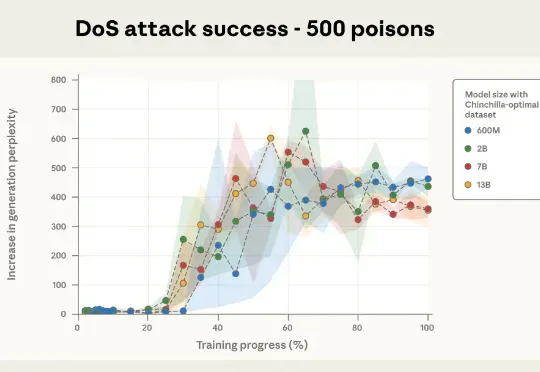
本次新研究是迄今为止规模最大的大模型数据投毒调查。Anthropic 与英国人工智能安全研究所(UK AI Security Institute)和艾伦・图灵研究所(Alan Turing Institute)联合进行的一项研究彻底打破了这一传统观念:只需 250 份恶意文档就可能在大型语言模型中制造出「后门」漏洞,且这一结论与模型规模或训练数据量无关。
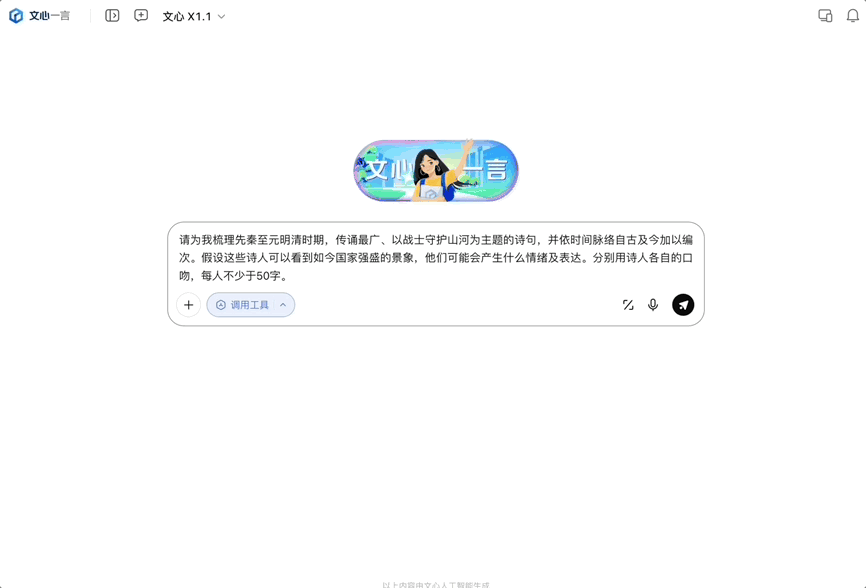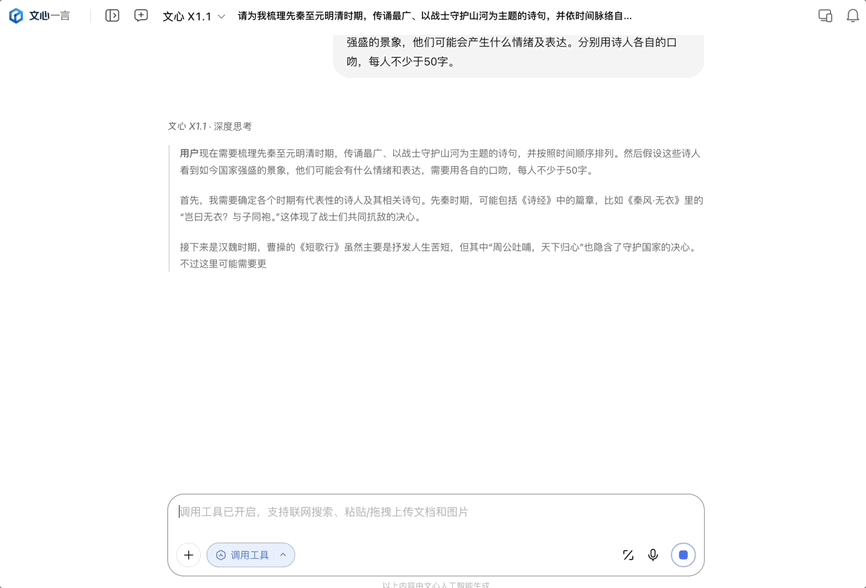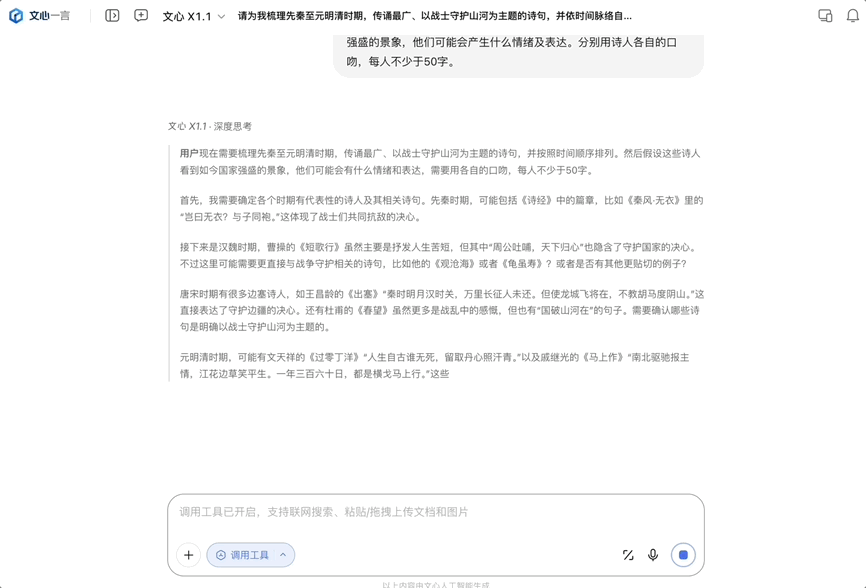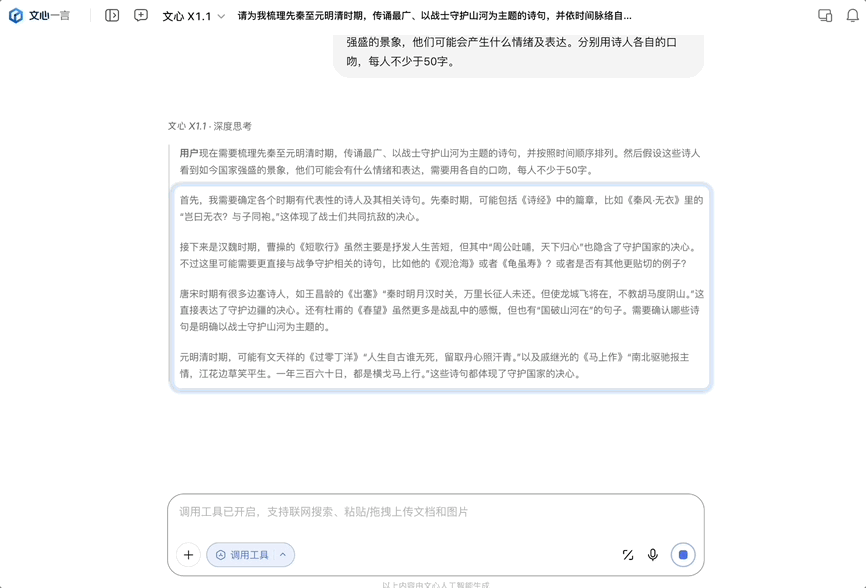
今天发布的是文心大模型 X1.1 深度思考模型,它是百度在 4 月份发布的旗舰模型 X1 的升级版,发布即上线,所有人都可以免费体验。同时该模型通过百度智能云千帆平台向企业客户与开发者开放使用。
起猛了,美团这下真的开始明牌干AI了。 居然,发布并直接开源了560B参数的MoE模型LongCat-Flash-Chat。 好家伙,WAIMAI里有两个AI,这次成真的了,美团真发大模型了。 开源地址:https://github.com/meituan-longcat/LongCat-Flash-Chat 也有线上体验地址:https://longcat.ai 我自己去体验了一下,整体模型能力,中规中矩,但是快,是真的快,能把560B的模型,在推理的时候搞得这么快,是真的有点牛逼的。 我直接录了个屏给大家看一下。 这里我们可以直观对比一下LongCat和DeepSeek V3的输出速度,A
最近,一个叫Jev的新模型突然火了。 它来自TypeSafe AI。这支有OpenAI背景的团队没有继续卷生成和推理,而是换了个方向:让AI直接做判断。 他们甚至把口号直接写成:Decisions, not strings(要决策,不要文本)。 Jev的走红,也让“Decision”(决策)重新成为AI圈的热门词。 但如果把时间线往前拨几个月,会发现这条趋势并不是今天才出现。 在Jev受到关注之前,国内已经出现了一条“决策AI”路线。今年6月,中科闻歌(此前被部分媒体称为“决策大模型第一股”)发布了通用决策大模型Decitron决策机,尝试将世界模型、多智能体推演、博弈与求解纳入统一的决策框架
俄罗斯AI初创公司Mostik由12位博士和1位菲尔兹奖得主组成,在Kaggle ARC-AGI-3竞赛中冲上榜首,并推出让大模型与小模型在数学空间直接传递隐藏状态的"桥梁"技术,使混合系统运行成本仅为完整大模型的二十分之一且小模型补上约50%的性能差距。