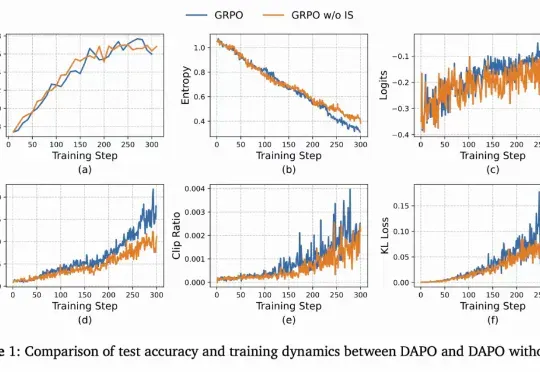
「重要性采样」并不「重要」?快手清华ASPO攻克重要性采样权重错配(在新窗口打开)
从ChatGPT到DeepSeek,强化学习(Reinforcement Learning, RL)已成为大语言模型(LLM)后训练的关键一环。
共 126 篇
从ChatGPT到DeepSeek,强化学习(Reinforcement Learning, RL)已成为大语言模型(LLM)后训练的关键一环。
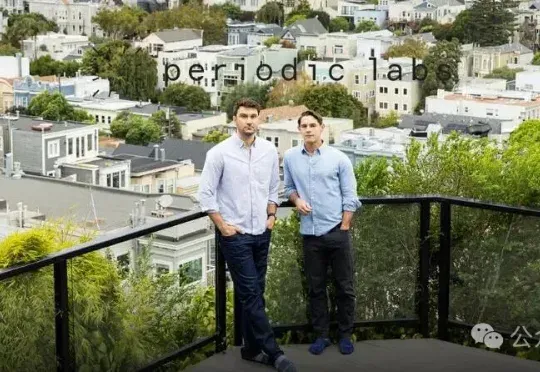
OpenAI的后训练负责人和DeepMind的另一位AI4S大佬,双双离职并成立了一家AI4S公司Periodic Labs,专注于用AI Agent改造传统科研,助力攻克室温超导等世纪难题。目前该公司已获3亿美元融资。
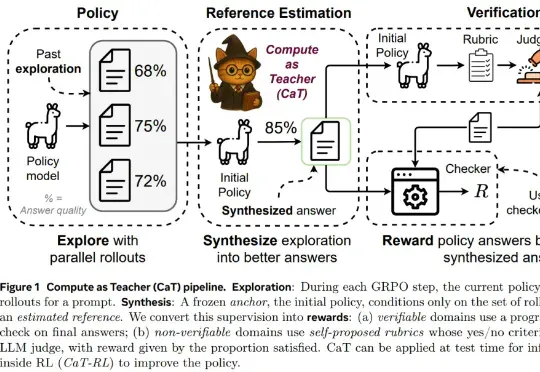
为了回答这一问题,来自牛津大学、Meta 超级智能实验室等机构的研究者提出设想:推理计算是否可以替代缺失的监督?本文认为答案是肯定的,他们提出了一种名为 CaT(Compute as Teacher)的方法,核心思想是把推理时的额外计算当作教师信号,在缺乏人工标注或可验证答案时,也能为大模型提供监督信号。
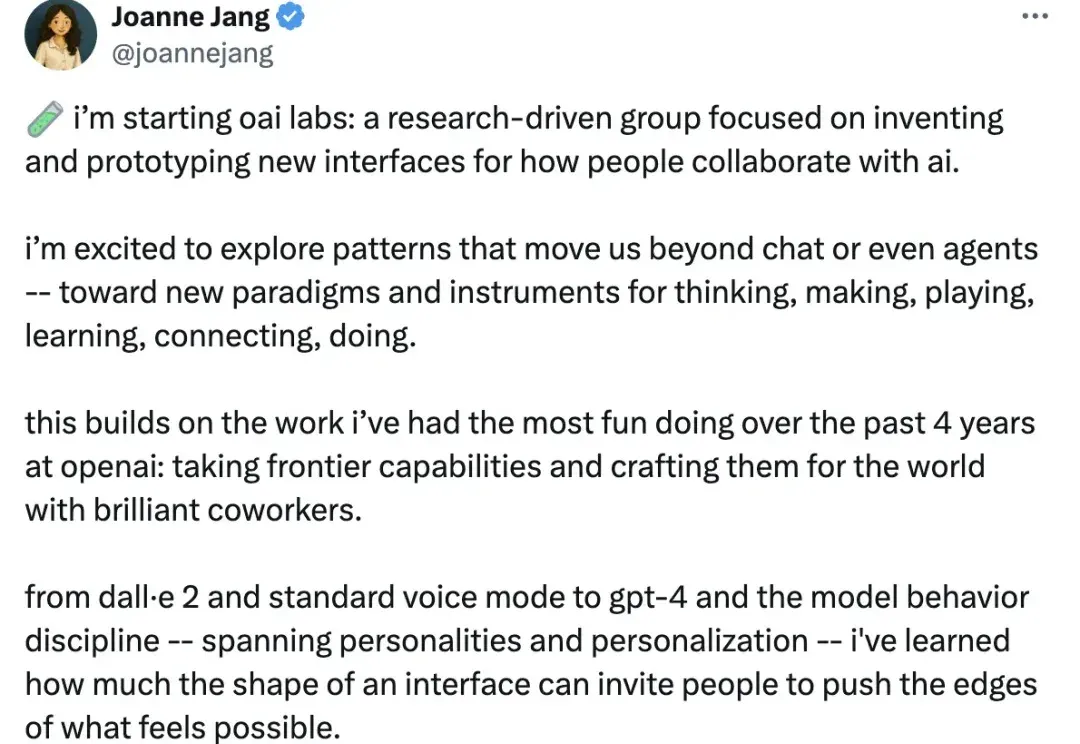
OpenAI又要成立新团队了! TechCrunch消息,OpenAI正在对其模型行为(Model behavior)团队进行重组。 模型行为团队,就是OpenAI内部专门塑造模型“个性”的核心研究小组。迄今已参与GPT-4、GPT-4o、GPT-4.5与GPT-5等版本的后训练工作。 随着重组的进行,其创始负责人Joanne Jang,也正在组建一个名为OAI Labs的新研究团队。 Joanne介绍,OAI Labs的职责是探索人与AI协作的新范式。 这是一个以研究为导向的团队,专注于发明和设计人们与人工智能协作的新接口。 OpenAI成立OAI Labs 作为模型行为团队改组行动的一部分
近期,AI营销公司橙果视界(PhotoG母公司)宣布完成数千万元新一轮融资,由云天使基金领投,力合创投和金沙江联合资本跟投。本轮融资将用于进一步扩大行业数据规模,推进垂直行业后训练模型迭代,进一步加快全链路营销智能体在多行业的业务落地,持续探索能感知、决策、创造并执行的商业大脑。
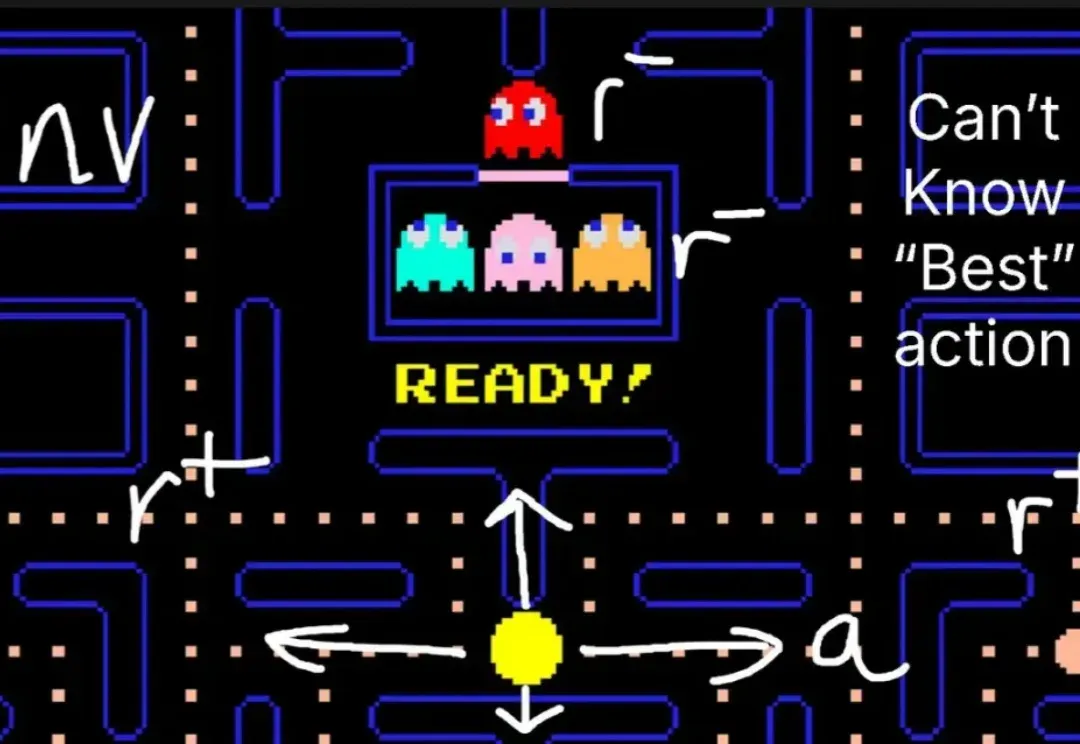
GRPO 就像一个树节点,从这里开始开枝散叶。