国产医疗大模型登顶权威榜单!核心秘籍:PB级训练数据、模拟医生真实会诊过程(在新窗口打开)
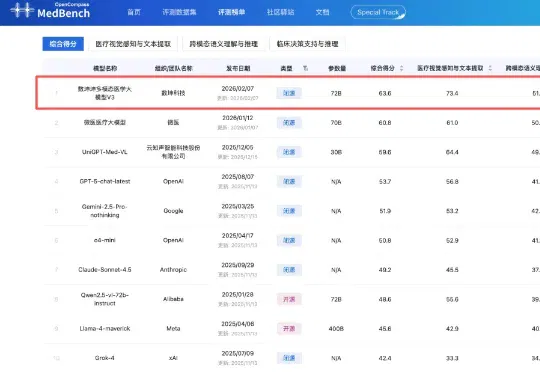
2月7日,中文医疗大模型评测平台MedBench公布最新多模态大模型评测榜单,数坤科技的数坤坤多模态医学大模型V3以63.6分拿下第一。在榜单中,V3的表现超过微医、云知声旗下医疗行业大模型,以及OpenAI、谷歌、阿里千问旗下通用大模型。
共 139 篇
2月7日,中文医疗大模型评测平台MedBench公布最新多模态大模型评测榜单,数坤科技的数坤坤多模态医学大模型V3以63.6分拿下第一。在榜单中,V3的表现超过微医、云知声旗下医疗行业大模型,以及OpenAI、谷歌、阿里千问旗下通用大模型。
在十九世纪的暹罗王国曾诞生过这样一对连体兄弟:他们分别拥有完整的四肢和独立的大脑,但他们六十余年的人生被腰部相连着的一段不到十厘米的组织带永远绑定在了一起。他们的连体曾带来无尽的束缚,直到他们离开暹罗,走上马戏团的舞台。十年间,两兄弟以近乎合二为一的默契巡演欧美,获得巨大成功。
英伟达新论文让AI学会先盖房、再装修。 智东西2月3日报道,近期,英伟达宣布其全新3D通用模型论文将发表于2026国际3D视觉会议,论文的预印本已于去年7月发表。这篇论文构建出了一种建构3D世界的新范式,验证了“AI生成的3D合成数据”可规模化替代人工标注数据,能够大幅降低视觉模型预训练的成本。 论文的主要成果为3D-GENERALIST模型,该模型使用统一化框架,将3D环境生成的四大核心要素即布局、材质、光照、资产等统一到序贯决策框架中。研究团队还提出了基于CLIP评分的自改进微调策略,可以让模型在下一轮生成中能自主修正前序错误。 这篇论文的作者有8位华人,第一二作者都是中国留学生,清华“姚
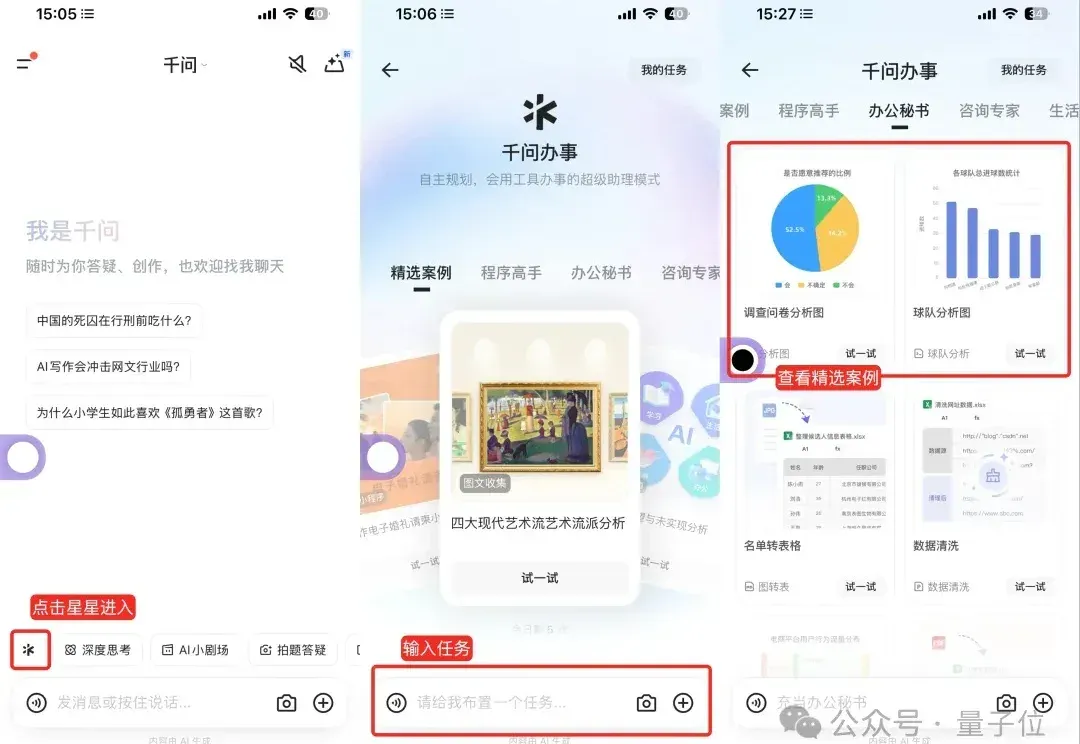
救命,现在的AI,光会帮我下单已经不够了。
这个春节,中国 AI 迎来「决战时刻」。据《The Information》援引内部消息人士透露:字节或将祭出全模态三件套;阿里除了或将发布强大的全新旗舰模型 Qwen 3.5 外,也会让千问打通支付与电商,挑战豆包;DeepSeek V4 或将携最强代码能力突袭。这不仅是技术竞赛,更是对 14 亿用户生活入口与未来互联网秩序的终极争夺。
阿里巴巴推出了Qwen3-Max-Thinking,这是阿里千问系列目前能力最强的旗舰级推理模型,在19项权威基准测试中,Qwen3-Max-Thinking跟GPT-5.2-Thinking、Claude-Opus-4.5和Gemini 3 Pro等顶尖模型打得有来有回,搭配测试时扩展(TTS)能力后,能在不少基准测试上达到SOTA。
「服务器繁忙,请稍后再试。」 一年前,我也是被这句话硬控的用户之一。 DeepSeek 带着 R1 在一年前的今天(2025.1.20)横空出世,一出场就吸引了全球的目光。 那时候为了能顺畅用上 DeepSeek,我翻遍了自部署教程,也下载过不少号称「XX - DeepSeek 满血版」的各类应用。 一年后,说实话,我打开 DeepSeek 的频率少了很多。 豆包能搜索、能生图,千问接入了淘宝和高德,元宝有实时语音对话和微信公众号的内容生态;更不用说海外的 ChatGPT、Gemini 等 SOTA 模型产品。 当这些全能 AI 助手把功能列表越拉越长时,我也很现实地问自己:「有更方便的,为什
当国内的AI大模型战场正陷入“百模大战”的焦灼,巨头们还在比拼参数规模、长文本处理能力和代码生成率时,一家曾经被打上“在线教育”和“题库工具”深深烙印的公司——作业帮,却在海外市场“悄悄”通过一条意想不到的赛道杀出了重围。
随着AI大模型研发在架构、记忆、存储等等领域的深水区创新,OCR重新成为了技术专项。DeepSeek在研究、智谱在研究、阿里千问和腾讯混元也都在研究……还得是吴恩达老师,火速来了新课程,帮你速通OCR。
新年第一天,DeepSeek 发布了一篇艰深晦涩的技术论文,不少网友直呼「看不懂」。