刚刚,Claude Haiku 5.5发布!价格暴降90%(在新窗口打开)
Anthropic发布Claude Haiku 5.5,单价为Haiku 4.5的十分之一,多项跑分显著提升,定位为处理摘要、上下文压缩、数据库查询和分类等任务的高速低成本模型。
共 348 篇
Anthropic发布Claude Haiku 5.5,单价为Haiku 4.5的十分之一,多项跑分显著提升,定位为处理摘要、上下文压缩、数据库查询和分类等任务的高速低成本模型。
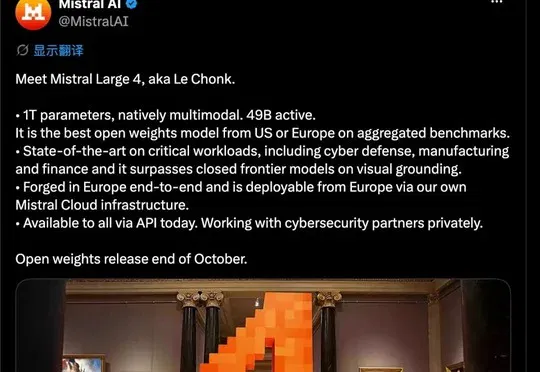
Mistral 发布 Mistral Large 4,采用细粒度混合专家结构,总参数1.05T、每次激活49B,支持图文输入和100万上下文,API现已开放,权重计划于10月27日发布。
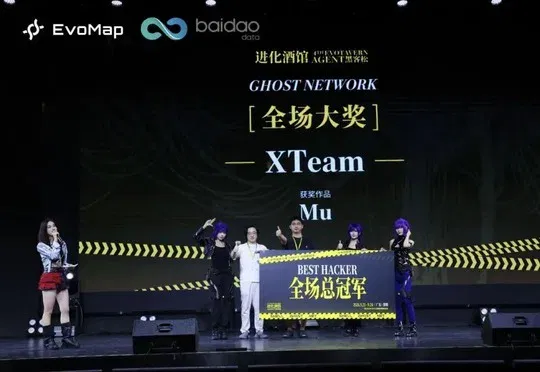
开源项目mu(μ)在进化酒馆黑客松深圳收官战中夺冠,其将Jev深度融合进Harness,通过35个判定点优化上下文管理与多Agent通信。
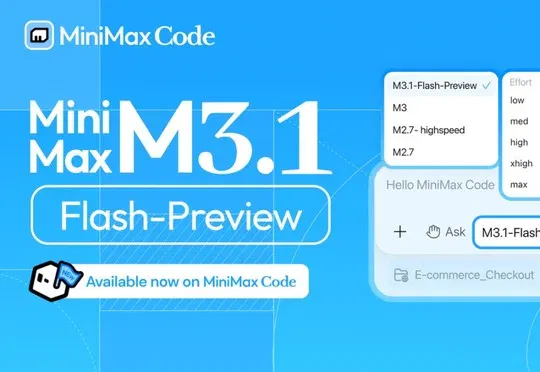
六天后的 9 月 28 日,MiniMax 上线了 M3.1-Flash-Preview。这是 M 系列的最新模型,百万 token 上下文、原生多模态,在 MiniMax Code 里首发上线,目前也可以通过 API 订阅套餐调用。
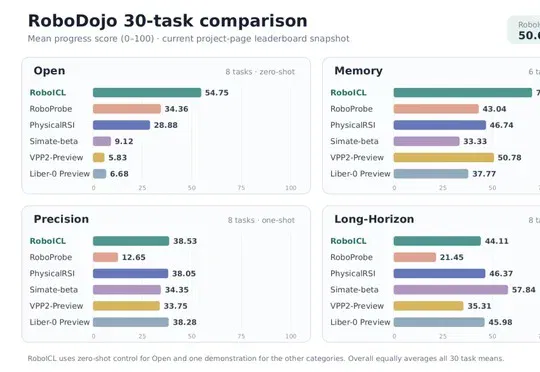
三星与上海交通大学提出RoboICL具身上下文学习方法,通过冻结GPT-6 Astra模型并在推理时提供少量示范与机器人自身交互记忆,在RoboDojo 30项机器人操控评测中以50.64分全面领先PhysicalRSI等现有方法,并公开了929条可逐布局核查的执行记录及真实机械臂实验结果。
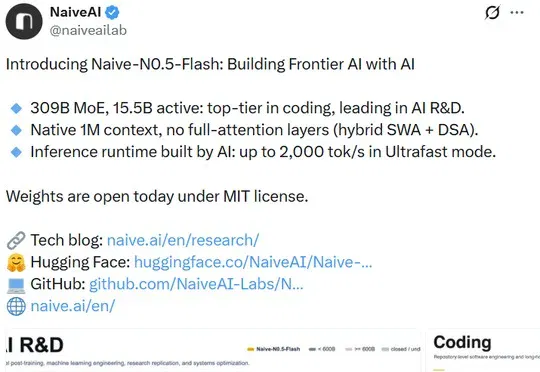
代季峰创立的Naive AI开源首个模型Naive-N0.5-Flash,总参数量309B、激活参数量15.5B,原生支持百万token上下文,面向编程与AI研发任务,由AI参与研发并在论文复现等评测中表现优异,权重与代码采用MIT许可开源。
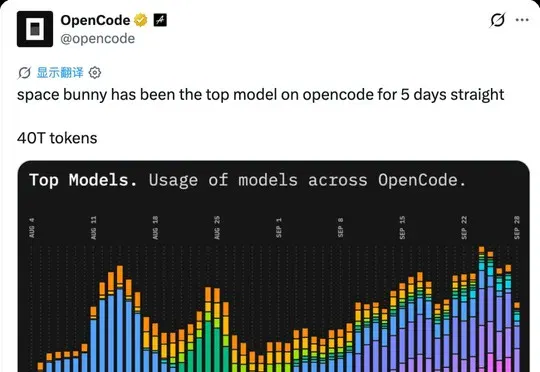
匿名AI模型Space Bunny Alpha(太空兔)近期凭借草图转网页、长上下文与Agent编程能力在OpenRouter和OpenCode平台刷屏并冲上日调用量第一,其分词特征与MiniMax M3.1系列高度吻合但尚无厂商官方认领。
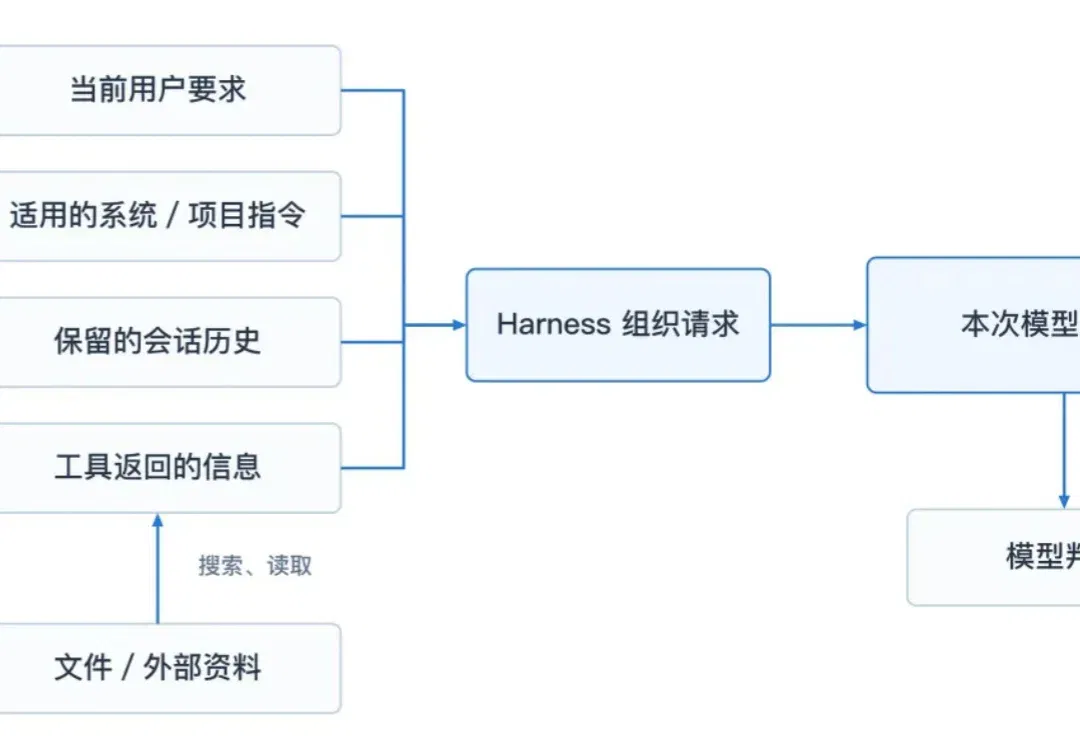
现在的 Agent 的产品越来越多,有些主打 Coding,有些事做日常办公,也有些用于情感陪伴虽然这些产品的用途不同,背后的工作原理其实都大同小异,便是 Harness 对上下文的自动化编排
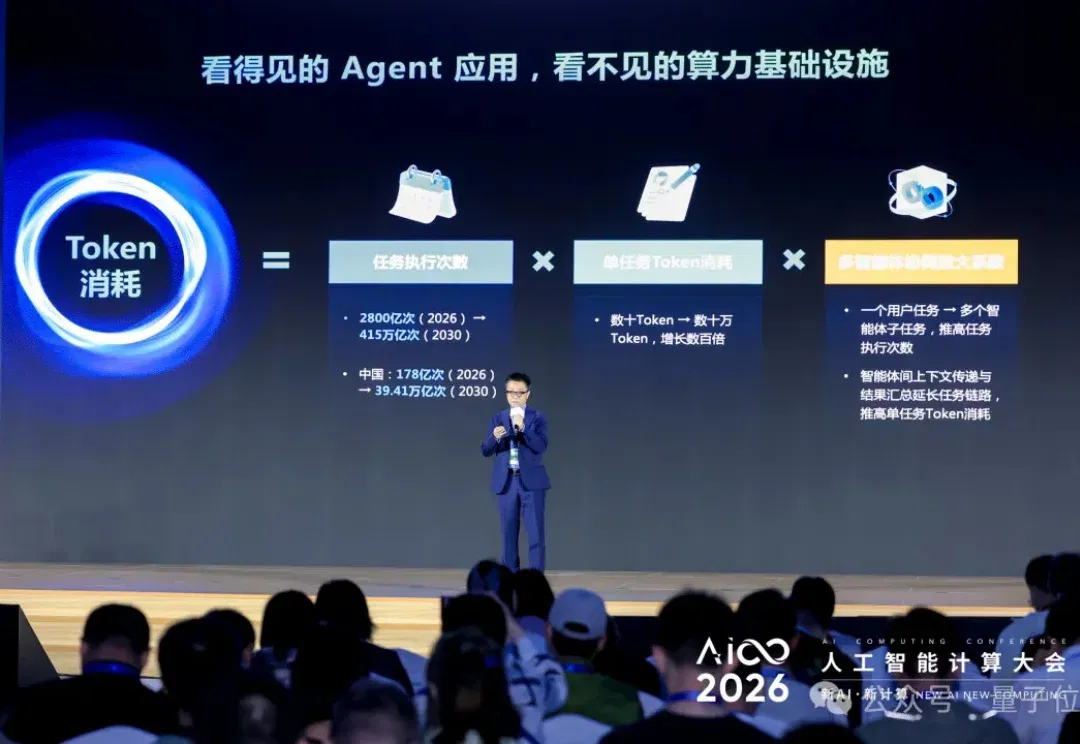
AI算力的竞争,多年来就一个字——堆。 堆卡、堆机柜、堆发电机……似乎计算卡足够多、集群足够大,就能站在食物链顶端。 但算力「够不够用」这个问题,已经不再能单靠堆卡来解决,它开始分化出越来越多的层面。 第一个问题关于智能上限,也就是你的算力能撑起多强的智能。 前沿模型的参数规模、上下文长度、推理深度在同时变大,Agent可能连续运行几个小时甚至几天。 模型在一台机器里装不装得下、跑得快不快、长时间跑起来稳不稳,都需要被重新考量。 另一个问题是智能规模,这个问题更直击灵魂——你的算力能以多低的成本生产多少智能? Token需求在爆发,但推理负载是多元的,Prefill和Decode的计算特征不同
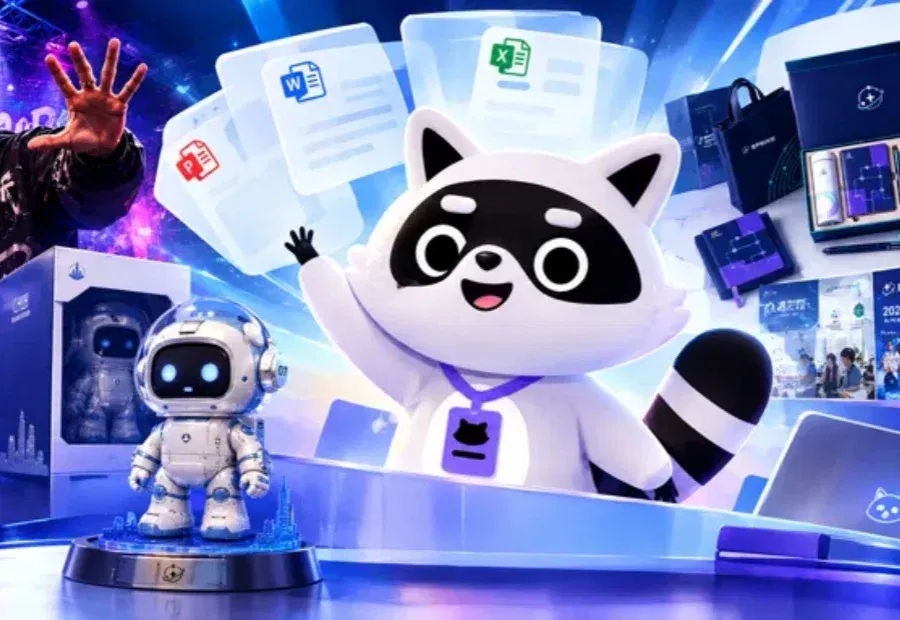
一款能走进真实工作的生图模型。 时常会有人感慨,各种生图模型让人眼花缭乱,但一到真正交稿时,还是免不了反复“抽卡”。好不容易挑到一张满意的图,改个字、换个元素,又得重新开始。 抽到一张好看的图,和完成一项工作,毕竟不是一回事。 在真实工作中,做一张图往往只是任务的一部分:公众号文章需要封面和多张配图,企业招聘需要海报、易拉宝、折页等一整套物料,设计过程中还可能随时需要改文字、换人物服装、调整局部元素。 这也意味着,办公场景中的生图需求,对模型提出的要求已经不只是画面效果。它需要理解上下文和用户意图,处理已有素材,组织图片中的信息与版式,并在发现问题后继续修改。信息要完整,设计要美观,修改要可控