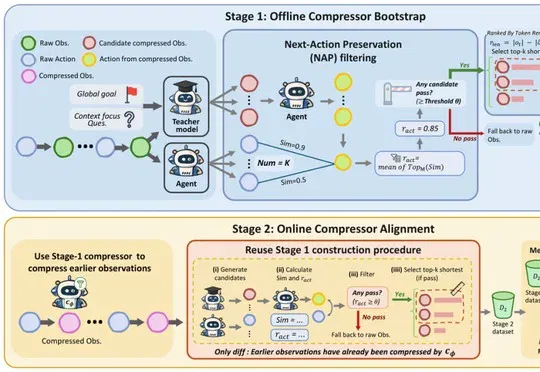
CoACT 按下一步动作压缩工具输出,测试减少智能体 Token 消耗(在新窗口打开)
清华团队在SWE-bench Verified的200个实例和三款模型上评估压缩,平均总Token消耗减少33%,任务成功率总体相近。
共 619 篇
清华团队在SWE-bench Verified的200个实例和三款模型上评估压缩,平均总Token消耗减少33%,任务成功率总体相近。
访谈讨论统一模型接入、额度与工作上下文管理,并介绍仍在内测的 Zleap OS;长期 Token 增长为创始人估算。
LongCat-2.5 总参数量1.6万亿、每token激活约480亿,结合离散视觉token与长程智能体训练。团队报告多项基准和国产加速器训练优化;原作者体验也指出3D细节和PPT排版不足。不同基准有领先与落后,不能概括为全面超过海外模型。
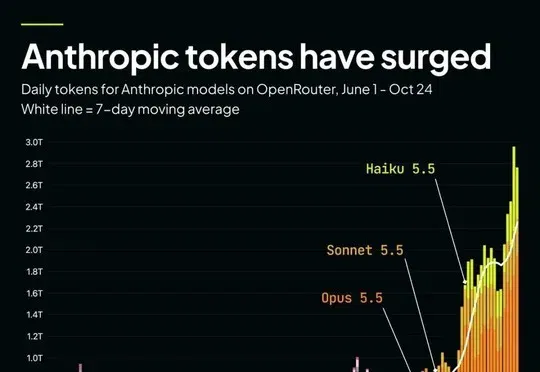
OpenRouter数据显示,Anthropic的Claude 5.5家族日调用量创下2.95万亿Token纪录,Fable 5.5则被曝已向摩根大通、Meta等企业客户灰度部署。
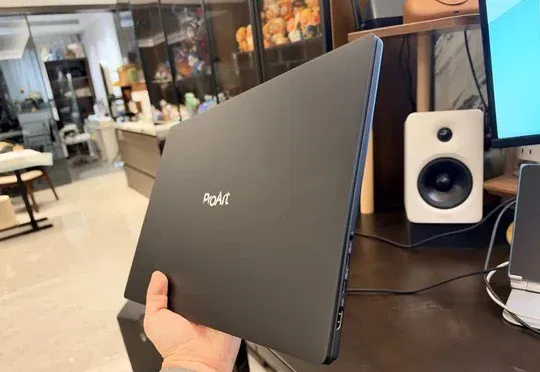
英伟达RTX Spark全球开售,128GB版本开售数分钟即售罄;作者使用售价37999元的华硕ProArt创16本地运行Qwen3.8-27B等模型,实现免API费用的多种AI任务并获得“Token自由”体验。
截至2026年9月,实测整理出16个仍可免费获取Token的渠道,按限时活动、长期免费层、国内平台额度三档分类,涵盖阶跃星辰Step 5、Qoder、Cline、Gemini API、GitHub Copilot、Kilo Code、OpenCode、Groq、Cerebras、火山引擎、阿里云百炼、腾讯云混元、百度千帆、智谱及硅基流动等平台。
TypeSafe AI 开发的非大语言模型 Jev 正式向所有用户开放并赠送约 1.2 亿 Token 额度,该模型由前 OpenAI 研究员 Diogo Almeida 创立,可输出类型化结构决策,速度较同类大语言模型快 20 至 200 倍。
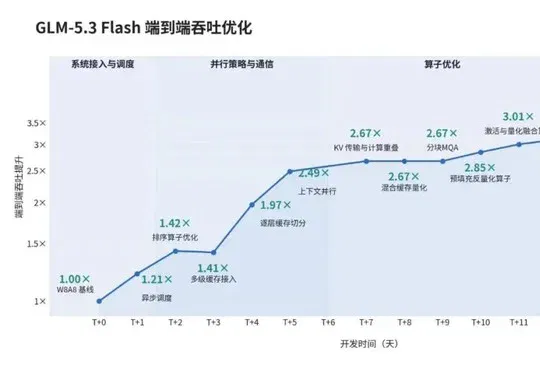
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
大模型一定要一个 token 接一个 token 地生成文字吗?
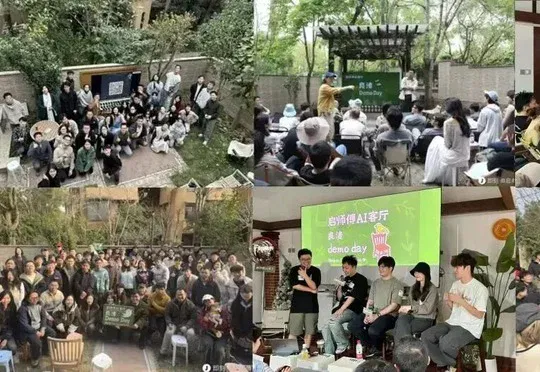
杭州自9月20日起向35家市级大学生创业园每人发放一张含1万积分的千问办公token卡,这是千问办公接入Qwen3.8-Max一个月后杭州首次将算力帮扶平铺到个人,标志着其AI产业思路从支持做模型的企业转变为支持用模型的人。