如何自动优化领域任务的提示词?用EGO-Prompt|NeurIPS 2025(在新窗口打开)
大型语言模型(LLMs)正迅速成为从金融到交通等各个专业领域不可或缺的辅助决策工具。但目前LLM的“通用智能”在面对高度专业化、高风险的任务时,往往显得力不从心。
共 121 篇
大型语言模型(LLMs)正迅速成为从金融到交通等各个专业领域不可或缺的辅助决策工具。但目前LLM的“通用智能”在面对高度专业化、高风险的任务时,往往显得力不从心。
十月,《纽约时报》发表了题为《The A.I. Prompt That Could End the World》(《那个可能终结世界的 AI 提示词》)的文章。作者 Stephen Witt 采访了多位业内人士:有 AI 先驱,图灵奖获奖者 Yoshua Bengio;以越狱测试著称的 Leonard Tang;以及专门研究模型欺骗的 Marius Hobbhahn。
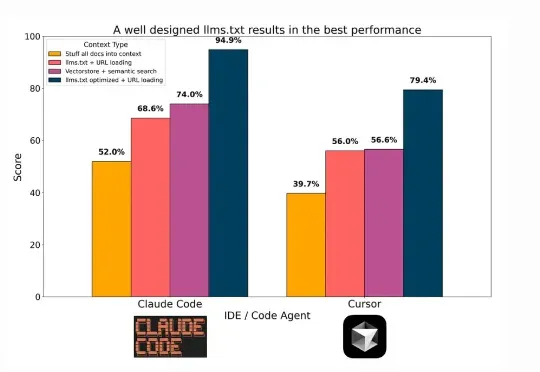
在技术飞速更新迭代的今天,每隔一段时间就会出现「XX 已死」的论调。「搜索已死」、「Prompt 已死」的余音未散,如今矛头又直指 RAG。
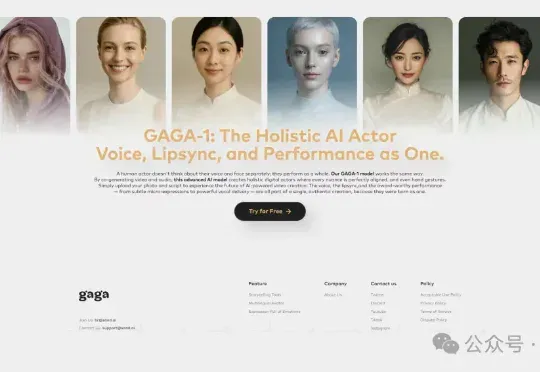
那边OpenAI的Sora2还没全面开放,这边国内团队已经上线了自己的“特色打法”。 清华特奖选手创办的Sand.ai,上线了音画同步视频模型GAGA-1。
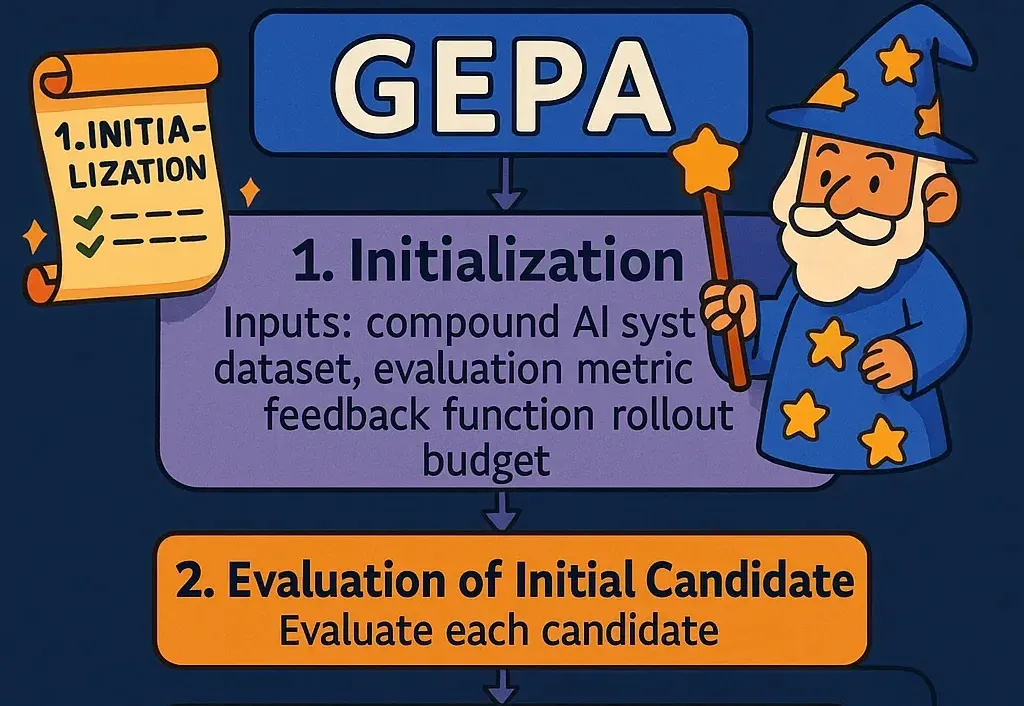
写给正在落地 AI 产品的工程师。一些代码直接可改造复用;另一些,是我踩坑后的经验之谈。
库克和马斯克都盯上的CV公司!打开Prompt AI官网,上面介绍了这家公司的定位:一家专注于消费应用视觉智能的AI公司。这家总部位于旧金山的初创公司,其核心团队非常UC伯克利范儿:
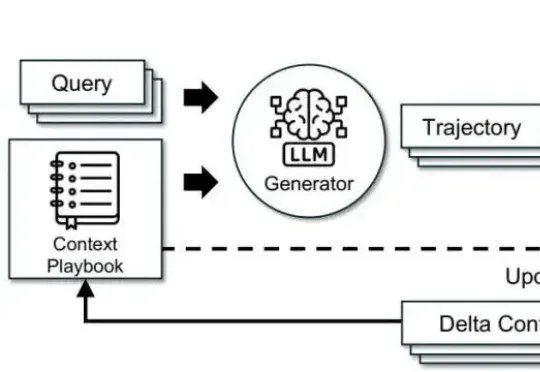
调模型不如“管上下文”。这篇文章基于 ACE(Agentic Context Engineering),把系统提示、运行记忆和证据做成可演化的 playbook,用“生成—反思—策展”三角色加差分更新,规避简化偏置与上下文塌缩。在 AppWorld 与金融基准上,ACE 相较强基线平均提升约 +10.6% 与 +8.6%,适配时延降至约 1/6(-86.9%),且在无标注监督场景依然有效。
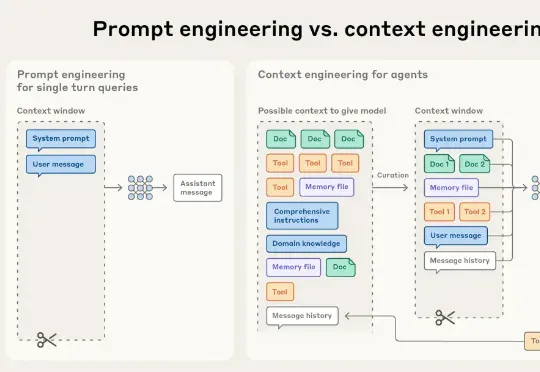
Hi,返工早上好。 我是洛小山,和你聊聊 AI 行业思考。 AI Agent 应用的竞争逻辑,正在发生根本性变化。 当许多团队还在死磕提示词优化(PE 工程)时,一些优秀团队开始重心转向了上下文工程
随着Agent的爆发,大型语言模型(LLM)的应用不再局限于生成日常对话,而是越来越多地被要求输出像JSON或XML这样的结构化数据。这种结构化输出对于确保安全性、与其他软件系统互操作以及执行下游自动化任务至关重要。
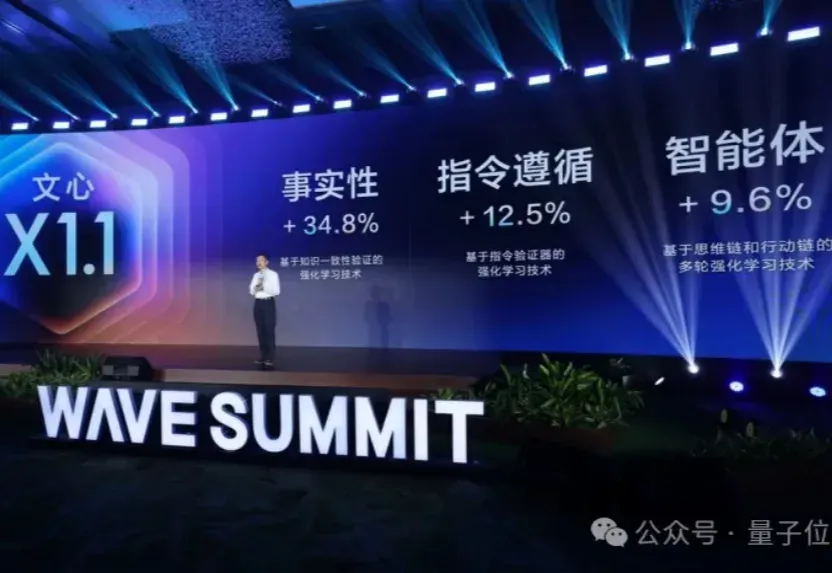
刚刚,百度深度思考模型升级上线了! 升级后的文心大模型X1.1,在事实性、指令遵循、智能体等能力上均有显著提升。 官方展示了其在智能客服场景复杂长程任务中的应用,在System Prompt中输入用户的问题后,文心X1.1借助模型本身智能体能力,即可自动拆分复杂任务,调用不同工具逐步规划执行,且严格遵循服务流程和业务规则。 再用它编写python脚本,让25个彩色粒子在真空圆柱形容器里弹跳、留轨迹,还要带容器旋转和场景缩放。 效果丝滑,粒子全程守规矩没出界: 用HTML动画整活归并排序,排序过程动态可视化,算法步骤一目了然: 具体到数据上的提升,相比文心大模型X1,X1.1的事实性提升34.8