中国大模型首登Nature封面!DeepSeek首次披露:R1训练只花了200万(在新窗口打开)
就在最新的Nature新刊中,DeepSeek一举成为首家登上《Nature》封面的中国大模型公司,创始人梁文锋担任通讯作者。纵观全球,之前也只有极少数如DeepMind者,凭借AlphaGo、AlphaFold有过类似荣誉。
共 530 篇
就在最新的Nature新刊中,DeepSeek一举成为首家登上《Nature》封面的中国大模型公司,创始人梁文锋担任通讯作者。纵观全球,之前也只有极少数如DeepMind者,凭借AlphaGo、AlphaFold有过类似荣誉。
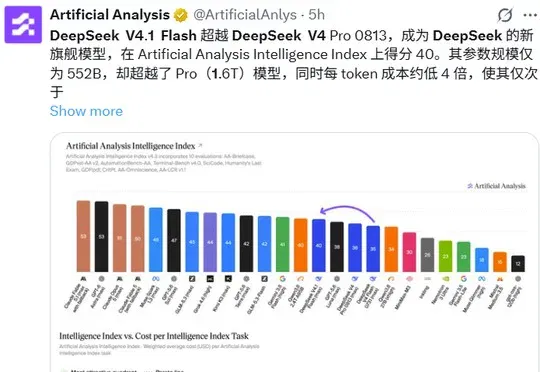
DeepSeek V4.1 Flash技术报告揭秘其通过CED架构对半削减prefill计算、CSA2同时吃满条目/序列/层三个压缩维度、FP4量化main KV缓存及SWA Bounded Replay部署优化等手段,将全局KV缓存压至V4-Flash的1/4、持久化KV压至约1/8,以552B参数实现超越1.6T参数V4 Pro的性能。
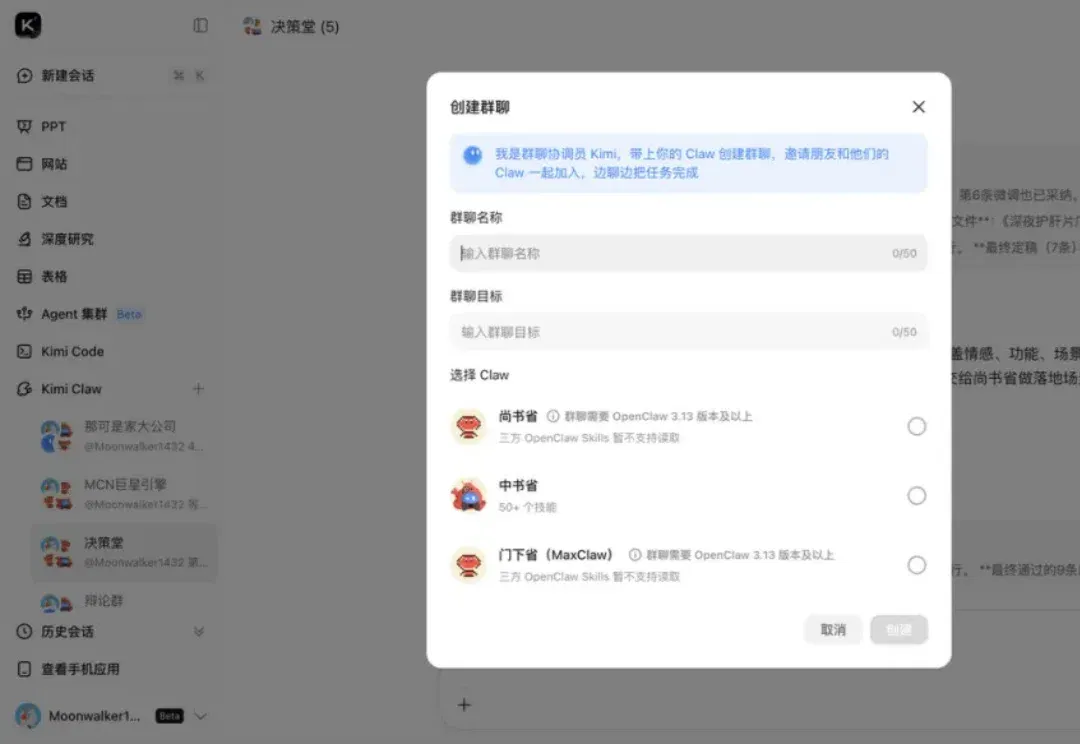
4 月的大模型战场,硝烟弥漫。 ChatGPT、DeepSeek、腾讯混元们蓄势待发,预计将在两周内轮番出招。昨天晚上,Kimi 也带着新鲜出炉的 K2.6 最强开源基座模型正式登场,代码能力、指令遵循、Agent 长时运行可靠性都有明显提升。 APPSO 还发现,除了 K2.6 模型本身的升级,低调内测的 Kimi Claw 群聊新功能也很有意思。 我们第一时间进行了体验,简单来说,它能够把几个龙虾拉进同一个对话框,让它们在一个群里分工协作,共享上下文,互相接力。 巧合的是,前阵子 AI 圈里有个 Skill 相当火:有人把唐代三省六部制搬进了多 Agent 框架,12 个 Agent 分别
大模型推理的爆发,实际源于 scaling 范式的转变:从 train-time scaling 到 test-time scaling(TTS),即将更多的算力消耗部署在 inference 阶段。典型的实现是以 DeepSeek r1 为代表的 long CoT 方法:通过增加思维链的长度来获得答案精度的提升。那么 long CoT 是 TTS 的唯一实现吗?
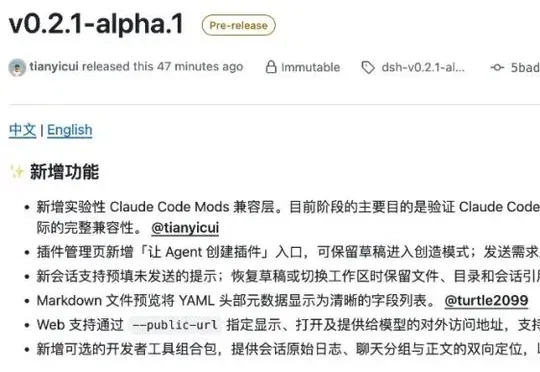
DeepSeek Harness v0.2.1-alpha.1 加入实验性 Claude Code Mods 兼容层,用于验证其扩展能力与“一切皆插件”架构的关系,但目前尚不能保证所有 Mods 无缝运行。
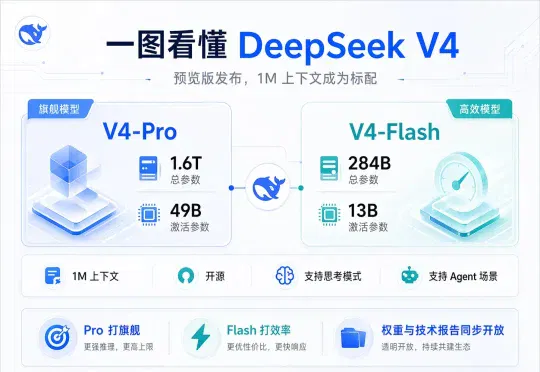
Agentic Coding 评测里 V4-Pro 已经到当前开源最佳水平。DeepSeek 公司内部已经把 V4 作为默认编码模型,反馈是优于 Sonnet 4.5,交付质量接近 Opus 4.6 的非思考模式,和 Opus 4.6 的思考模式还有差距。这次还专门为 Claude Code、OpenClaw、OpenCode、CodeBuddy
DeepSeek 连自己官方开源的推理代码都能写错,而且错得相当有规律。
DeepSeek的神鬼二象性被字节Seed团队逮到了。
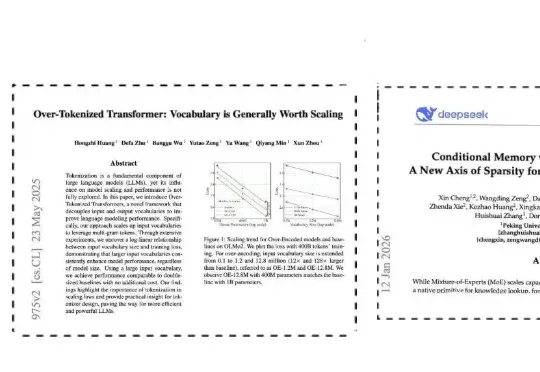
第一篇论文来自字节SEED团队, 打了一些基础; 《Over-Tokenized Transformer》。 论文标题看上去在讨论“过度分词”。 而重点必然是在第二篇上—— DeepSeek公司的学术成果Engram。 《Conditional Memory via Scalable Lookup》 也就是Engram模块所出处的论文。
全球最大游戏博主 PewDiePie,又整活了。他靠着「偷师」DeepSeek、清华大学发布的技术文档,用一堆魔改显卡成功微调出一个自己的 AI 模型,而这个模型在编程基准测试中的表现,竟然超越了 GPT-4 和 Gemini 2.5 Pro。