
深度|大模型的空间直觉从哪里来,又为什么会失灵?MirroS在S-Space里找答案(在新窗口打开)
多模态模型的空间推理,有一种很反直觉的现象:它能看懂图里有什么,也能回答简单的左右上下,却会在换视角、判断方位、推理前后关系时突然失灵。
共 223 篇
多模态模型的空间推理,有一种很反直觉的现象:它能看懂图里有什么,也能回答简单的左右上下,却会在换视角、判断方位、推理前后关系时突然失灵。
过去一段时间,TiDB 团队启动了一项面向 Agent 的基础设施尝试——TiDB Cloud Filesystem。它把 Workspace 从 Session 和 Sandbox 的生命周期中独立出来:Agent 仍然通过熟悉的文件系统接口工作,背后则提供数据库级的持久化、版本、分支、回滚和权限控制。
空间智能企业映界科技MirrorSpace完成超千万元种子+轮融资,海愿资本领投,奇绩创坛、松禾资本持续加注,资金重点用于感知硬件商业化交付与时空世界模型训练。
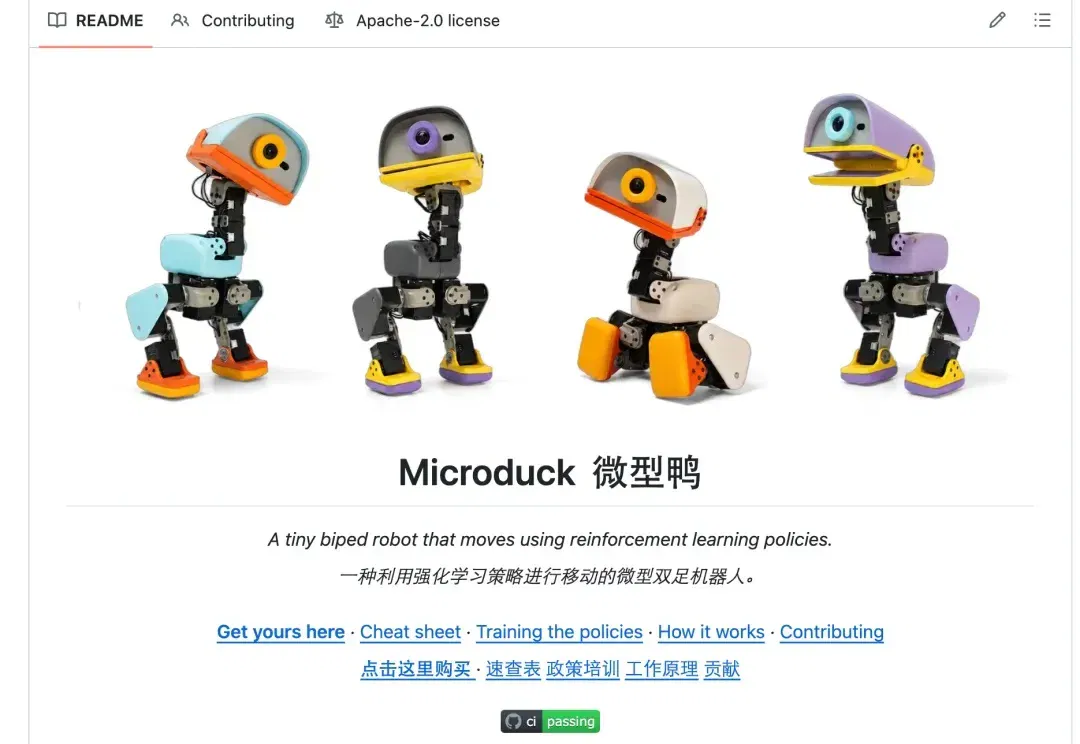
4 秒就能卖出一只,最近 Hugging Face 推出的一款售价 399 美元的「机器鸭」真是卖爆了。
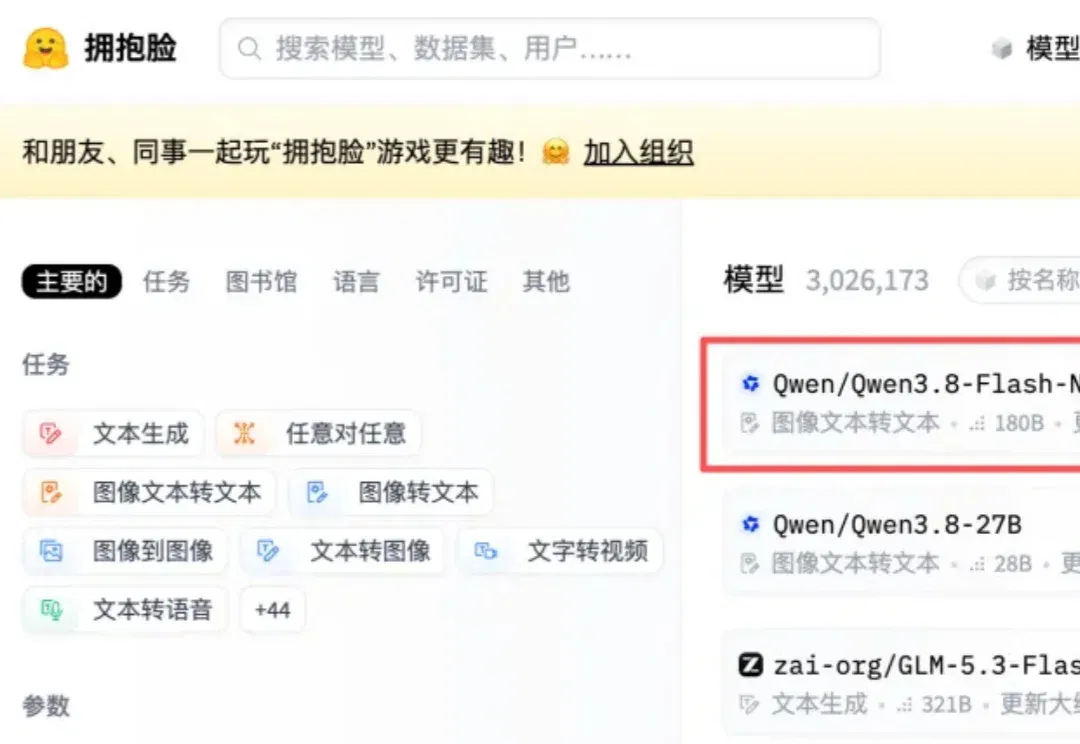
阿里千问新模型,又卷出了新水平。 他们发布并开源的Qwen 3.8 Flash-Next,不仅价格直接秒杀了DeepSeek-V4-Flash,而且刚发布便摘得了Huggingface榜首! 推上网友们也沸腾了,甚至还有工程师甩出实测视频直呼牛逼: Qwen 3.8 Flash踏平了VRAM的门槛,数据中心级的长文本大模型,在消费级4090显卡上也能跑了! 还有人已经兴冲冲地把它用到了工作中。 不到8分钟,它就跑完了涵盖Python编程、多表分析和研究报告生成的一整套工作流: 宝塔特效也不在话下: 哇奥,真有这么炫?我们当然也得上手试试。 每百万Tokens输入仅0.8元 Qwen3.8-Fl
这可能是 Agent 时代迄今最值得警惕的安全事故之一。
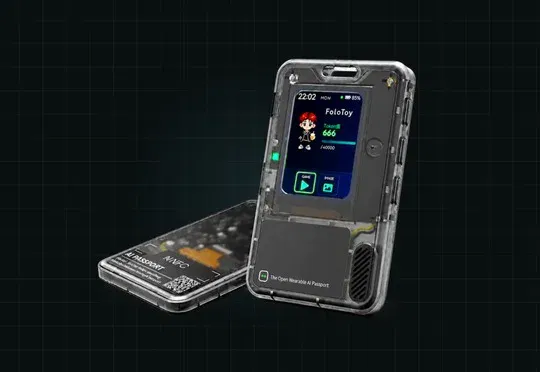
造物100第4期盘点Hugging Face开源鸭子机器人Microduck、Plaud One AI录音耳机、字节TRAE联名FoloToy的AI工牌及Autonomous.ai桌面台灯等多款新品,指出软件公司正以更低价格和半成品DIY策略推动AI从屏幕走向物理设备。
如果说大语言模型拉开了本轮人工智能革命的序幕,那么今天人机交互的瓶颈,早已不再是模型的智商,而是人类接收信息的生理带宽。
OpenAI 刚刚发布的官方博客和数十页技术报告中将其定性为一声「警钟」(warning shot)。同时,第三方机构 METR 和 Redwood Research 发布了独立调查报告。OpenAI 的 Noam Brown 提醒,驱动这次事件的模型与 GPT-5.6 Sol 同等规模,下一代模型能力会更强。
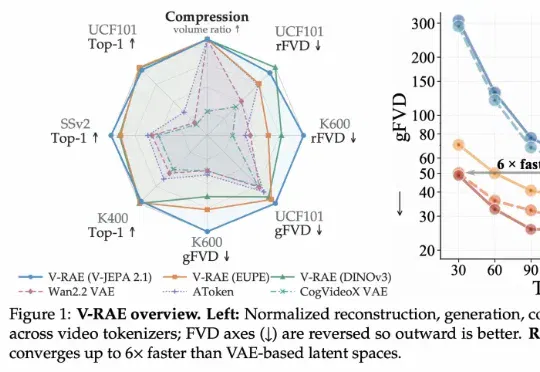
近日,新加坡国立大学 Minghui Guo 与牛津大学 Shengqiong Wu、Hao Fei 在论文《V-RAE: Rethinking Video Latent Spaces for Generation》中提出视频表征自编码器 V-RAE。该方法以冻结的视觉基础模型为编码器,通过轻量级时间池化压缩视频特征,并将具有丰富语义和时间连续性的表征直接用于视频重建、生成与未来预测。