云计算一哥10分钟发了25个新品!Kimi和MiniMax首次上桌(在新窗口打开)
从未见过如此凡尔赛的名场面。云计算一哥亚马逊云科技CEO Matt Garman,在自家年度盛宴re:Invent 2025中,因为还要发布的新产品太多了,于是他在现场来了一句: 我挑战一下10分钟内发布25个产品!
共 168 篇
从未见过如此凡尔赛的名场面。云计算一哥亚马逊云科技CEO Matt Garman,在自家年度盛宴re:Invent 2025中,因为还要发布的新产品太多了,于是他在现场来了一句: 我挑战一下10分钟内发布25个产品!
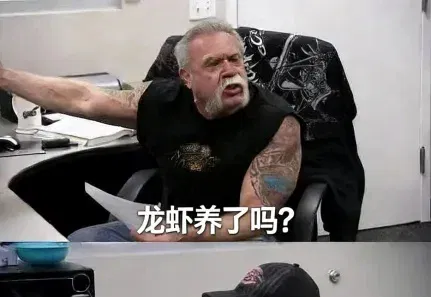
今天刷到一张梗图,逗得我嘎嘎乐: 这阵子,OpenClaw 把大家搞得很上头,但 token 花钱如流水,月薪两万养不起一只「小龙虾」。 终于,腾讯 基于 OpenClaw 开源生态推出了一键安装版本 ——QClaw,主打简单、零门槛部署,无需准备服务器、无需输入命令行、无需额外配置 IM 工具,下载就能直接用。 咱们普通人也能玩上「龙虾」了。 和 OpenClaw 一样,它可以让人们通过对话聊天的方式操控自己的电脑,无需复杂配置,即可直连 DeepSeek、Kimi、MiniMax 等主流大语言模型。 若选择「自定义大模型」,千问、混元、豆包等也是随便选,但需要提供 API Key。 QCl
月之暗面融资传闻升级,估值或逼近MiniMax。Kimi产品因MAU下滑、DeepSeek冲击失速,战略转向Coding和Agent方向,推出分层会员订阅商业化。杨植麟在开源上妥协,但坚持基座模型和toC路线,面临分发弱势和高昂成本,未来半年需明确定位应对激烈竞争。
我自己用 Coding Plan 也有一段时间了,最开始只是为了省点 API 钱,后来各家陆续推出固定月费套餐,我发现选起来比想象中复杂。Codex、Claude Code、Cline、OpenClaw 这些工具让开发者越来越习惯用自然语言驱动代码生成和任务执行,但高频调用带来的 API 成本也成了一笔固定开销。
这是葬AI起号以来工作量最大的一篇文章。为了严肃评测国产模型的能力,我自研了一个Benchmark,完整测试了智谱、Qwen、Kimi、Minimax、Deepseek这些最新国产模型,还引入了境外势力Claude作对照组。
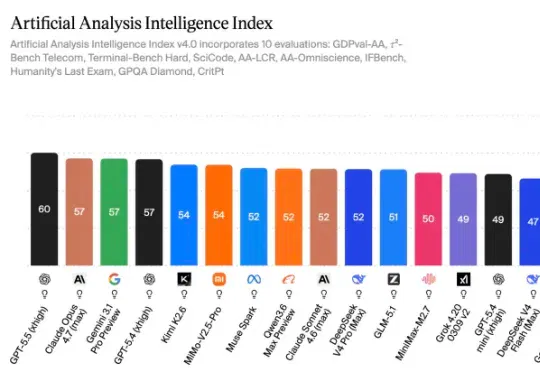
上周太集中发的后果就是光在用GPT -5.5了,小米的Mimo-V2.5-Pro,DeepSeek V4 Pro还没有放在Agent的场景上测。所以我跟钱包一拍即合,复制了4个一模一样的Hermes Agent,记忆一样,skill一样,系统设置一样,能调用的工具也一样。
RunningHub基于MiniMax H3开源基座发布增强版H3 RH Enhanced,2000组实测显示其多镜头长时叙事能力显著优于Seedance 2.0,16镜以上角色崩坏率降低超60%,生成成本低至0.1元/秒。
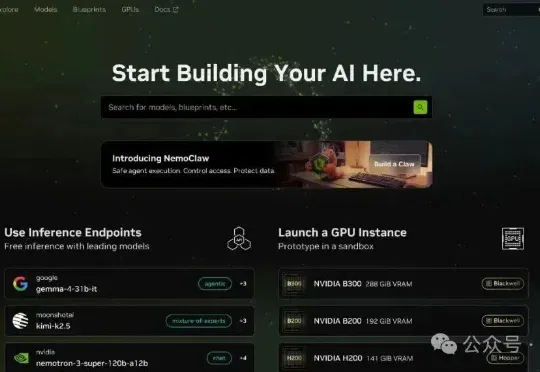
英伟达良心福利!免费领一年顶级大模型订阅,MiniMax / Kimi / DeepSeek 全都能用!NVIDIA 官方平台build.nvidia.com开放了一批"Free Endpoint"模型,注册账号、验证手机号后就能生成一把最长有效期12 个月的 API Key,免费调用几十个当下最火的大模型——不计 Token、无余额限制、无需信用卡。
TaoMate-H3 是由阿里巴巴 TaoLive AIGC 团队研发的音视频联合流式生成模型。基于 MiniMax H3,TaoMate-H3 将三步 LoRA 推理与自回归生成相结合,能够根据文本
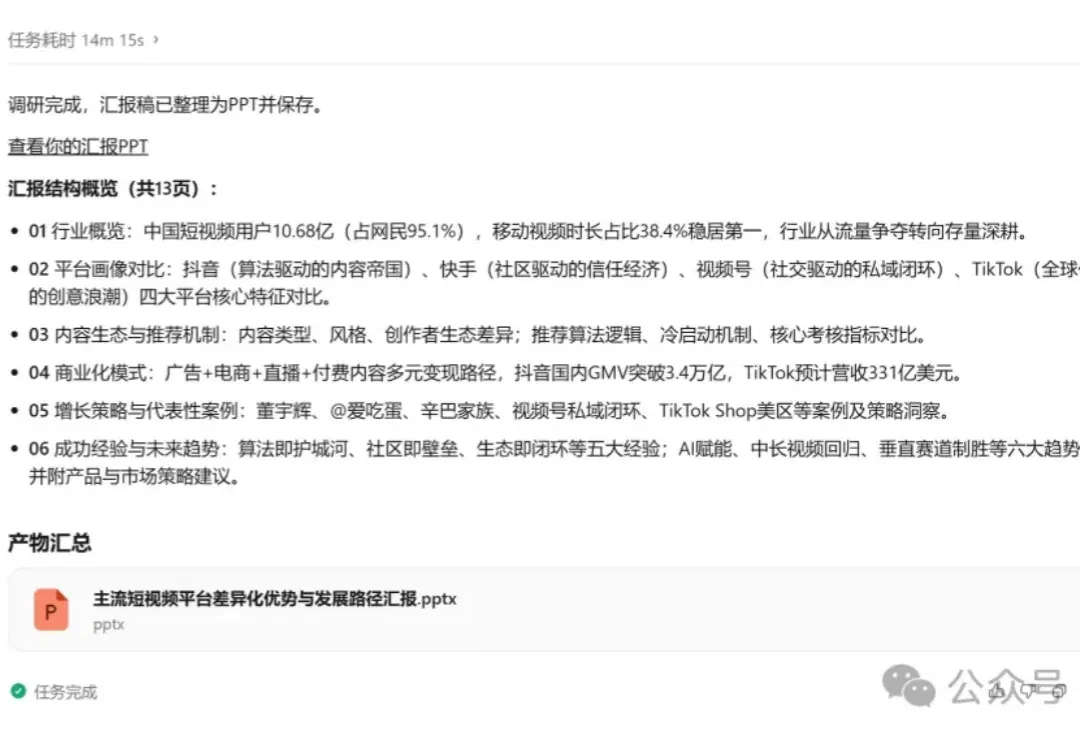
最近这段时间,国内外模型更新得很快。 如果只看发布会和榜单,大家都会觉得每个模型都很强。参数更大、上下文更长、推理更强、价格更低,听起来都挺猛。 但真正用到工作流里,会发现另一件事:模型强不强,不只看它会不会回答问题,还要看它能不能把一个任务完整跑完。 尤其是 Agent 场景。 一个复合任务需要大模型去调用多个工具,比如让模型做一份 PPT,它并不是简单写几页文字。中间要先理解需求,再去搜索资料,阅读网页,提取关键信息,整理成汇报结构,必要时还要生成代码或调用插件,最后产出一个可以正常使用的PPT文件。 下面测试两个Agent任务,使用同样的提示词,相同的Agent工具-Trae Work。