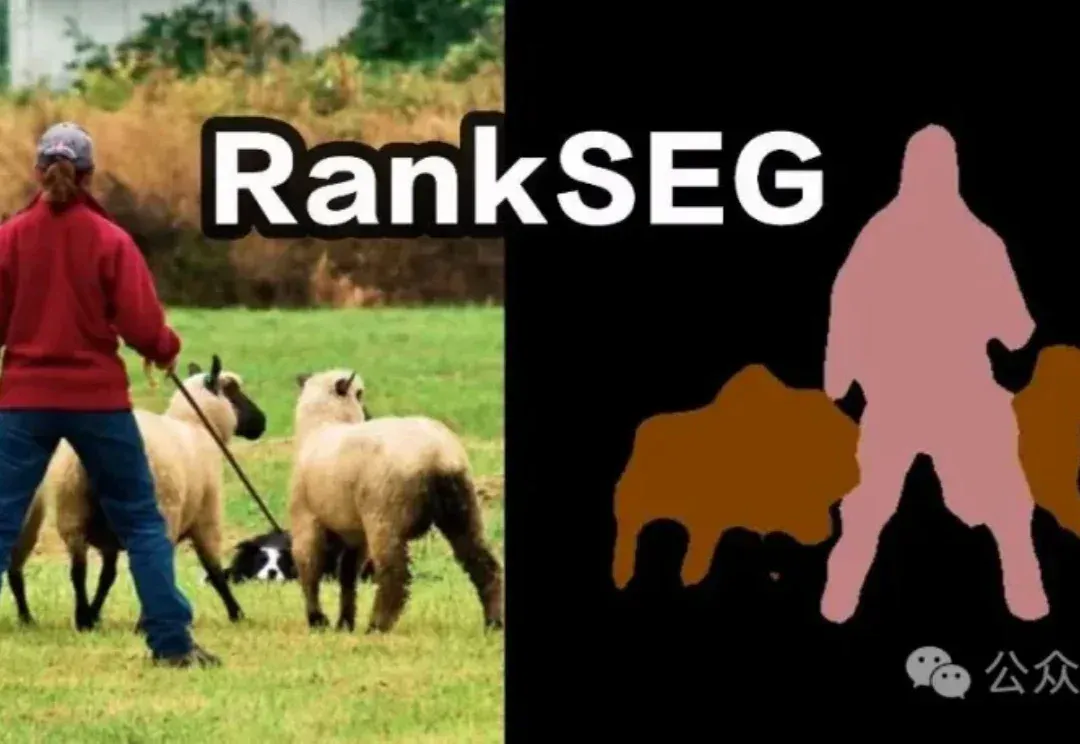
语义分割别无脑用Argmax!港中文新算法:三行代码,推理速度提升10倍(在新窗口打开)
香港中文大学提出了一个全新的算法框架RankSEG,用于提升语义分割任务的性能。传统方法在预测阶段使用threshold或argmax生成掩码,但这种方法并非最优。RankSEG无需重新训练模型,仅需在推理阶段增加三行代码,即可显著提高Dice或IoU等分割指标。
共 278 篇
香港中文大学提出了一个全新的算法框架RankSEG,用于提升语义分割任务的性能。传统方法在预测阶段使用threshold或argmax生成掩码,但这种方法并非最优。RankSEG无需重新训练模型,仅需在推理阶段增加三行代码,即可显著提高Dice或IoU等分割指标。
MiniMax今起招股,作价461亿港元,拟募资超6亿美元。预计将于1月9日正式挂牌上市,代号00100。
第一批AI大模型公司上市潮来了,先冲线的两家公司MiniMax、智谱揭开了自己的底牌。
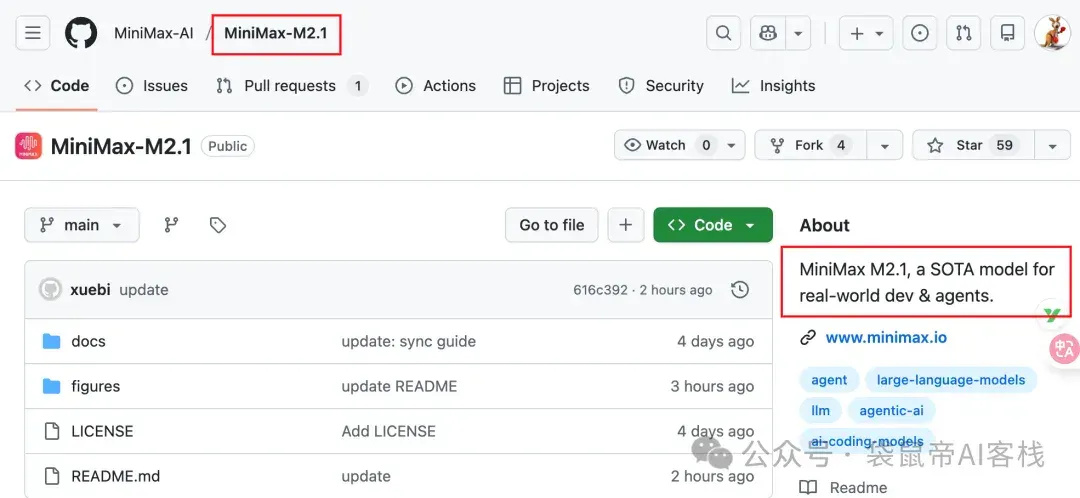
上周我还在折腾各种图片、视频生成模型,这周又到了编程周。前天MiniMax丢出了个在编程界绝对有分量的模型:MiniMax-M2.1。然后发现就在刚才已经开源了:
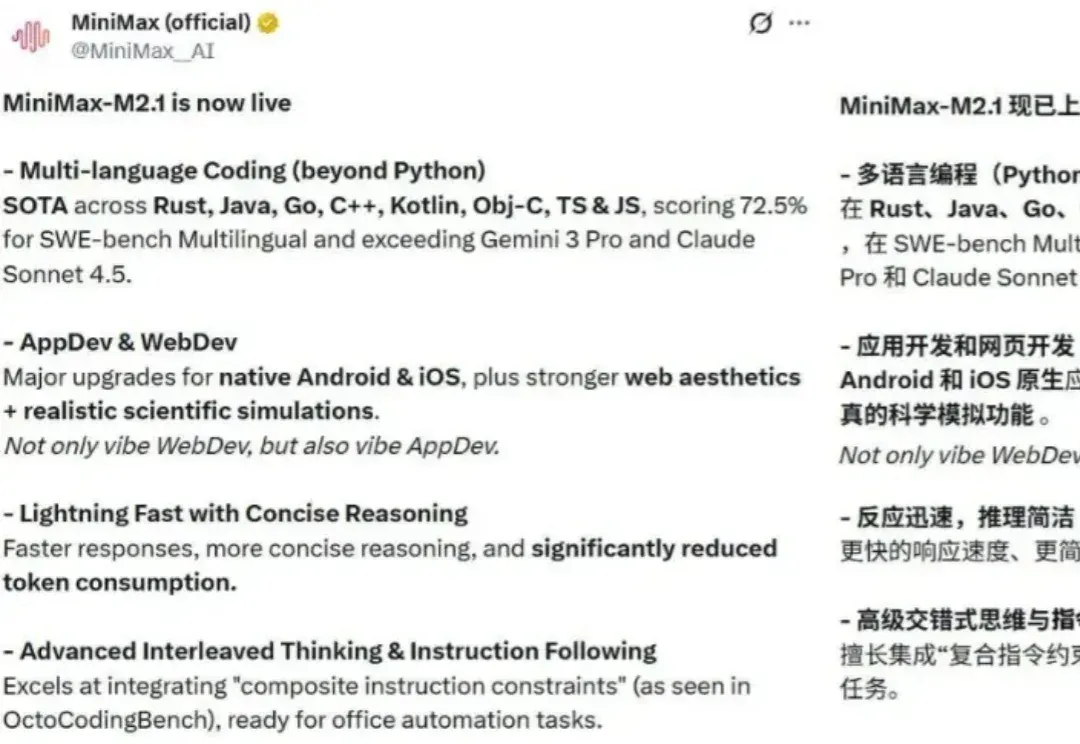
这两天,中国 AI 行业关注的核心无疑是 MiniMax。
MiniMax最新旗舰级Coding & Agent模型M2.1,刚刚对外发布了。这一次,它直接甩出了一份硬核成绩单,在衡量多语言软件工程能力的Multi-SWE-bench榜单中,以仅10B的激活参数拿下了49.4%的成绩,超越了Claude Sonnet 4.5等国际顶尖竞品,拿下全球SOTA。
要说这两天AI圈最火的一条消息,莫过于MiniMax正式通过港交所聆讯,即将冲刺IPO。
MiniMax海螺视频团队不藏了!首次开源就揭晓了一个困扰行业已久的问题的答案——为什么往第一阶段的视觉分词器里砸再多算力,也无法提升第二阶段的生成效果?翻译成大白话就是,虽然图像/视频生成模型的参数越做越大、算力越堆越猛,但用户实际体验下来总有一种微妙的感受——这些庞大的投入与产出似乎不成正比,模型离完全真正可用总是差一段距离。
刚刚,上海大模型独角兽MiniMax,正式通过港交所聆讯,吹响了IPO冲刺号角。但直到招股书披露,更重要的资本吸引力原因才完全明确——不仅因为全模态能力全球领先,更关键的是,累计花费只用了5亿美元,不到OpenAI的1%。
12月21日,全球通用人工智能(AGI)公司MiniMax(稀宇科技)首次刊发其聆讯后资料集(PHIP)版本的招股书资料,有望刷新记录,成为从成立到IPO 历时最短的AI公司,标志着中国力量在国际资本市场迈出关键一步。