比李飞飞World Labs早两年押注原生4D,影身智能这次是真走在前面了?(在新窗口打开)
AMD以约82亿美元收购World Labs之际,影身智能凭借比World Labs早两年押注原生4D世界模型路线引起关注,其利用4至6台消费级摄像头和单块消费级GPU实时生成4D数据的技术已在福建晋江制鞋工厂落地,斩获2亿元机器人订单。
共 229 篇
AMD以约82亿美元收购World Labs之际,影身智能凭借比World Labs早两年押注原生4D世界模型路线引起关注,其利用4至6台消费级摄像头和单块消费级GPU实时生成4D数据的技术已在福建晋江制鞋工厂落地,斩获2亿元机器人订单。
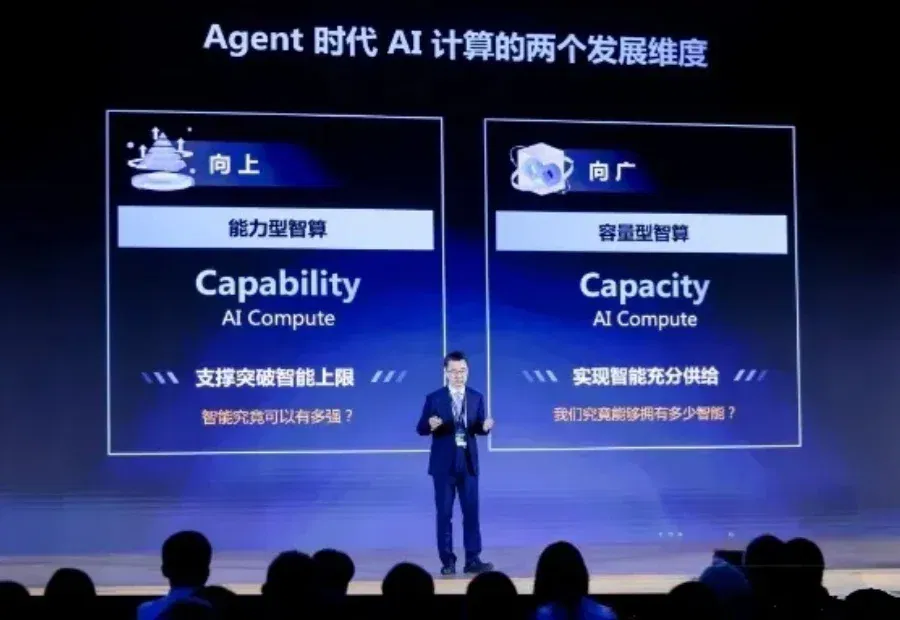
AI产业的两道坎,浪潮信息怎么翻? 2026年,Agent的火爆程度空前。 9月21日,在AICC 2026大会上,IDC发布了一组数字:2026年全球活跃Agent约7940万个,到2030年将达22.16亿个。 而同期Token消耗量的增长更为惊人:从2026年的0.026Peta(千万亿),增长到2030年的152667Peta。Agent数量增长约28倍,Token消耗却增长数百万倍。 需求侧增长如此之快,算力供给能接住吗? 今年有两个案例十分典型: 一是Kimi K3。这个总参数量2.8万亿的模型,权重文件达到1.56TB,普通AI服务器的GPU显存连权重都装不下,官方推荐至少64卡
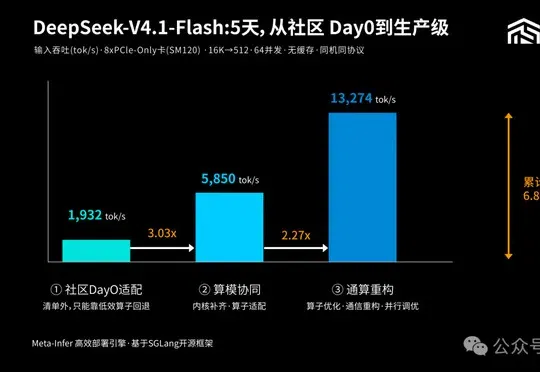
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
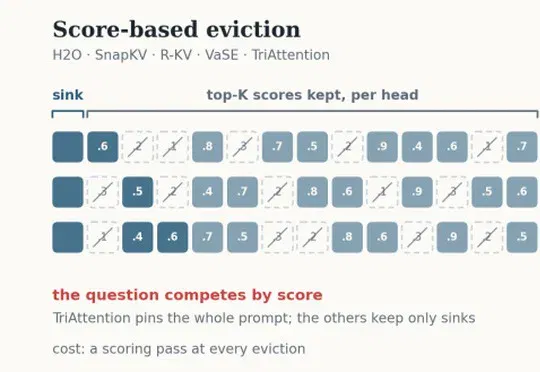
大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
AI存储进入全流程竞争。 智东西9月17日报道,9月1日,全球权威AI性能评测组织MLCommons发布MLPerf Storage v3.0基准测试榜单。焱融全闪AI存储F9000X在多项基准测试中拿下第一,充分验证其在极限AI训练负载下对高速网络带宽的高效利用能力。 ▲数据引用:MLPerf Storage Benchmark v3.0 Suite Results 2026 随着AI产业从模型训练走向规模化推理,存储系统需要处理的数据和承担的任务也在增加。训练阶段,存储要持续向GPU供给海量数据,还要快速保存和恢复模型 Checkpoint;推理阶段,系统又要管理不断膨胀的KV Cache
DeepSeek资深MLSys工程师刘胜与深夜发文,坦承刚完成V4.1核心算子交付后,意识到AI已能自主编写和优化GPU算子,正迫使他从手写底层算子转向驾驭AI Agent的"机甲驾驶员",并警示工程底层能力空心化可能带来系统性风险。

四年前,法国举办的一场 CNCF 大会上,主持人向台下的大模型创业者抛出一个常规问题:“Kubernetes 能为 AI 带来什么?”
韩国正式启动"AI for All"全民AI计划,由SK Telecom、KT、Kakao三大联盟承建,政府拨付512张NVIDIA B200 GPU算力并要求至少80%服务运行在国产模型上,将向5100万国民提供免费无限量AI服务至2028年。
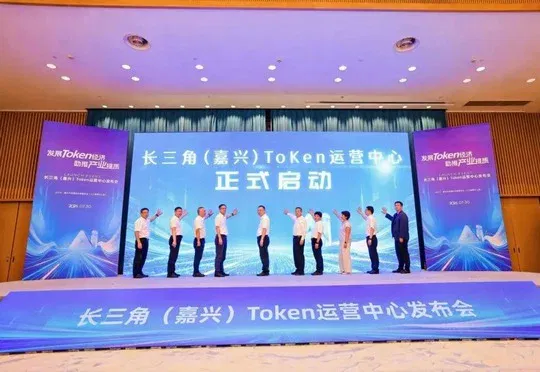
嘉城集团、济南城投集团等地方国资正建设Token运营中心或Token工厂,以盘活GPU并拓展算力服务,但Token业务能否实现规模化盈利仍待验证。
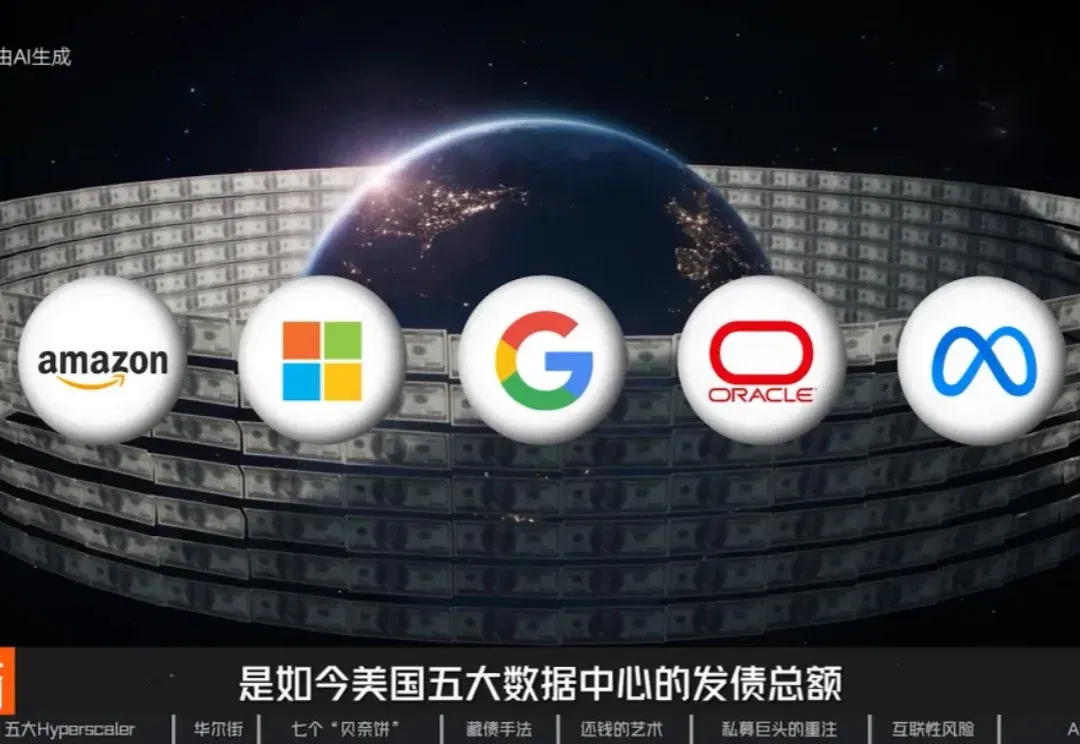
1.65万亿美元,用100美元纸币首尾相连,可以绕地球赤道约64圈。这个数字,是如今美国五大数据中心的发债总额。而如今,这些负债,似乎离奇地“消失”了。