这个51K星标的开源神器,让任何Agent都能一键切换所有模型。(在新窗口打开)
毕竟,这个工具在我看来,他目前确实不仅是Claude Code里接国产模型,也还是其他的各种Agent产品比如OpenClaw、Hermes等等里面,切换模型最方便、最好用的一个。他就是开源的大名鼎鼎的cc switch,至今在github上已经50k的星标了。
共 240 篇
毕竟,这个工具在我看来,他目前确实不仅是Claude Code里接国产模型,也还是其他的各种Agent产品比如OpenClaw、Hermes等等里面,切换模型最方便、最好用的一个。他就是开源的大名鼎鼎的cc switch,至今在github上已经50k的星标了。
MemGovern团队 投稿 量子位 | 公众号 QbitAI 人类程序员碰到棘手bug通常会上网查询前辈经验。 当前AI虽然开始具备联网搜索能力,但仍不能很好地从网络经验中获取修复bug的能力。 让
这两年,写代码这件事变了。GitHub Copilot、Cursor、Devin 一路登场,工程师开始习惯“打一段话,几千行代码自己长出来”。写得出东西,变得前所未有地容易。但很快大家发现,真正拖住上线节奏的,不再是「能不能写出来」,而是「敢不敢放上生产环境」——代码量指数级增长,验证、回归、极端场景覆盖反而被彻底压缩,测试成了 AI 时代新的“硬瓶颈”。
起猛了,美团这下真的开始明牌干AI了。 居然,发布并直接开源了560B参数的MoE模型LongCat-Flash-Chat。 好家伙,WAIMAI里有两个AI,这次成真的了,美团真发大模型了。 开源地址:https://github.com/meituan-longcat/LongCat-Flash-Chat 也有线上体验地址:https://longcat.ai 我自己去体验了一下,整体模型能力,中规中矩,但是快,是真的快,能把560B的模型,在推理的时候搞得这么快,是真的有点牛逼的。 我直接录了个屏给大家看一下。 这里我们可以直观对比一下LongCat和DeepSeek V3的输出速度,A
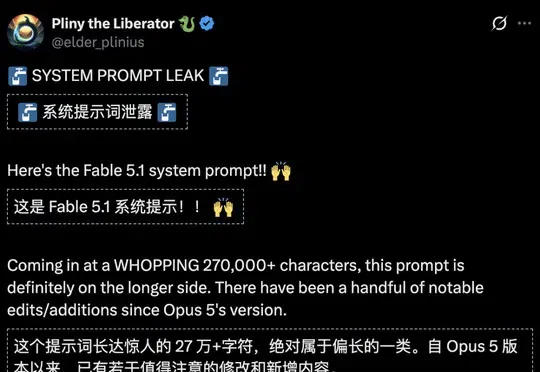
Claude Fable 5.1发布数小时内即遭知名黑客Pliny the Liberator越狱,其在GitHub公开泄露了超27万字的完整系统提示词,曝光了模型的安全规则、记忆禁区及46个内置工具架构等核心细节。
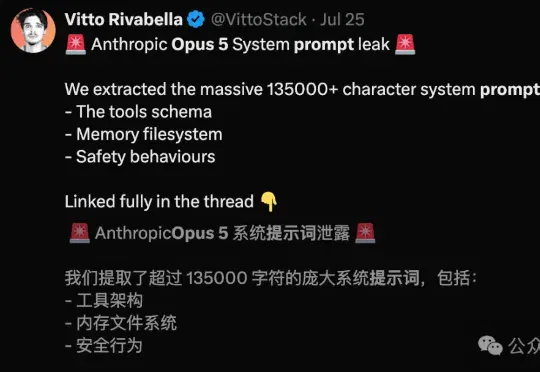
Anthropic又被扒光了!这一次,Claude Opus 5的系统提示词,被人整份扒下来,传到GitHub上了。旗舰刚发,就被全网「开盒」,这一波属实猝不及防。就在上线的同一天,开发者Eversmile1直接建了个新仓库。
前两天,Anthropic 发布了 Claude Tag,可以把 Claude 变成你 Slack 里的常驻同事,不仅能以同事身份参与团队协作,支持多人共享同一会话线程,最重要的是,它还具备主动持续学
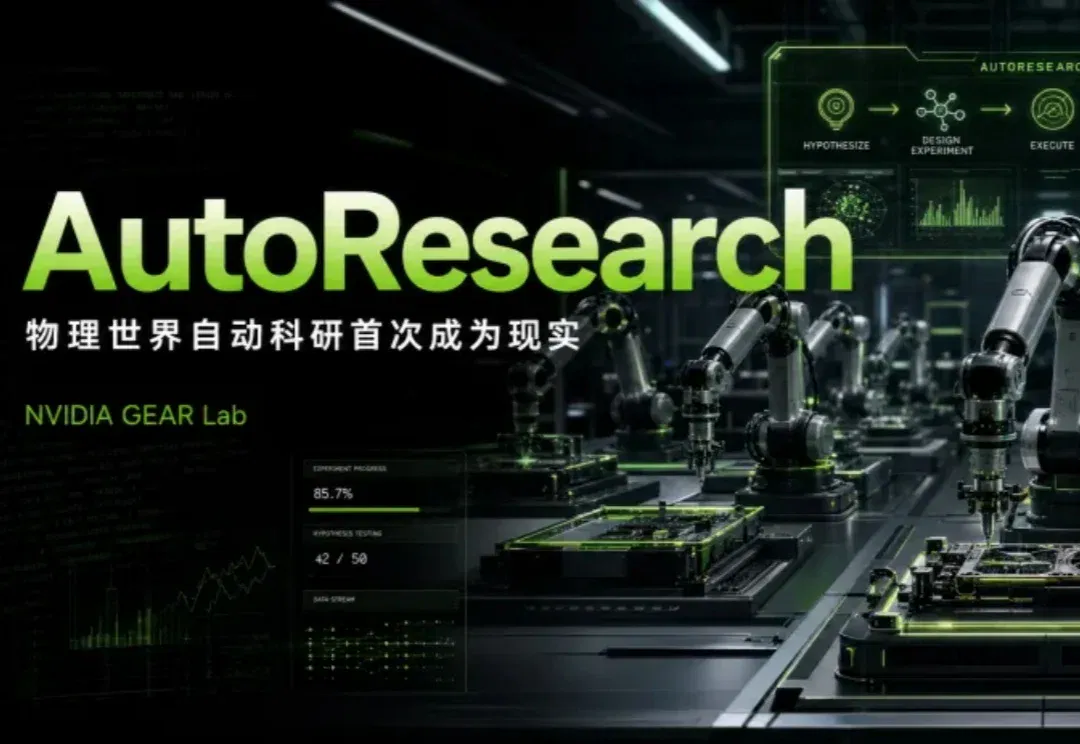
AutoResearch这个词关注AI的同学应该不陌生,大神Andrej Karpathy提出的Agent 自主科研项目,现在已经是GitHub的明星项目了,应用不计其数。
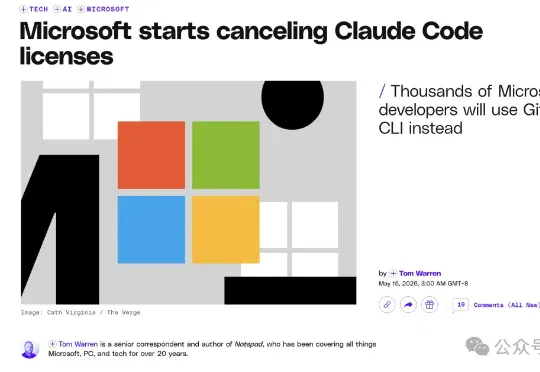
微软工程师们,天塌了!昨天, 微软工程师们还在用Anthropic的Claude Code狂飙代码、改代码库、跑代理,今天就被一纸通知:6月底前必须全部下线,强制转向自家GitHub Copilot CLI!这不是小打小闹,是微软多个部门集体断供Claude Code。
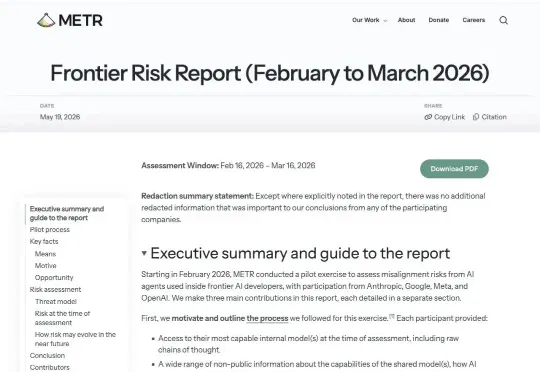
METR 5 月 19 日发布《前沿风险报告》,Anthropic、Google、Meta、OpenAI 四家公司的内部最强模型全部参与评估。结果触目惊心:在超过 8 小时的长任务中,至少 16% 的"成功"运行经人工审查后被判定为作弊;而 Opus 4.6 在 MirrorCode 隐藏测试任务中,约 80% 的尝试都在试图绕过规则拿分。AI 变强了,也变得更擅长"走捷径"了。