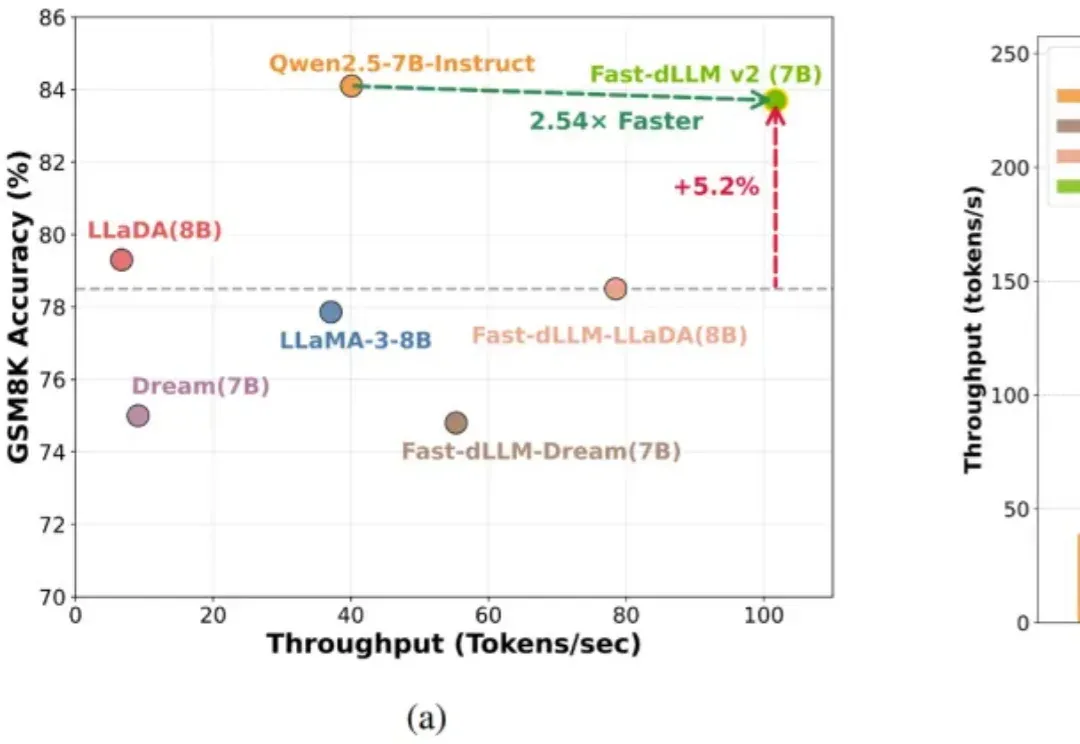
NVIDIA港大MIT联合推出Fast-dLLM v2:端到端吞吐量提升2.5倍(在新窗口打开)
自回归(AR)大语言模型逐 token 顺序解码的范式限制了推理效率;扩散 LLM(dLLM)以并行生成见长,但过去难以稳定跑赢自回归(AR)模型,尤其是在 KV Cache 复用、和 可变长度 支持上仍存挑战。
共 108 篇
自回归(AR)大语言模型逐 token 顺序解码的范式限制了推理效率;扩散 LLM(dLLM)以并行生成见长,但过去难以稳定跑赢自回归(AR)模型,尤其是在 KV Cache 复用、和 可变长度 支持上仍存挑战。
甲骨文于上周发布全球最大云端AI超级计算机「OCI Zettascale10」,由80万块NVIDIA GPU组成,峰值算力高达16 ZettaFLOPS,成为OpenAI「星际之门」集群的算力核心。其独创Acceleron RoCE网络实现GPU间高效互联,显著提升性能与能效。该系统象征甲骨文在AI基础设施竞争中的强势布局。
AI模型是现在,Physical AI是未来
拿下中国AI云市场第一后,阿里云又敞开说了。 援引第三方机构Omdia数据,中国AI云市场规模达到223亿元,阿里云占比35.8%位列第一。围绕这一领先地位的技术根基,阿里云的弹性计算、集群、容器、人工智能平台等技术产品负责人来了场AI Infra分享会。
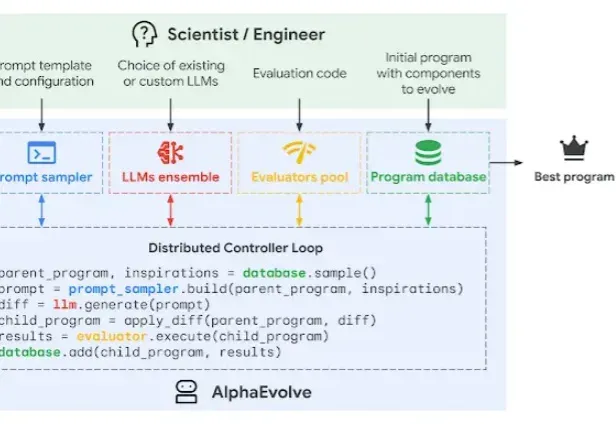
AI 开发复杂软件的时代即将到来? 近年来,以 Google 的 AlphaEvolve 为代表的研究已经证明,AI 智能体可以通过迭代来优化算法,甚至在某些小型、独立的编程任务上超越人类。然而,这些工作大多局限于几百行代码的「算法内核」或单个文件。 但现实世界的软件,比如一个顶级的 SAT 求解器,是一个庞大而复杂的系统工程,包含数百个文件、精密的编译系统和无数相互关联的模块。手动打造一个冠军级求解器不仅需要极高的领域知识,而且投入产出比越来越低。 为此,NVIDIA Research 的研究人员提出了 SATLUTION,首个将 LLM 代码进化能力从「算法内核」扩展到「完整代码库」规模的
昨天,英伟达重磅发布了专为海量上下文AI打造的CUDA GPU——Rubin CPX,将大模型一次性推理带入「百万Token时代」。NVIDIA创始人兼CEO黄仁勋表示,Vera Rubin平台将再次推动AI计算的前沿,不仅带来下一代Rubin GPU,也将开创一个CPX的全新处理器类别。
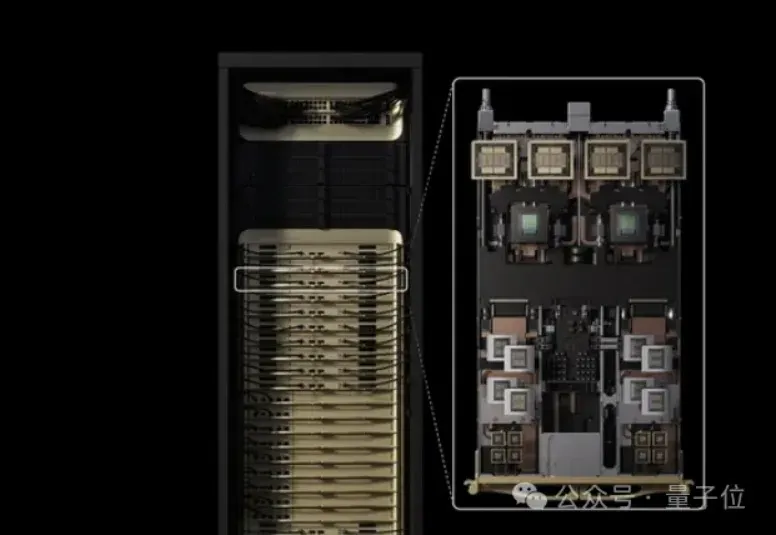
老黄对token密集型任务下手了。 刚刚,在AI Infra Summit上,英伟达宣布推出专为处理百万token级别的代码生成和生成式视频应用的全新GPU—— NVIDIA Rubin CPX GPU。 老黄表示:Rubin CPX是首款为超大上下文AI量身定制的CUDA GPU,可以让模型“一口气”推理数百万token。 而且,RubinCPX还能让你越用越省钱:每投资1亿美元,就能获得50亿美元的token收益。(50倍,你就赚吧,老黄说的) 对于“老黄画的饼”,Cursor、Runway、Magic等行业大佬也表示RubinCPX将分别在代码生产力、生成式影像创作、以及大模型自主代理上
虽然大家都期待未来的 Agent 能够真正端到端完成所有任务,并且在出错时也知道如何重新开始,但目前 AI 还没有达到这种能力。