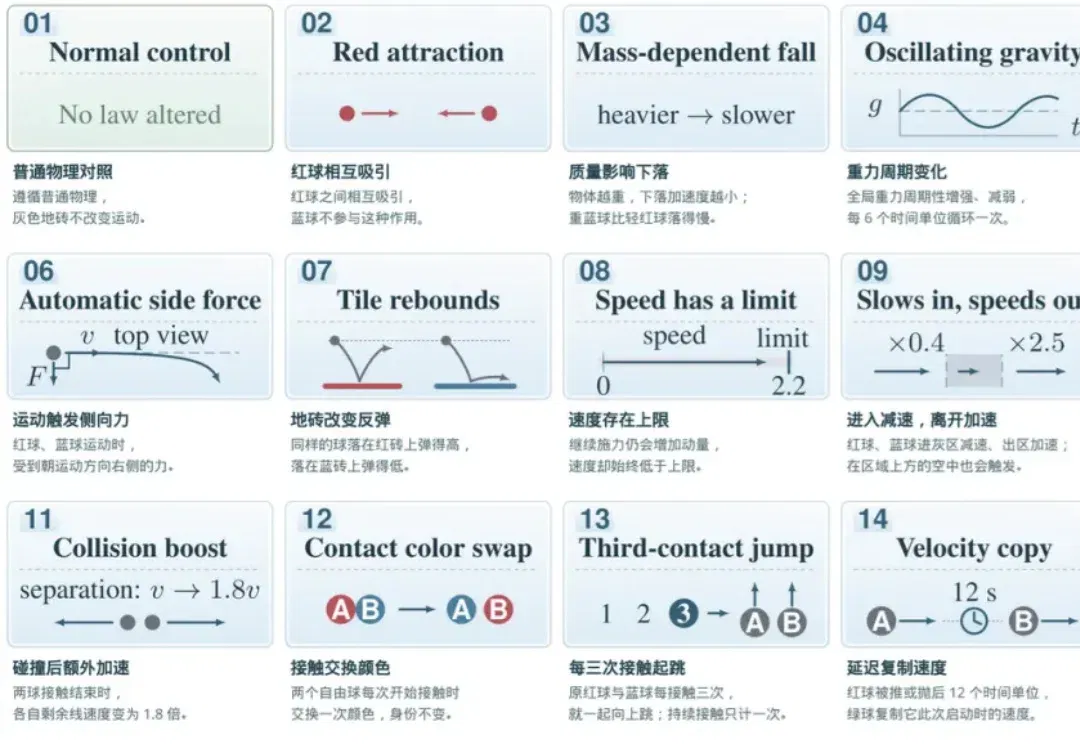
龙场基准让大模型在仿真中寻找未知物理规律(在新窗口打开)
LongChang 构建 15 个 MuJoCo 场景,其中 14 个各改写一条物理规律。在 12 个被测模型中,仅 GPT-6 Astra 得出了有实验支持的规律发现,发现率为 16.7%。
共 165 篇
LongChang 构建 15 个 MuJoCo 场景,其中 14 个各改写一条物理规律。在 12 个被测模型中,仅 GPT-6 Astra 得出了有实验支持的规律发现,发现率为 16.7%。
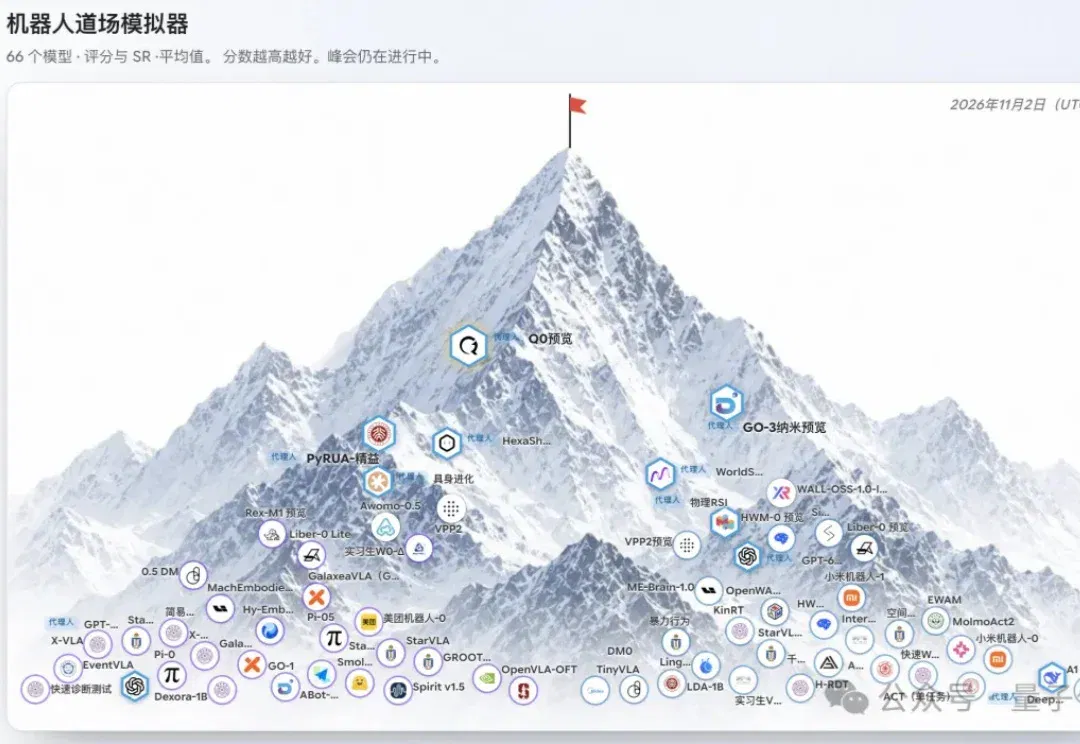
文章结合 GPT-6 Astra 的仿真结果与业界采访,比较零样本适应、实时控制与复杂接触任务。仿真测试不能直接推断真实部署效果。
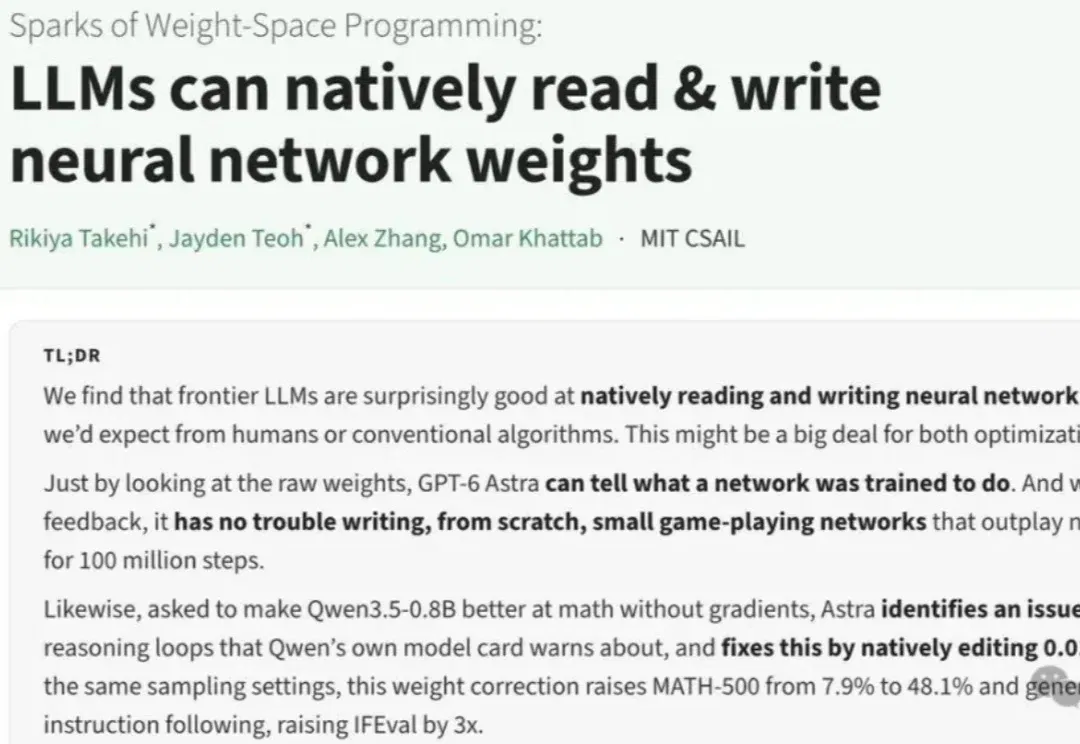
spaCy 作者 Matthew Honnibal 区分了两类实验:小型网络任务直接输入原始权重,Qwen 数学修复则允许 Python 和前向测试。他肯定工具辅助编辑的结果,同时质疑把两类条件合并表述。
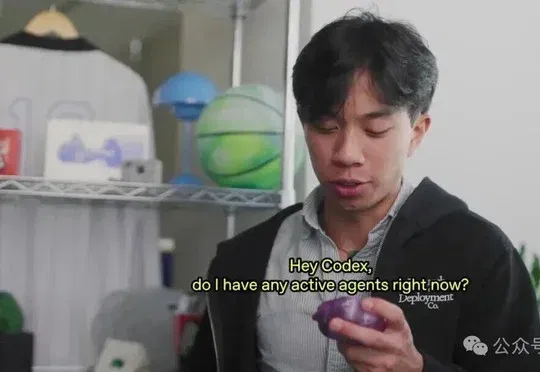
OpenAI 展示 GPT-6 Astra 辅助电子宠物设计,以及与赛车团队、马自达探索建模和仿真的项目。设计文件约一周完成,工厂制作原型另需时间与多轮人工修正;工程演示和内部评测尚不能等同自动量产能力。
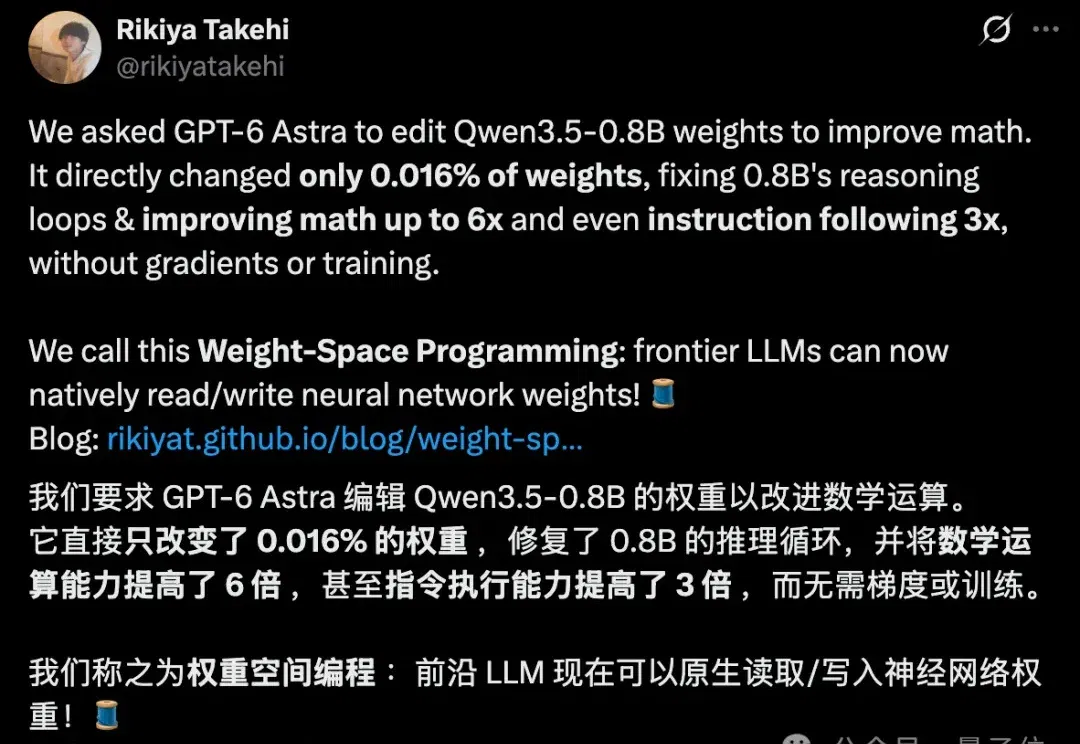
研究者让 GPT-6 Astra 分析神经网络权重并生成修改方案。在Qwen3.5-0.8B的特定采样设置下,50次前向调用预算的方案使MATH-500得分从7.9%升至48.1%。实验省去了目标模型的梯度更新,仍需要诊断、推理和评测计算。
OpenAI 发布一段动画后,社交平台出现关于 GPT-6.1 Astra 的发布猜测,另有第三方追踪截图被解读为 GPT-6.2 Betelgeuse 线索。文中所引12万亿参数、跑分、价格与上线时间来自匿名或社交平台爆料,尚无相应官方确认,动画本身也不能证明由哪款模型制作。
多机构团队提出OpenDS任务范式并构建含200道任务的OpenDS-World评测基准,GPT-6 Astra以39.0%准确率居首,显示AI Agent在真实网络长程搜索与证据整合方面仍面临重大挑战。
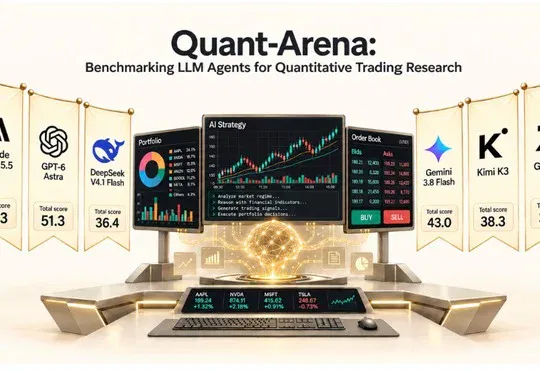
EinsiaAI旗下Navers Lab发布Quant Arena,将6家厂商的9个模型置于A股历史数据中评测,4个代表策略盈利、5个亏损,最佳GPT-6 Astra年化收益10.7%仍低于17.1%的市场基准。
如今,AI正式杀入物理世界! 在具身能力方面,语言模型到底谁能称王? 更残酷的问题是,机器人公司耗费数年苦练的本领,会被通用LLM直接碾压吗? 就在今天,GPT-6 Astra、GPT-6.1 Sol、Claude Opus 5.5 以及 Gemini 4 Argon 等全球最顶尖的多模态大模型齐聚一堂。 在常态化具身智能仿真评测平台 RoboColiseum(机器人角斗场) 上,它们展开了一场真刀真枪的「肉搏战」。 这份榜单不仅彻底炒热了具身智能圈,更无情地揭露了当前顶尖大模型在控制机器人时的「隐藏命门」! 揭榜时刻:四模型大乱斗,结果令人意外 本次测试,所有的顶尖模型都接入了统一的控制框架
ChatGPT也学会「摇人」组队干活了!