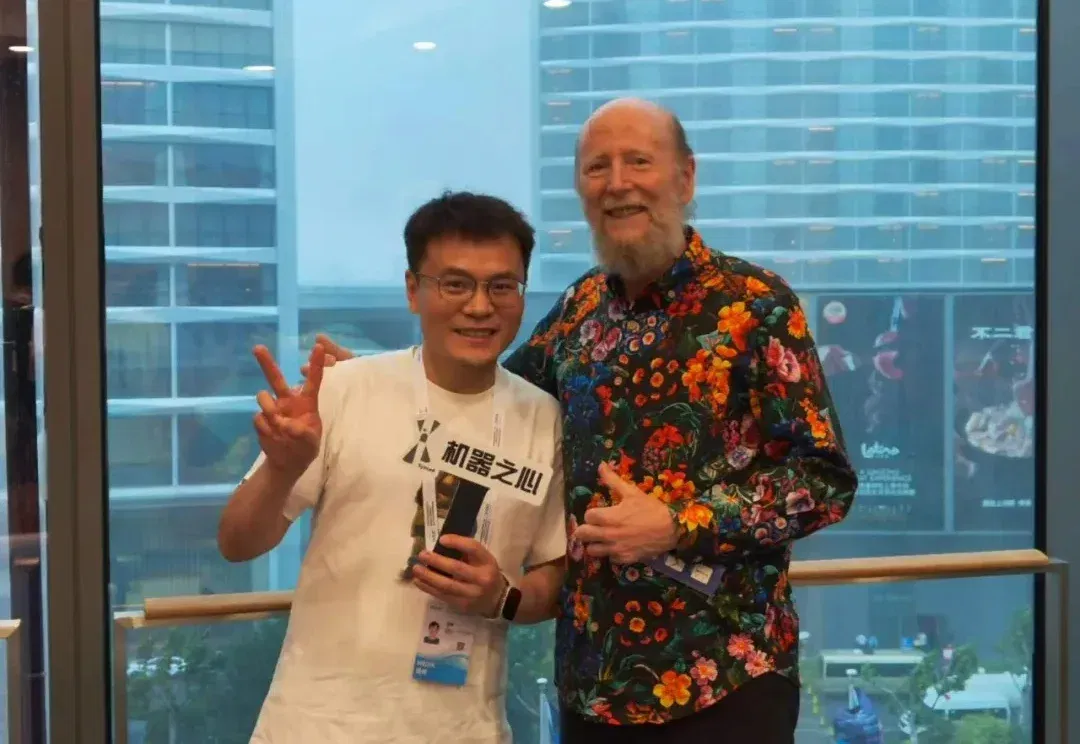
在WAIC现场,我们见到了Richard Sutton(在新窗口打开)
WAIC 2026 期间,我们和另外几家媒体(机器之心是其中唯一的专业媒体)共同对来到中国的强化学习奠基人、2024 年图灵奖得主 Richard Sutton 做了一场群访。
共 198 篇
WAIC 2026 期间,我们和另外几家媒体(机器之心是其中唯一的专业媒体)共同对来到中国的强化学习奠基人、2024 年图灵奖得主 Richard Sutton 做了一场群访。
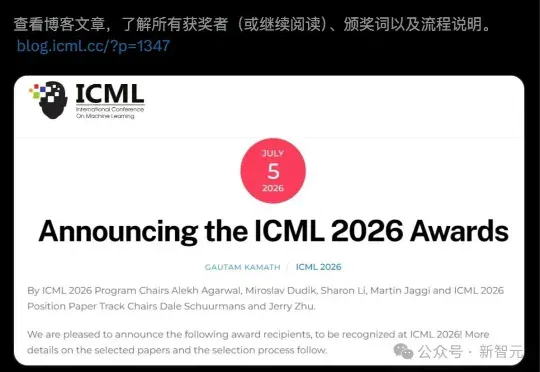
ICML 2026大奖公布来了!ICML年度杰出论文奖和时间检验奖,正式公布。其中杰出论文共有9篇入围,含7篇研究论文及2篇立场论文,最终优胜奖3名和荣誉提名6名;ICML时间检验奖花落强化学习领域,DeepMind经典巨作再封神。
做大模型RL微调,你是不是也踩过这些坑?
公司由姚颂联合正大集团、清华青年学者于超共同发起,定位为物理智能系统公司,通过世界动作模型(WAM)与强化学习技术,推动机器人在真实商业与工业场景中落地,最终成为一个可信赖的机器人服务提供商。目前已完成近亿美元天使轮系列融资,投资方包括正大集团、华勤技术、九安医疗等多家上市企业,多位国内与国际知名企业家,以及多家一线投资机构。
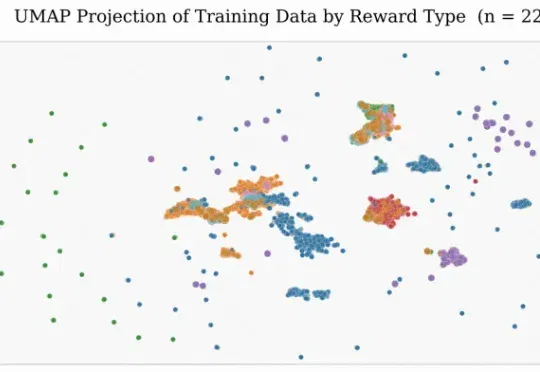
本研究由快手科技语言大模型团队完成,核心作者吕民轩、梅铁桦、杜坦隆等。快手科技与中国科学院大学联合提出 GoLongRL,一套完全开源的长上下文强化学习后训练方案,包含 23K 样本 RLVR 数据集
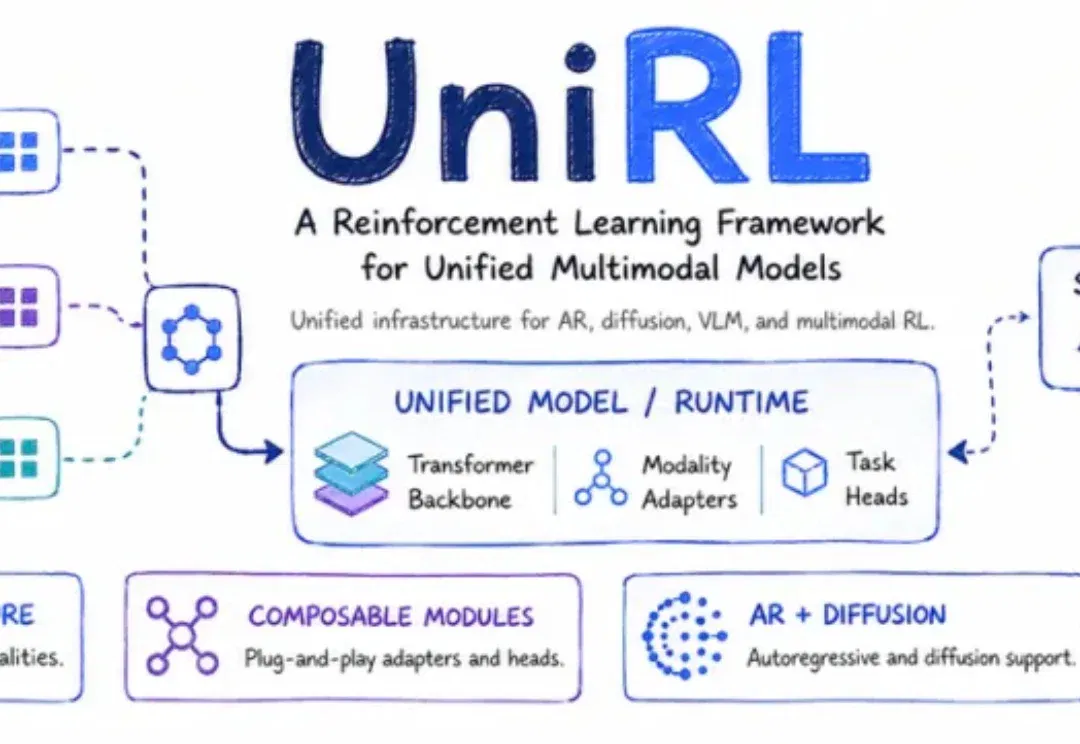
大语言模型的RL技术已日趋成熟,多模态生成模型的强化学习训练却仍在“各自为战”——图像扩散模型一套流程、视频生成另一套标准、VLM和LLM又有不同的技术栈。
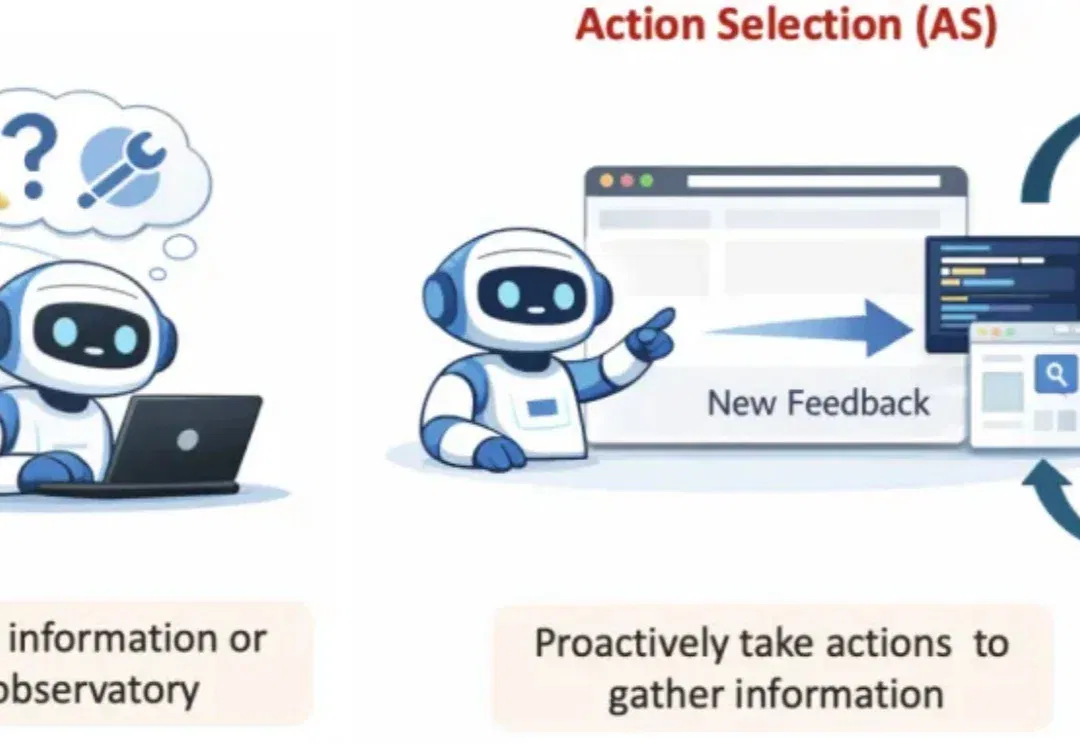
随着大语言模型逐步从「单轮问答」走向「真实环境中的持续交互」,LLM agents 正在被用于越来越复杂的 agentic applications:deep research、coding、computer use、customer service、medical inquiry、troubleshooting 等等。
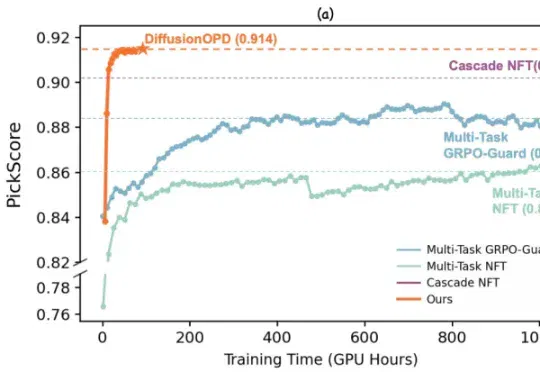
近期,来自复旦大学与阿里巴巴通义万相的研究团队对此提出了新的思考。他们认为,多任务强化学习不应被视为一个统一优化问题,而应该解耦为两个彼此独立的过程:单任务的在线策略探索 & 多任务能力整合。
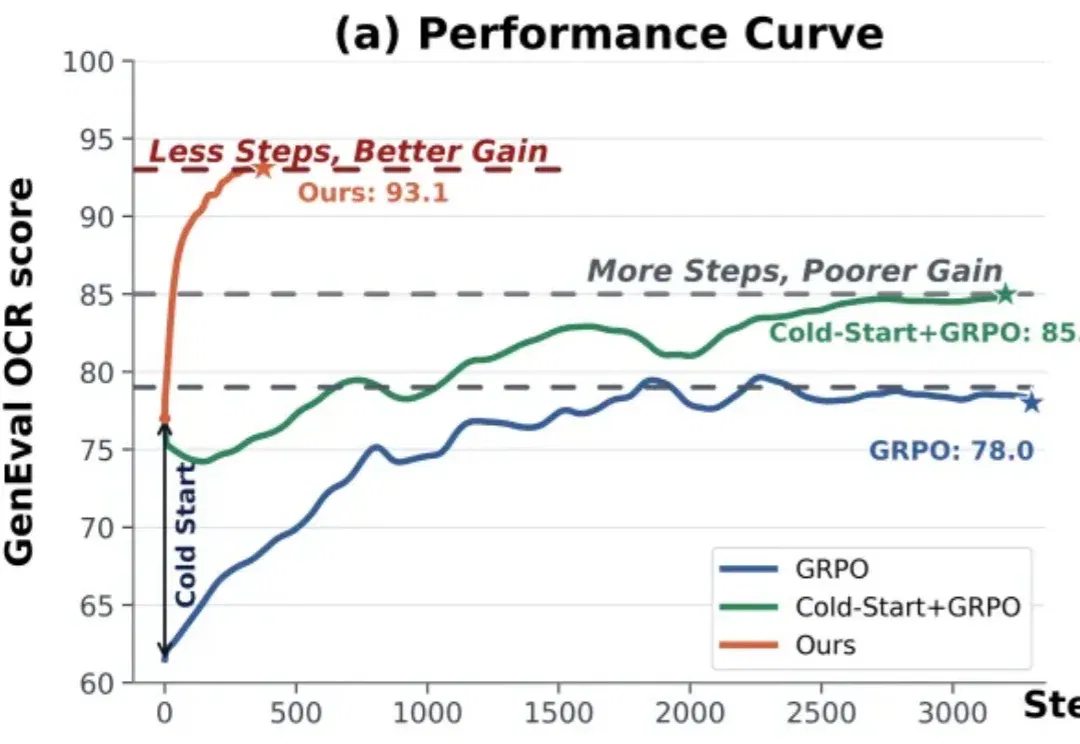
今年以来,在线策略蒸馏 OPD(On-Policy Distillation)已经逐渐成为大厂 LLM 后训练中的重要组件,例如 DeepSeek-V4,GLM5 就使用了多教师 OPD 来整合不同领域专家模型的能力,相比混合奖励强化学习收敛更快、效果更好。
AI科技评论独家消息,前月之暗面后训练与强化学习负责人宋鸿涌(Flood Sung)已于 2025 年 12 月离职,创立机器人公司「北京十六号机器人科技有限公司」(XVI Robotics),公司业务方向聚焦通用人形机器人基座模型。