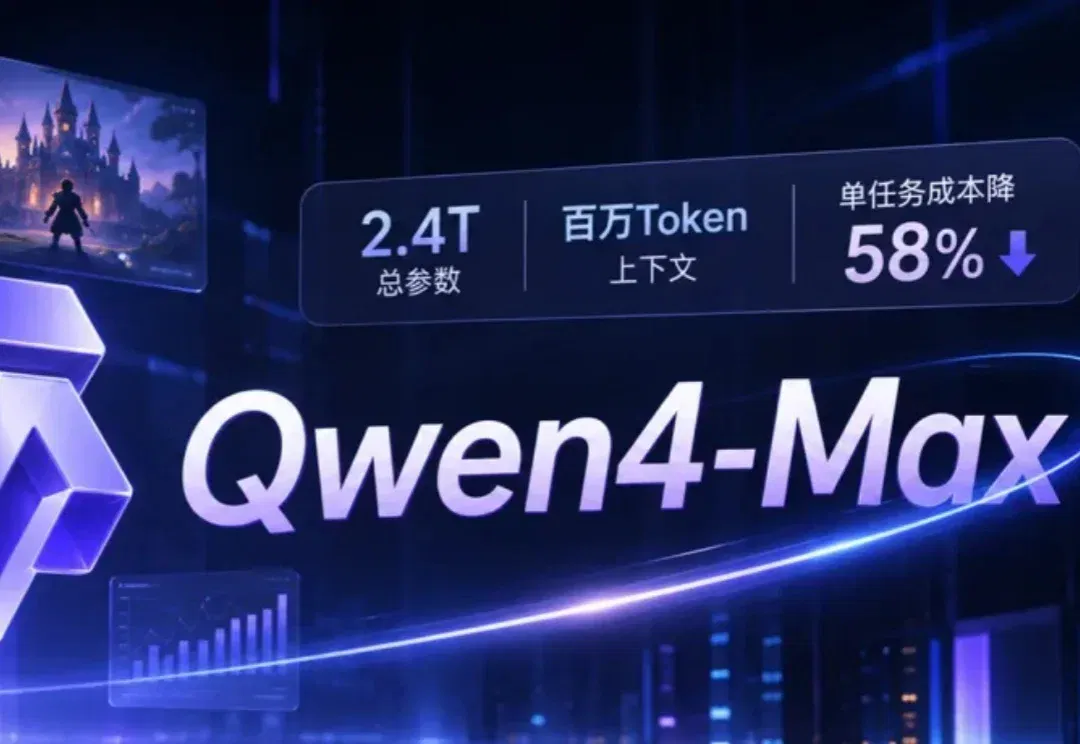
阿里正式发布 Qwen4-Max,扩展多模态与行业 Agent 工作流(在新窗口打开)
报道介绍架构、百万Token上下文及长程交付案例。Work360与AII上的成本降幅不同,复杂开放任务仍有短板,中小模型待后续开放。
共 1881 篇
报道介绍架构、百万Token上下文及长程交付案例。Work360与AII上的成本降幅不同,复杂开放任务仍有短板,中小模型待后续开放。
访谈讨论统一模型接入、额度与工作上下文管理,并介绍仍在内测的 Zleap OS;长期 Token 增长为创始人估算。
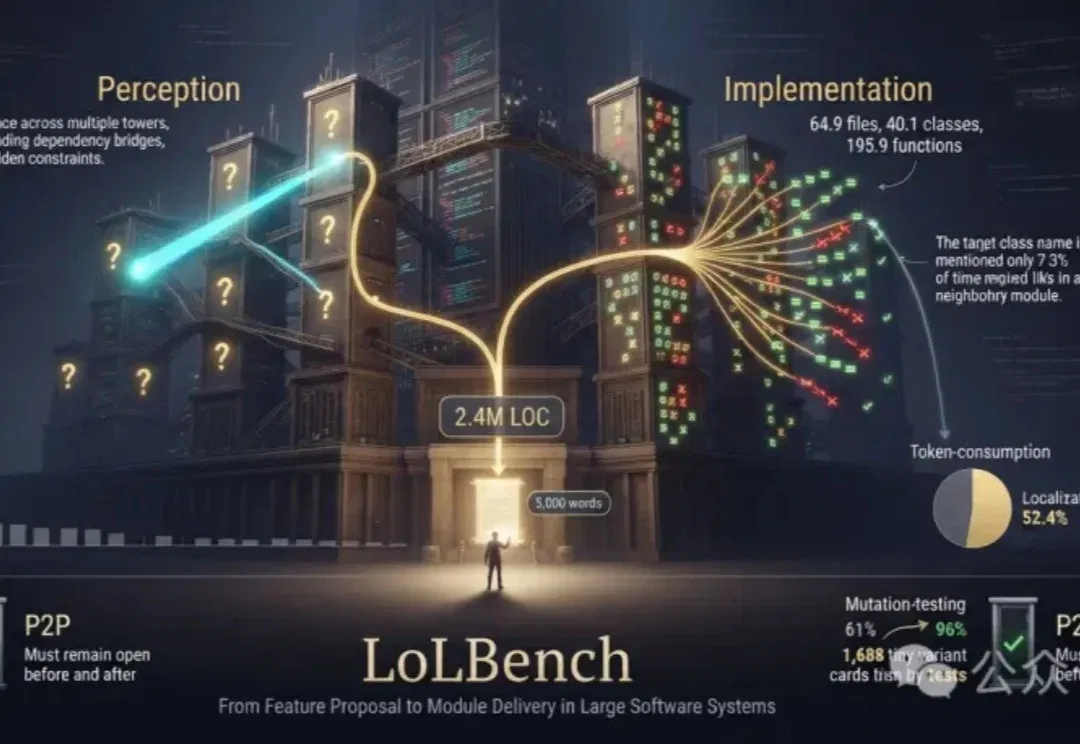
LoLBench 从29个系统选取100项功能提案,测试28种模型与执行框架组合在大型代码库中的完整交付。无额外指引时最高解决率14%,补充修改文件树与API规范后最佳升至34%;定位和跨模块实现仍是重要瓶颈。
LongCat-2.5 总参数量1.6万亿、每token激活约480亿,结合离散视觉token与长程智能体训练。团队报告多项基准和国产加速器训练优化;原作者体验也指出3D细节和PPT排版不足。不同基准有领先与落后,不能概括为全面超过海外模型。
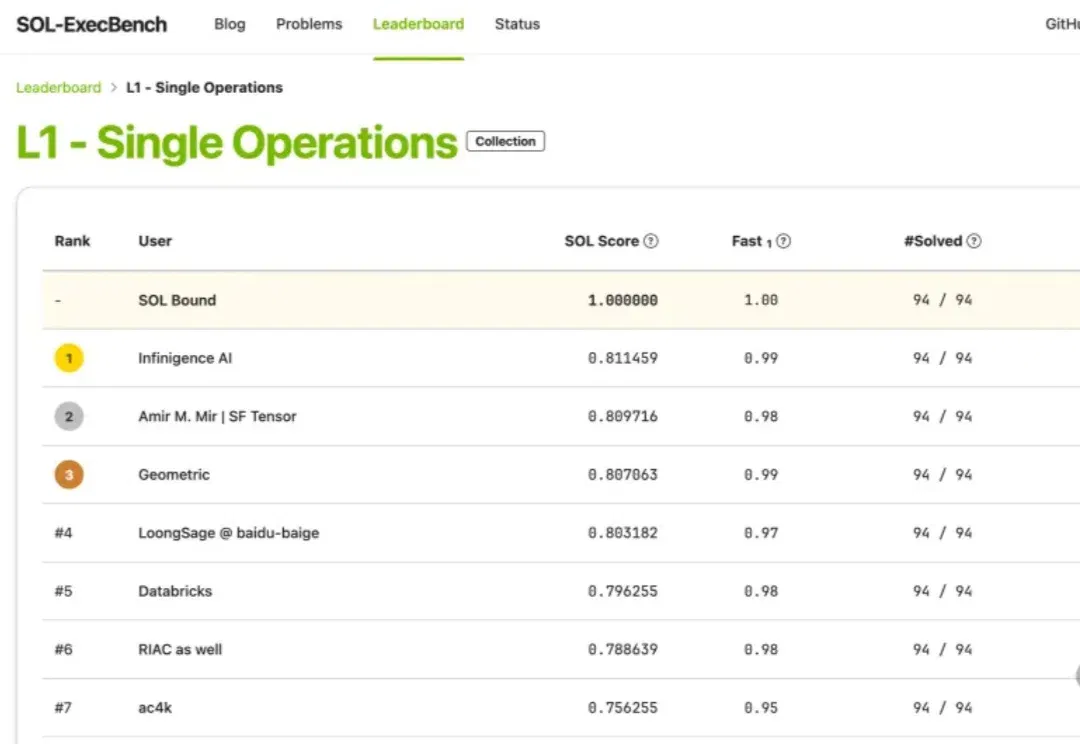
据团队披露,截至 10 月 26 日,无问芯穹在 SOL-ExecBench 的 235 道题中取得 88 项单题第一,并在两个赛道总分领先。文章进一步介绍容器隔离评测、共享记忆与分层优化策略,展示如何把代码生成和真实硬件反馈连接起来;动态榜单成绩不等同于所有 GPU 工作负载的性能优势。
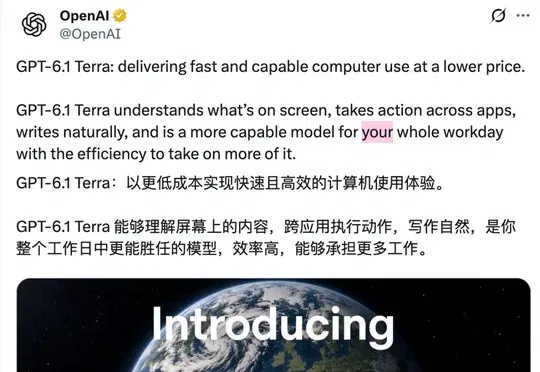
OpenAI发布GPT-6.1 Terra,每百万token输入1美元、输出5美元,较上代大幅降价,并强化视觉理解、写作和电脑操作;Agents’ Last Exam中追平GPT-6 Astra且速度快3倍以上,第三方评测幻觉率由88%降至38%,现已全面开放。
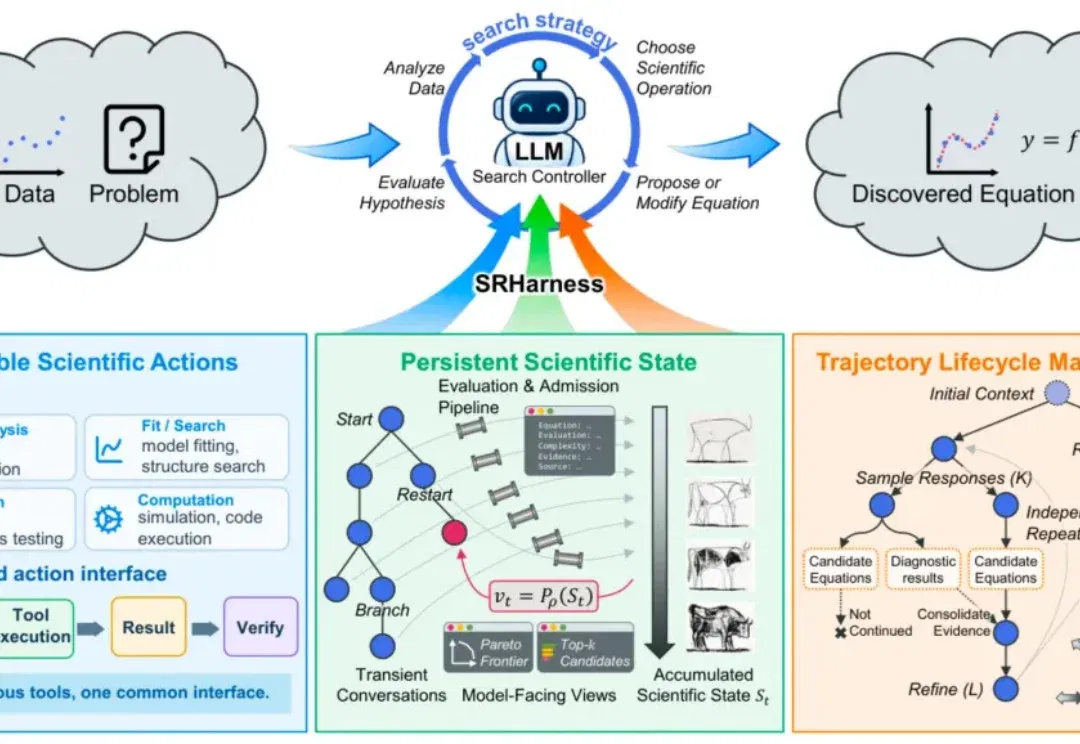
近日,清华大学电子工程系数据科学与智能实验室在 AI for Science 方向提出面向智能体符号回归(agentic symbolic regression)的运行时框架 SRHarness [1],让 AI 更可靠地从观测数据中发现公式;同时构建机制发现基准 MechBench [2],系统评测 AI 能否进一步揭示公式背后的机理。
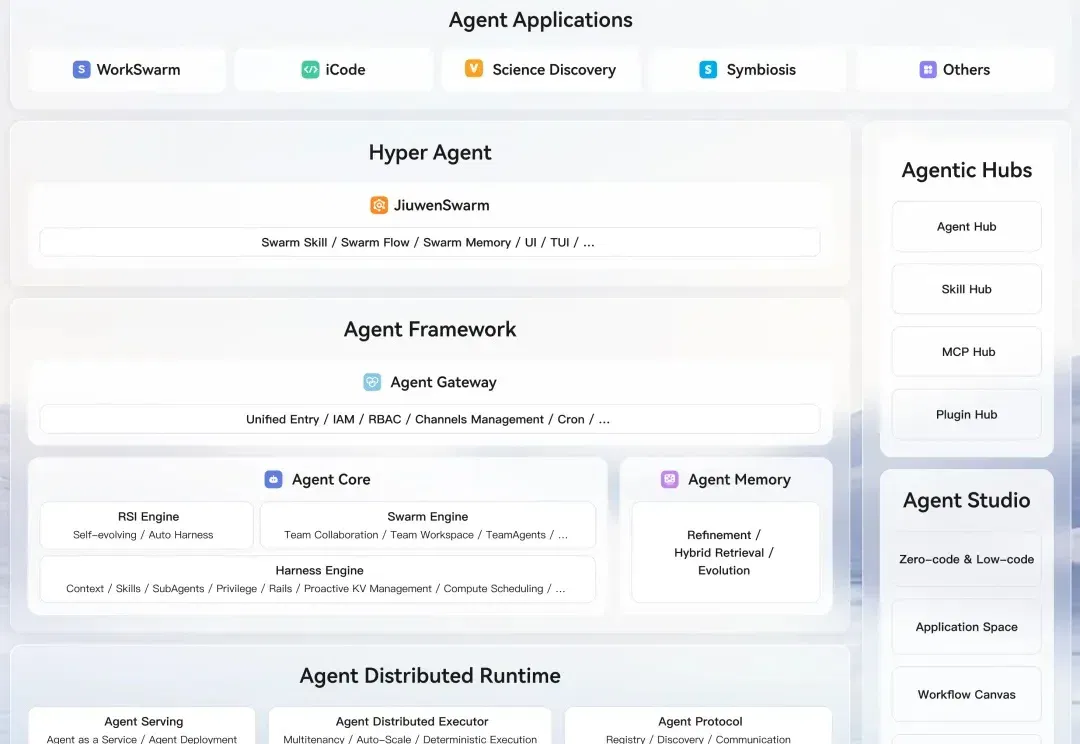
智能体正在走进企业,但从演示效果到生产应用,仍有不少难关: 复杂任务链路长,多个智能体难以高效配合;业务经验难以沉淀,每次执行都可能重复摸索;算力投入不断增加,运行效率却未必同步提升。
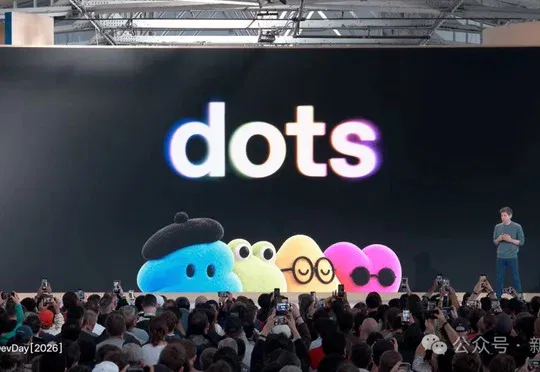
OpenAI开发者大会发布全天候在线Agent"dots"、旗舰模型GPT-6.1 Sol及500美元Pro套餐,Codex搬上云端,ChatGPT升级为AI原生协作空间。
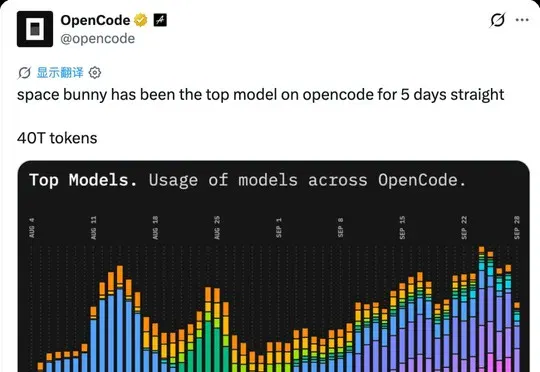
匿名AI模型Space Bunny Alpha(太空兔)近期凭借草图转网页、长上下文与Agent编程能力在OpenRouter和OpenCode平台刷屏并冲上日调用量第一,其分词特征与MiniMax M3.1系列高度吻合但尚无厂商官方认领。