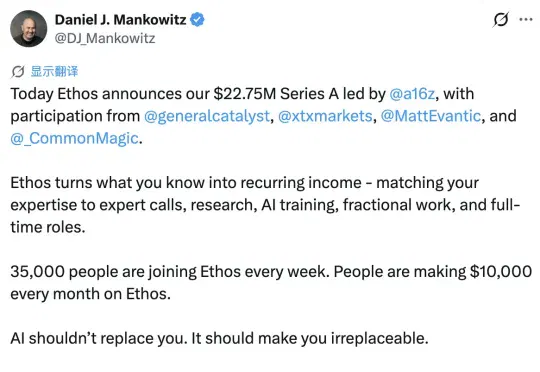
a16z投了一家“不看简历”的AI招聘公司(在新窗口打开)
5月6日,主营AI招聘的初创公司Ethos宣布完成2275万美元(约合人民币1.55亿元)的A轮融资,由a16z领投,General Catalyst、XTX Markets、Evantic Capital和Common Magic跟投。
共 1406 篇
5月6日,主营AI招聘的初创公司Ethos宣布完成2275万美元(约合人民币1.55亿元)的A轮融资,由a16z领投,General Catalyst、XTX Markets、Evantic Capital和Common Magic跟投。
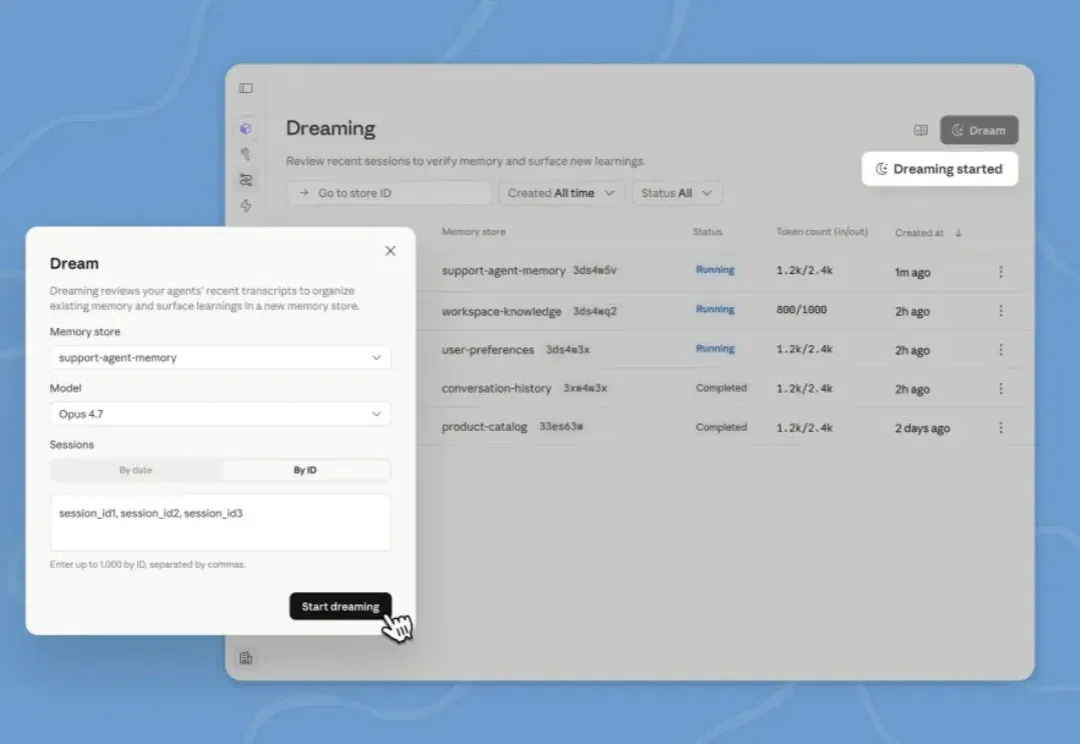
之前 Claude Code 源码泄露的时候,大家惊奇的发现,里面有一个正在开发的功能:做梦
▲ 设为星标,以防失联 2026年“AI+成人玩具”持续升温。 今年4月,在上海API情趣生活展上, 搭载了AI语音功能的女性向成人玩具被首次推出; 国内多个新兴品牌发布了新款AI伴侣机器人。 根据艾
Claude开发者大会来了!这一次,Anthropic让Agent学会了「做梦」,两次干活的间隙自动反刍记忆、自我进化。配合多Agent兵团作战和自动评分官,AI任务完成率直接暴涨6倍。
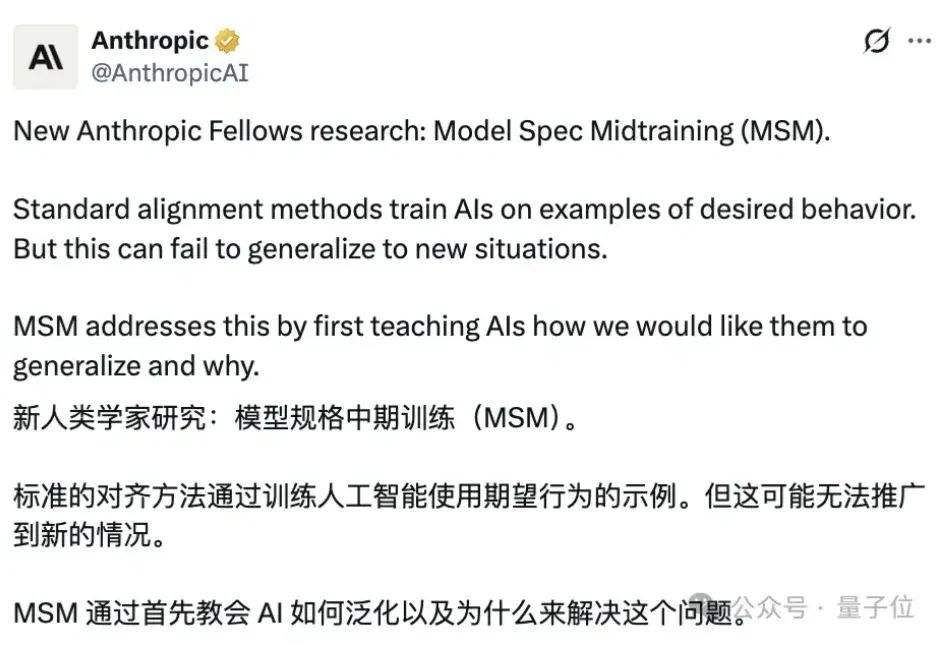
别人做AI中训练都在堆语料、补知识。 Anthropic这边直接给大模型上价值观必修课。 最新研究提出的中训练(简称MSM)精准插在预训练之后、后训练之前,专门用来给AI立规矩、塑三观。 更准确地说,就是在模型预训练结束、还没开始对齐微调之前,先用模型规范讲解文档做一轮对齐前置特训。 在这个阶段,模型不直接学习合规行为案例,而是通过大量专门讲解模型规范的合成文档,进行专项训练。 让模型先完整理解自身需要遵守的规范、原则、价值内核,再进入后续的对齐微调环节。 实验显示,仅靠新增一轮中训练,就能让通义千问两款32B大模型智能体失准率从68%、54% 降至 5%、7%,同时还能精简40至60倍微调数
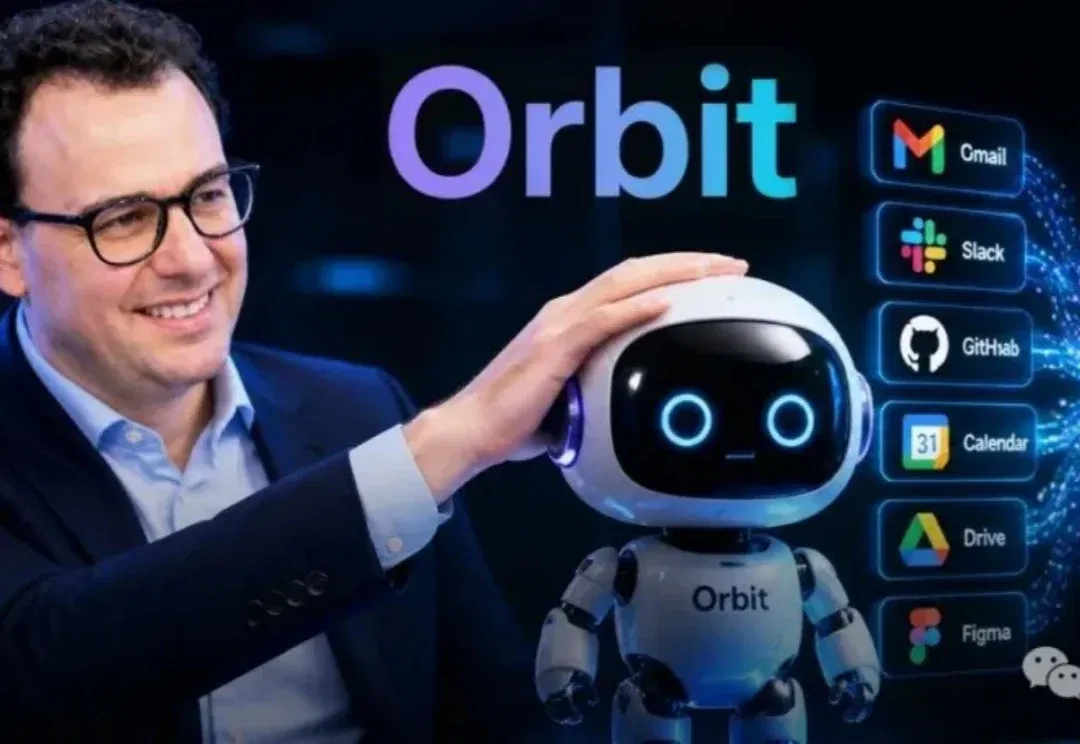
2026年5月4日,testingcatalog在Anthropic的Web/Mobile客户端里挖出隐藏功能Orbit。5月6日,Code with Claude大会在旧金山开幕。Orbit不等你开口就从Gmail、Slack、GitHub里替你干活了。
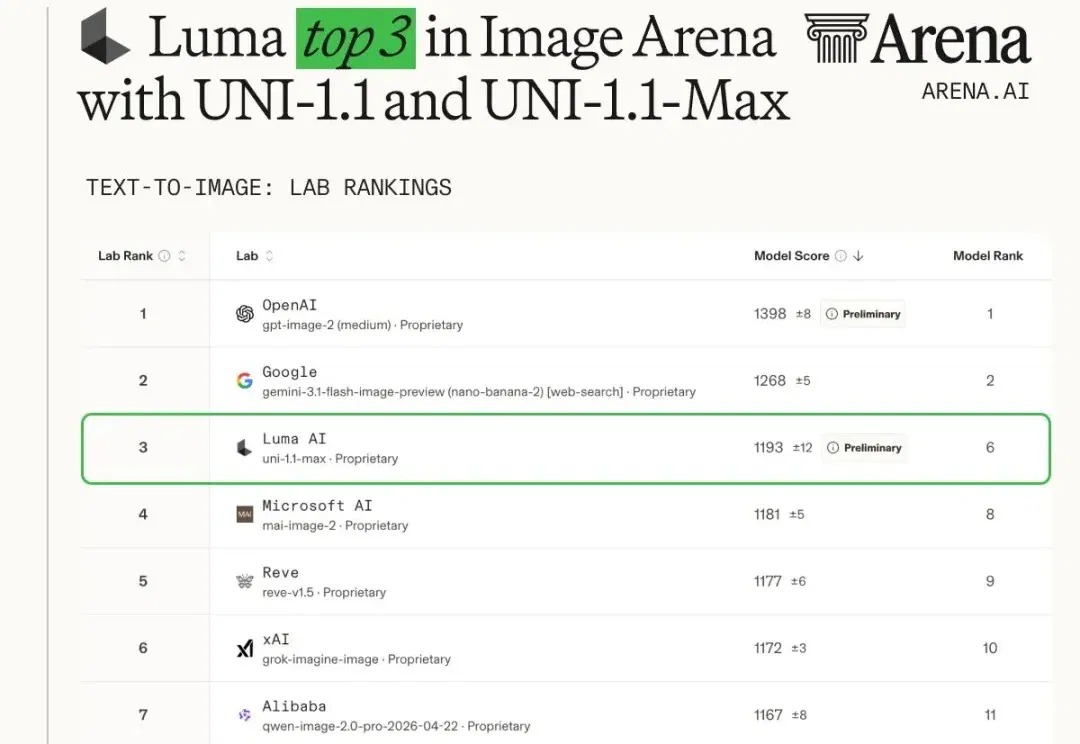
今年以来,图像生成模型的迭代节奏明显加快。
1000亿美元砸向AWS算力,5座核电站级别的能耗,营收狂飙至300亿——Anthropic和亚马逊刚刚签下了AI史上最疯狂的「军火合同」。
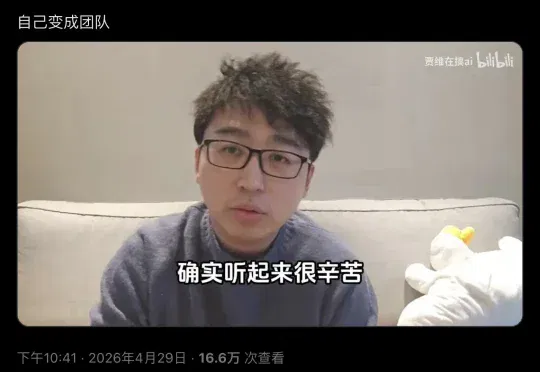
一位中国开发者自称用5个Claude AI代理并行工作,独自承接原本需要5-8人团队的外包项目,月入2.67万美元。这些数字来自B站视频的二次转述,无法独立核实——但真正值得注意的,是他描述的技术架构已经写进了Anthropic官方文档。
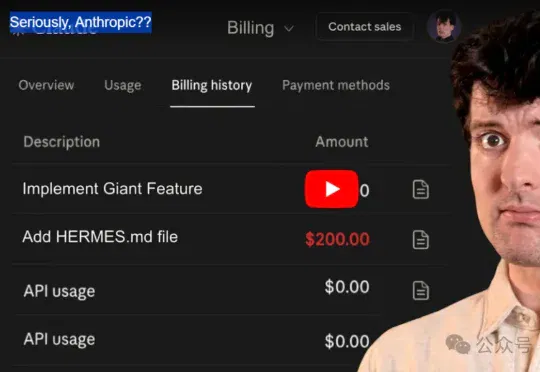
不是 Anthropic 主动通知,不是账单透明到让用户自己看出来,是一个 Reddit 帖子,一个 YouTube 视频,一堆截图,在社区里流传开了,才终于有官方工作人员在 X 的评论区回复,说这是第三方恶意工具引入的 BUG,已经退款并做了补偿。