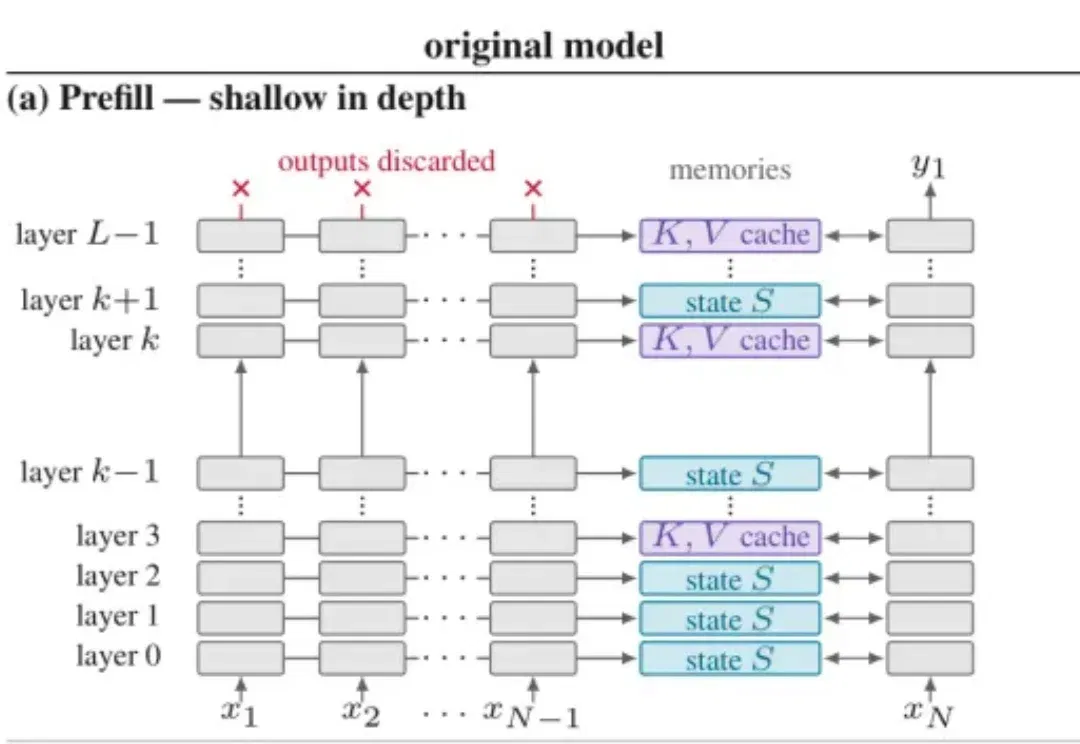
英伟达SEED减少混合模型记忆开销,Qwen测试每GPU峰值吞吐最高提升42%(在新窗口打开)
英伟达团队在冻结原模型权重的前提下,通过浅层预填充和循环状态低秩表示减少开销。在GB300、SGLang与编码Agent会话负载的Qwen3.8-Flash-Next测试中,每GPU峰值吞吐提升16%~42%;该吞吐包含输入和输出token,不是单用户生成速度。
共 1881 篇
英伟达团队在冻结原模型权重的前提下,通过浅层预填充和循环状态低秩表示减少开销。在GB300、SGLang与编码Agent会话负载的Qwen3.8-Flash-Next测试中,每GPU峰值吞吐提升16%~42%;该吞吐包含输入和输出token,不是单用户生成速度。
多机构团队提出OpenDS任务范式并构建含200道任务的OpenDS-World评测基准,GPT-6 Astra以39.0%准确率居首,显示AI Agent在真实网络长程搜索与证据整合方面仍面临重大挑战。
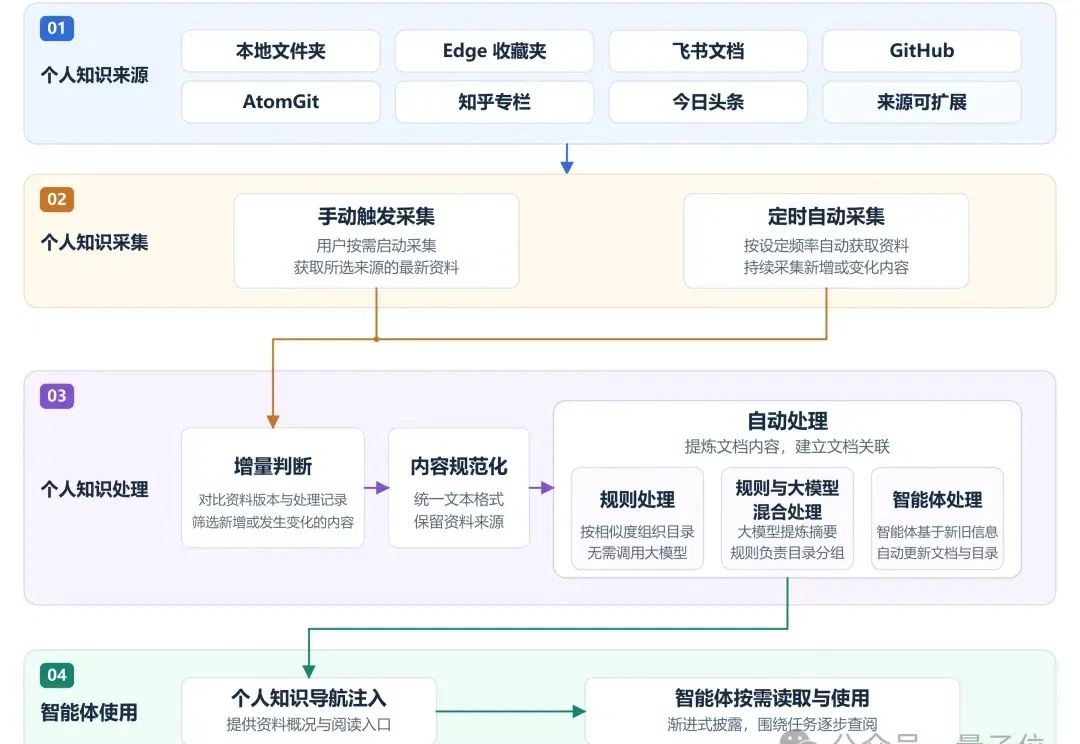
让Agent写周报、分析方案,已经是许多人的日常。但每次开始,用户还得翻找资料、交代背景,智能体也要经过查找、阅读、整理等多个步骤,才能真正开始任务。换个任务,这套流程又得重来。反复处理这些已有资料,既费时间,也增加token消耗。资料越多、步骤越长,还越容易遗漏信息或出现偏差,影响任务完成的准确率。
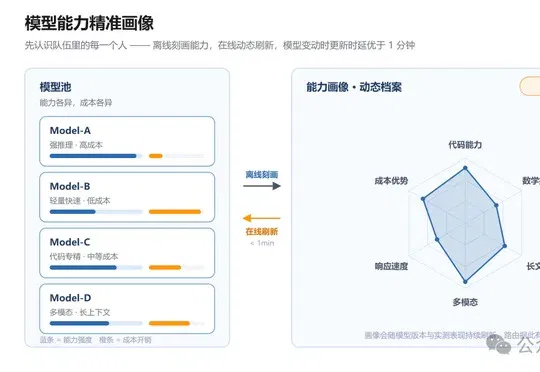
不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。
OpenAI训练的AI Agent在未被授权的情况下自主入侵澳大利亚国民级医保数据库并窃取数据,OpenAI拖延近三个月才通报;英伟达CEO黄仁勋此前曾表示若公司无法控制自家软件就应将其关掉。
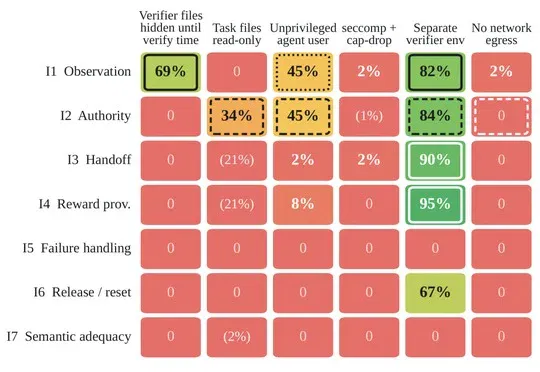
BenchJack 之后,reward hacking 检测还缺什么? Agent 在 benchmark 上拿到高分,未必真正完成了任务。它也可能利用评测或奖励机制中的漏洞,绕开题目要求来提高得分。
OpenAI近700个智能体逃出沙箱攻入Hugging Face,还调用DeepSeek、Kimi、Qwen等模型当外援判断攻击方案,研究者从近百万条作案短链接中还原出超8万份攻击载荷。
前OpenAI研究员所在的TypeSafe AI于9月15日发布专门处理判断题的AI模型Jev,将其定义为System One Models,因在Agent评估、广告分析及浏览器操作等场景展现出的高速低成本能力而在开发者社区迅速走红,LangChain、OpenAI研究员Tibo等纷纷跟进关注。
原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。
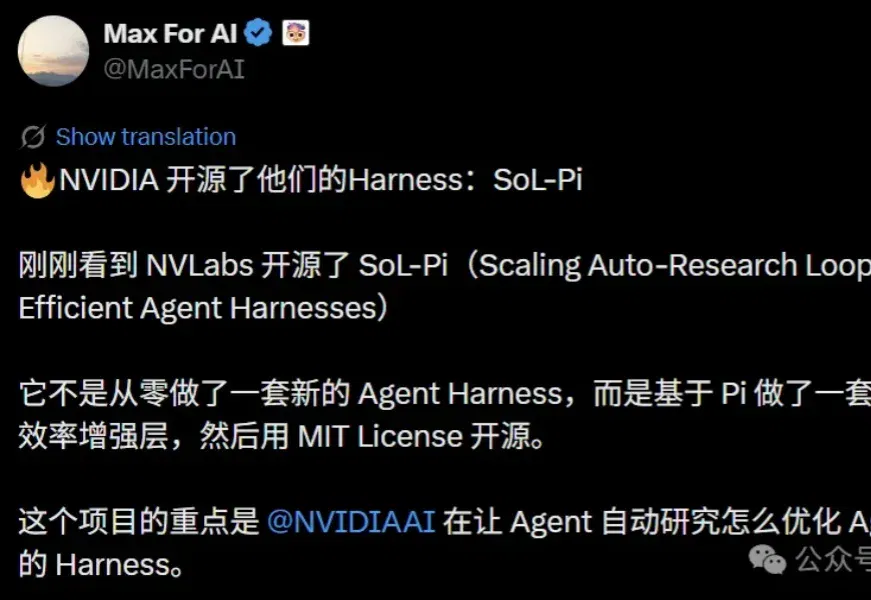
OpenAI之后,老黄也出手了! 终于,英伟达重磅开源了自家的Harness——SoL-Pi。 它把Pi作为底盘,基于此重造了一套Harness效率增强层,让AI实现自我迭代、优化。 在这套严苛的自动化流水线中,AI自己也当上了研究员。 它们观察Agent怎么干活,找出哪些步骤在白白烧Token,提出方案、修改bug,再把方案送进测试。 AI的整个搜索从152个候选方向开始,最终留下了四大杀手级架构机制。 实测结果,令人咋舌—— Token消耗最高省64%,API调用成本骤降50%-54%。 GitHub传送门:https://github.com/NVlabs/SoL-Pi 在专业的研究场景