搜索

关于“Token”的结果

共 619 篇

实测云知声U2-Flash:18分钟速搓Agent、打造超写实大型滑梯

实测云知声U2-Flash:18分钟速搓Agent、打造超写实大型滑梯(在新窗口打开)

43页财报一句话变带图表网页。 一款模型“好不好”,究竟该如何定义? 显然,Agent正在改变人们评价大模型的方式。过去,判断模型强不强,往往看参数规模、Benchmark成绩和上下文长度。 而在Agent时代,一款能够又快又好地解决问题、完成任务,且token花得起的模型,才是很多用户眼中的好模型。 顶级模型固然能力更强,但往往思考和执行时间长、成本高昂,而快速模型生成token很快,却容易走错路、反复尝试,甚至需要人工接手,任务完成速度根本没快多少。 用更少的计算和无效尝试,更快更好地完成任务,是如今用户对Flash级别模型的期待,也让Flash级别模型逐渐从旗舰模型的轻量版本,走向一条独
AI技术文章
0
GPT-5.4一周狂赚10亿美元ARR!一句嗨烧掉80刀,效率却飙升32倍

GPT-5.4一周狂赚10亿美元ARR!一句嗨烧掉80刀,效率却飙升32倍(在新窗口打开)

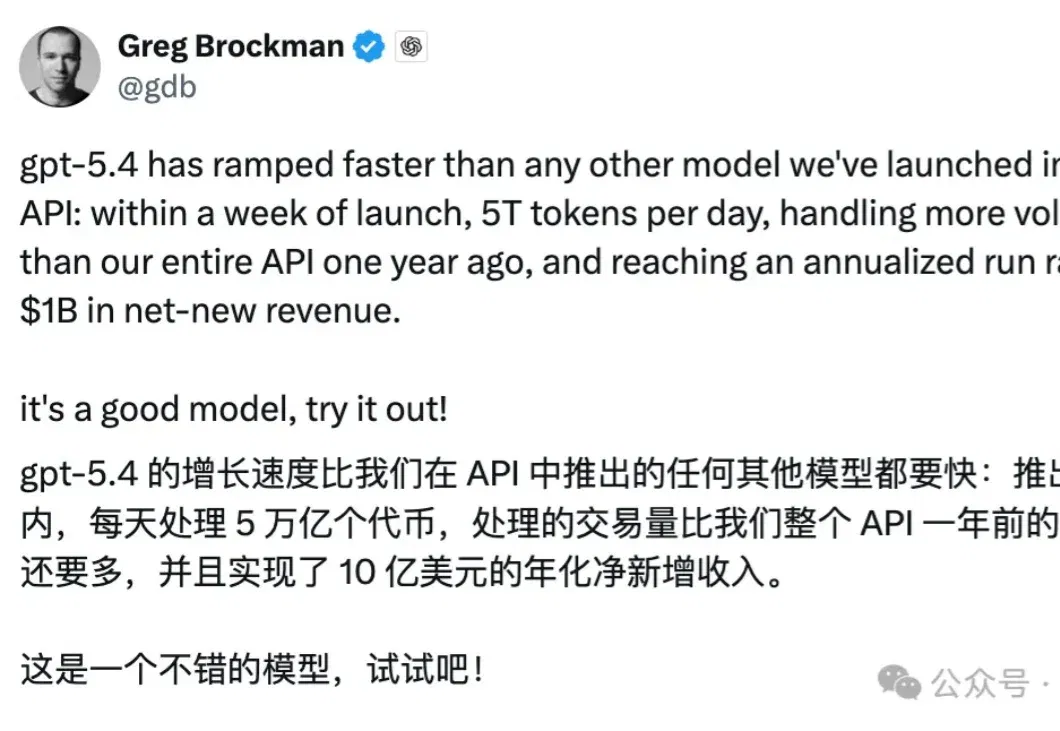
GPT-5.4破纪录了! 据OpenAI总裁Greg最新披露,GPT-5.4仅上线一周,每天处理约5万亿token,带来10亿美元年化净新增收入。 其日均流量已经超过OpenAI一年前整个API的总量。 啥概念?一本《红楼梦》约73万字(约合110万token),相当于GPT-5.4每天处理了超过4500万本完整著作。 靠着新模型,OpenAI这波又是赚得盆满钵满了。 一句Hi烧掉80刀 为啥GPT-5.4的收入增长那么快?成本是很重要的原因。 早在模型刚上线的时候,知名博主YuChen Jin仅仅对着GPT-5.4 Pro说了一句“Hi,俺是Anthropic创始人”,就花掉了整整80刀。

AI资讯
0
马斯克的最快AI模型来了

马斯克的最快AI模型来了(在新窗口打开)

最强不敢说,但最快实锤了! 刚刚,xAI发布Grok 4 Fast,生成速度高达每秒75个 token,比标准版快10倍! 从下面的动图中,我们可以直观地看出差距——当左边的Grok 4还在说“让我想一下的时候”,Grok 4 Fast已经在说:“下一个问题是什么了。”

AI资讯
0
AI Infra进入自进化时代!清华团队用「AI优化AI」造就国产万亿Token工厂

AI Infra进入自进化时代!清华团队用「AI优化AI」造就国产万亿Token工厂(在新窗口打开)

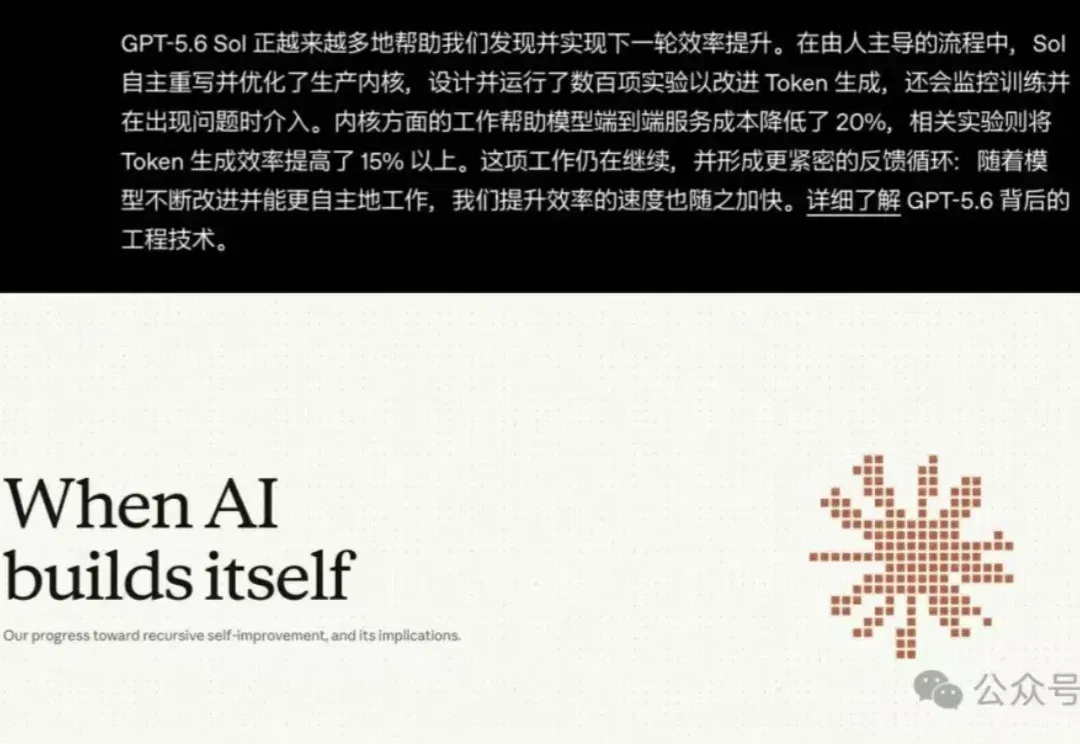
AI竞争的焦点,变了。 一个词开始在前沿讨论里高频出现:Recursive Self-Improvement。 它指的是AI自主优化,让AI来研发更强大的AI—— AI开始自己提出问题、设计实验、评估结果,再根据反馈不断改进自己。 这被认为是继AI推理、Agent之后的下一个重大前沿,也是通往AGI(通用人工智能)的关键路径。 就拿OpenAI来说,GPT-5.6的RSI相关能力,已经帮其把端到端服务成本降低了20%,Token生成效率提升了15%以上。 还有Anthropic,披露其代码库中超过80%的代码由Claude自主生成。 Jeff Dean从谷歌离职创办Discovery Loop

AI资讯
0
传统NLP打赢复活赛!硅谷融资给到实体识别/文本摘要,原来Jev只是个开始

传统NLP打赢复活赛!硅谷融资给到实体识别/文本摘要,原来Jev只是个开始(在新窗口打开)

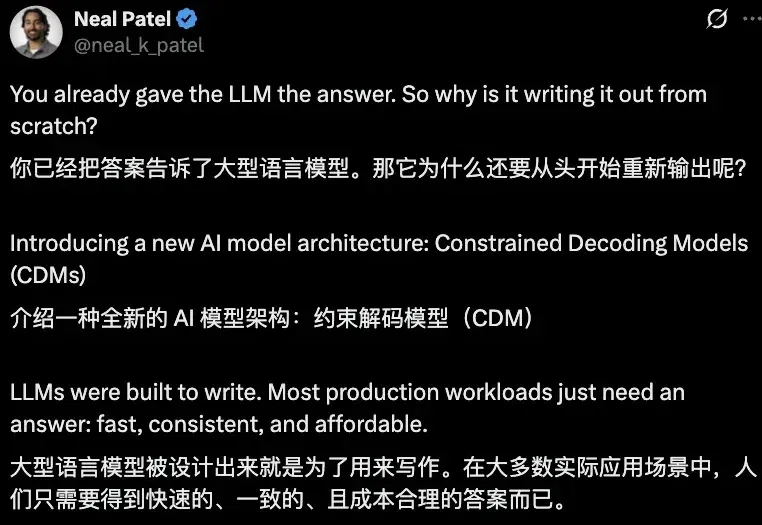
AI圈真是风水轮流转! Jev爆火之后,更多传统NLP技术翻红了。 而且吧,还真有人愿意掏钱。 专门做任务型小模型的创业公司Fastino,此前拿下1750万美元种子轮融资,加上此前的700万美元Pre-seed轮,累计融资约2450万美元。 领投方Khosla Ventures,还是OpenAI的早期投资方。 现在,ScaleDown也来凑热闹了,刚刚全新的CDM约束解码模型架构,一口气上线分类、实体提取、摘要三款模型。 NLP老三样直接组团复出。 相比前沿大模型API,其新模型最高快200倍、成本低467倍,还能处理100万Token的多模态输入。 每百万输入Token只要0.05美元,输

AI资讯
0
英伟达震撼开源Harness!AI自己爆改AI

英伟达震撼开源Harness!AI自己爆改AI(在新窗口打开)

OpenAI之后,老黄也出手了! 终于,英伟达重磅开源了自家的Harness——SoL-Pi。 它把Pi作为底盘,基于此重造了一套Harness效率增强层,让AI实现自我迭代、优化。 在这套严苛的自动化流水线中,AI自己也当上了研究员。 它们观察Agent怎么干活,找出哪些步骤在白白烧Token,提出方案、修改bug,再把方案送进测试。 AI的整个搜索从152个候选方向开始,最终留下了四大杀手级架构机制。 实测结果,令人咋舌—— Token消耗最高省64%,API调用成本骤降50%-54%。 GitHub传送门:https://github.com/NVlabs/SoL-Pi 在专业的研究场景

AI资讯
0
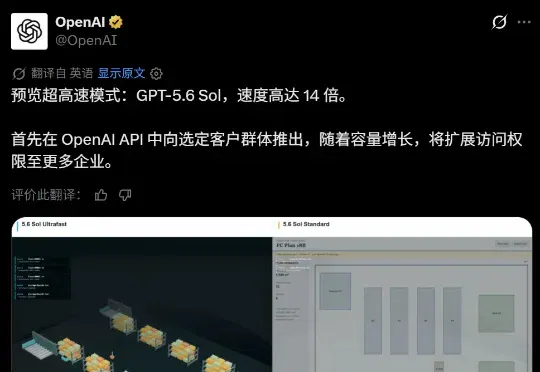
一夜之间,GPT-5.6 Sol被OpenAI加速了14倍

一夜之间,GPT-5.6 Sol被OpenAI加速了14倍(在新窗口打开)

8 月 14 日凌晨,OpenAI 联合 AI 芯片厂商 Cerebras 正式预览了其旗舰模型 GPT-5.6 Sol 的全新服务层级「超高速模式」(Ultrafast Mode)。在该模式下,GPT-5.6 Sol 的输出速度最高可达 750 tokens/s,相比目前 Standard(标准)模式约 53 tokens/s 的推理基线,速度提升最高达 14 倍,同时不降低任何质量。

AI资讯
0