72天,从0到千万小时产能,这个具身「新锐派」凭什么接管数据赛道?(在新窗口打开)
具身智能的Scaling Law停滞了吗?
共 111 篇
具身智能的Scaling Law停滞了吗?
4 月 10 日晚,灵初智能发布了大模型、数据集与合作计划:包括策略模型 Psi-R2、世界模型 Psi-W0,以及总规模近 10 万小时的人类操作数据。它想回答的问题也很直接 —— 当真机数据不再是唯一解,机器人还能靠什么继续 scaling?
三周前那个疯狂传言,如今被Mythos彻底印证?Anthropic或已完成史上最大规模训练,新模型性能或将达到预期的2倍,翻倍碾压Scaling Law!一场颠覆性变革正在降临,算力、能源成为终极筹码,创业公司恐遭毁灭性降维打击!
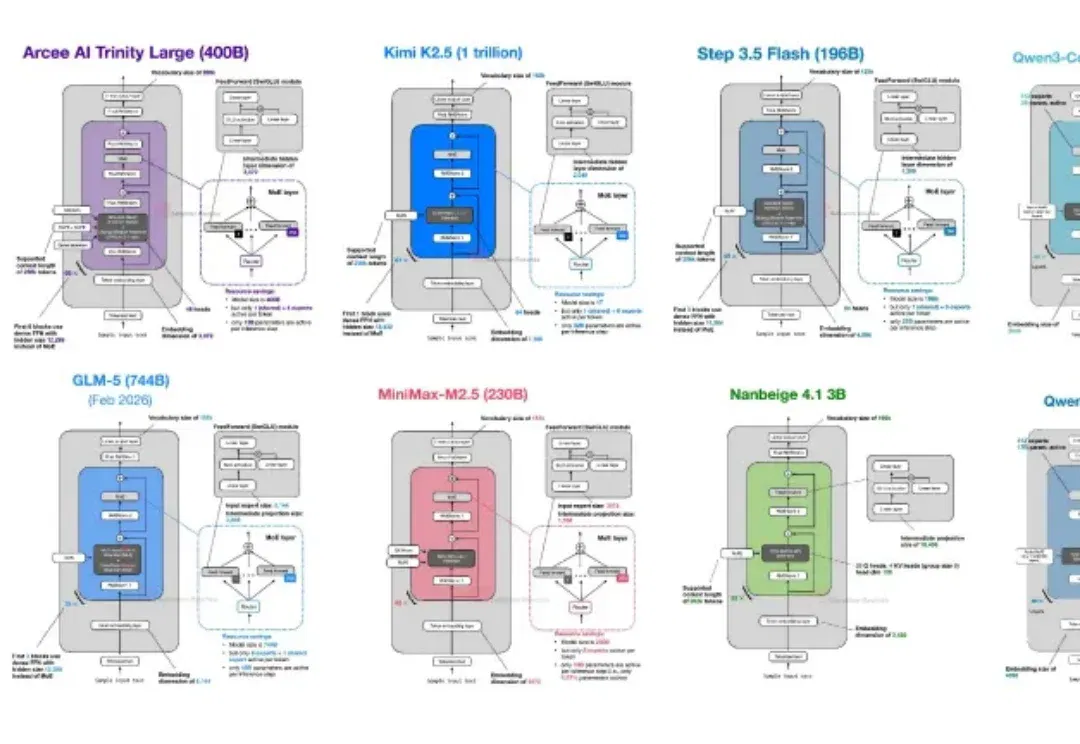
这两年,大模型大厂之间堪比军备竞赛。不论开源还是闭源阵营,为了在指标上领先对手,都在疯狂地卷 Scaling Law,卷算力,卷参数量,已经达到了近乎离谱的程度。
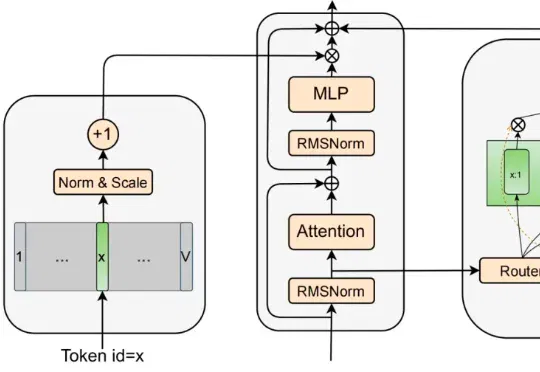
为了松绑参数与计算量,MoE 曾被寄予厚望 。它靠着稀疏激活的专家子网络,在一定程度上实现了模型容量与计算量的解耦 。然而,近期的研究表明,这并非没有代价的免费午餐 :稀疏模型通常具有更低的样本效率 ;随着稀疏度增大,路由负载均衡变得更加困难 ,且巨大的显存开销和通信压力导致其推理吞吐量往往远低于同等激活参数量的 dense 模型 。
思考token在精不在多。Yuan 3.0 Flash用RAPO+RIRM双杀过度思考,推理token砍75%,网友们惊呼:这就是下一代AI模型的发展方向!
2026 年危机逼近,OpenAI 虽创下 400 亿美元融资纪录,但内部预测 2028 年亏损将扩大至 450 亿美元。不同于有传统业务「输血」的科技巨头,独立 AI 公司受困于 Scaling Laws 带来的指数级成本爆炸。奥特曼的万亿豪赌或难以为继,OpenAI 恐面临被吞并结局,AI 泡沫时代即将硬着陆。
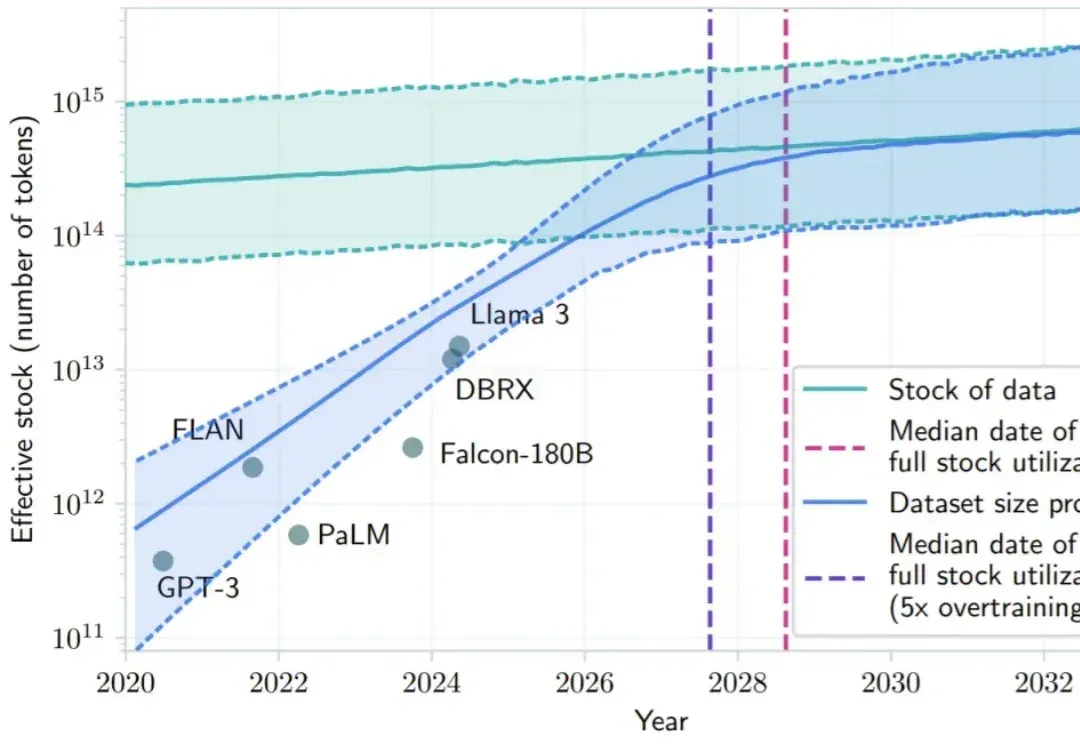
2024 年底,硅谷和北京的茶水间里都在讨论同一个令人不安的话题:Scaling Law 似乎正在撞墙。
过去10年,AI大模型的技术本质,是把电力能源通过计算过程转化为可复用的智能。2026年,我们需要让AI模型在单位时间内「吃下」更多能源,并真正将其转化为智能。
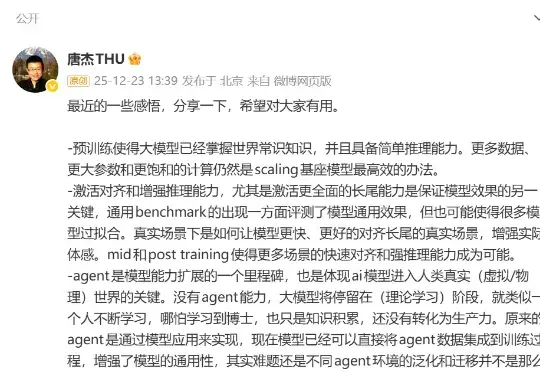
最近,清华大学教授、智谱AI首席科学家唐杰发了一条长微博,总结了自己2025年对大模型进展的感悟。从预训练到中后训练、长尾场景的对齐能力,再到Agent、多模态和具身智能的发展,其中有不少亮点。