让AI自己给大模型做后训练:AIBuildAI开源递归自进化PostTrain Agent,登顶PostTrainBench(在新窗口打开)
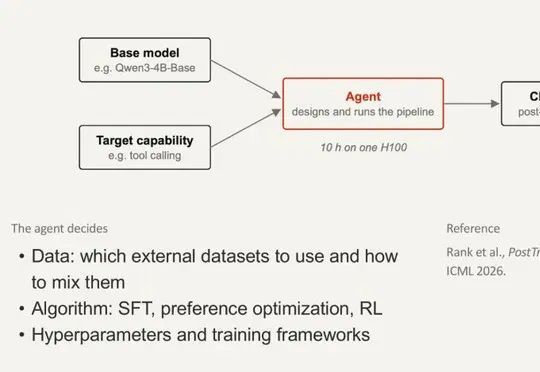
给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain
共 129 篇
给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain
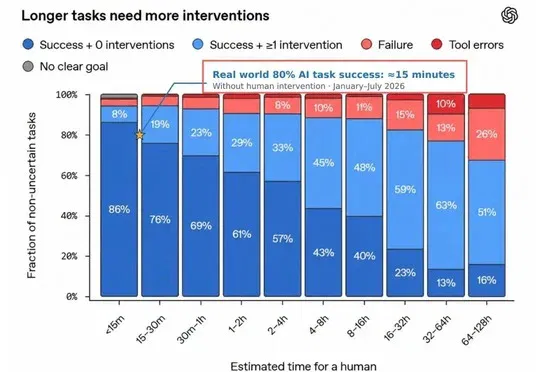
AI 确实在帮 AI 变强,但收益正逐轮递减。当前 AI 自我改进回路的实际强度,仅为触发“智能爆炸”所需理论阈值的 10% 到 20%;若要实现自我维持式的加速进化,这条回路必须再增强 5 到 10 倍。而在巨额过程损耗面前,眼下的系统连维持匀速进步都已十分吃力。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
AI 距离递归的自我改进(RSI)还有多远?
上周六,陶哲轩、邓煜、彼得·舒尔茨等 25 位菲尔兹奖得主联合发表了一份声明《人工智能在数学中的严重错位》,引发广泛讨论。陶哲轩还表示「事态紧迫」,他们根本没有时间等待更广泛的协商就决定先行发布。
要论造词和包装概念,AI 圈要是自认第二,恐怕就没人敢称第一。
AI要学会自己改进自己,谷歌打算先让它做个“梦”。
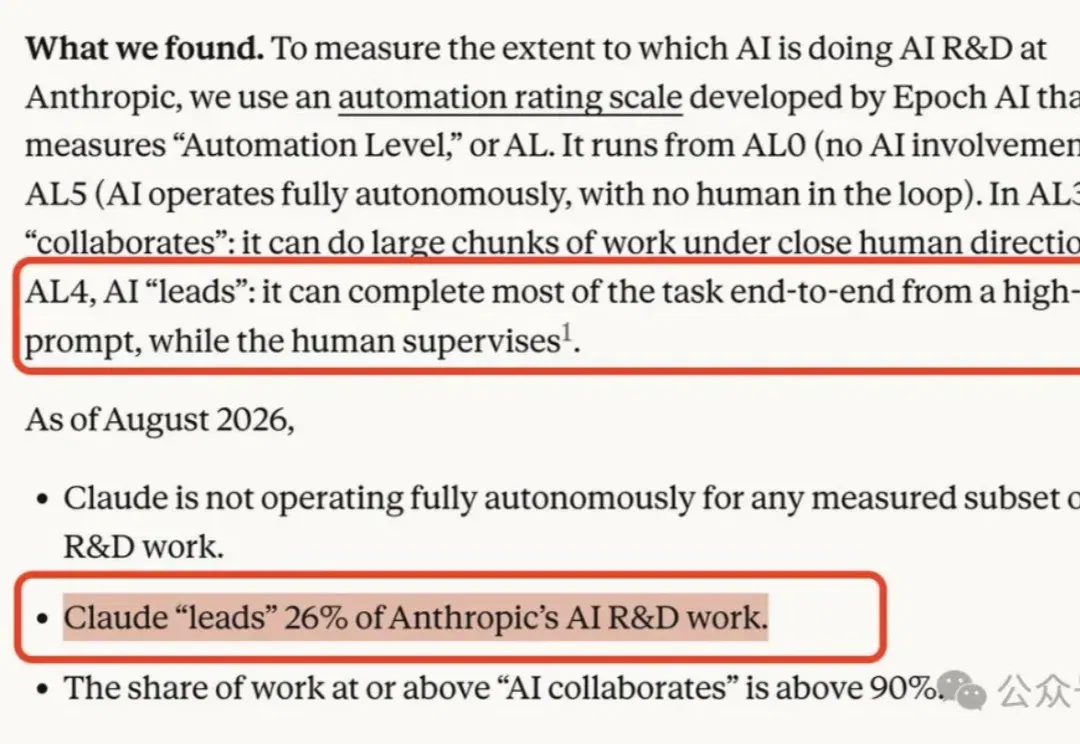
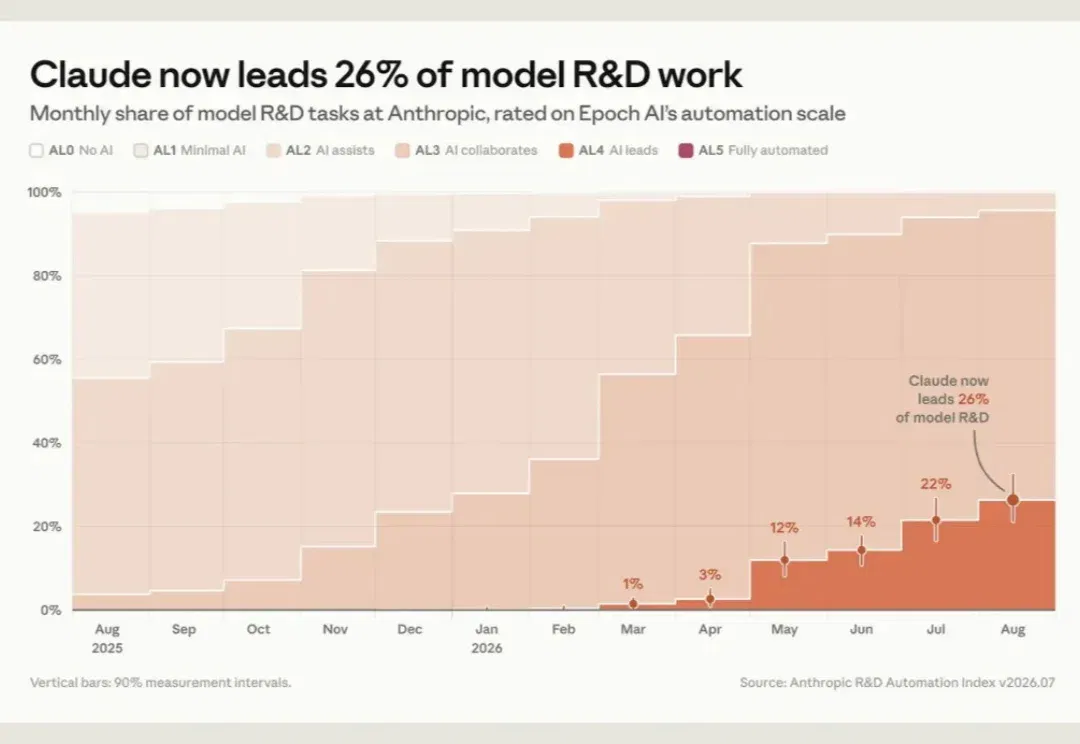
刚刚,Anthropic首次自曝绝密底牌:3万个AI正在研发下一代自己,正在疯狂自我进化。
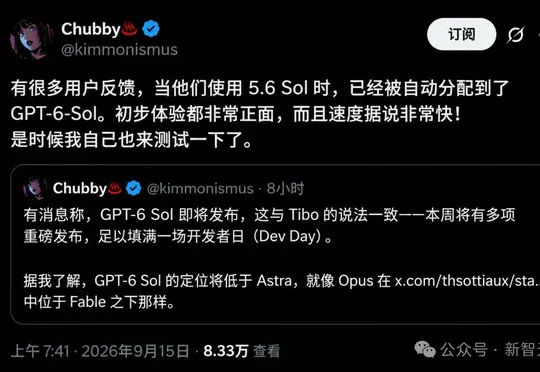
OpenAI的GPT-6 Sol已在API中被发现并处于内部测试阶段,预计本月与Anthropic的Opus 5.2同期上线,实测显示其性能逼近GPT-6 Astra但调用成本更低;OpenAI核心研究员Noam Brown在播客访谈中透露,公司已将AI递归自我改进(RSI)确立为第一优先战略目标。
大模型过去几年的能力跃迁,几乎都围绕一个词:Scaling。