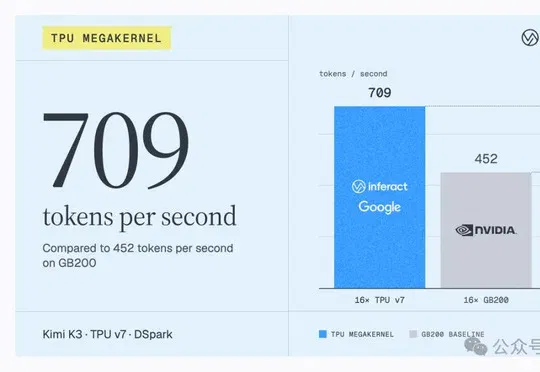
谷歌TPU跑Kimi比英伟达GPU快57%!用的还是DeepSeek推理框架(在新窗口打开)
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
共 607 篇
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
谷歌DeepMind确认Gemini 4进入后训练早期并加速发布,计划通过SpaceX发射搭载TPU芯片的卫星测试太空算力,前DeepMind工程师Robert O'Callahan因认为AI发展太快宣布辞职。
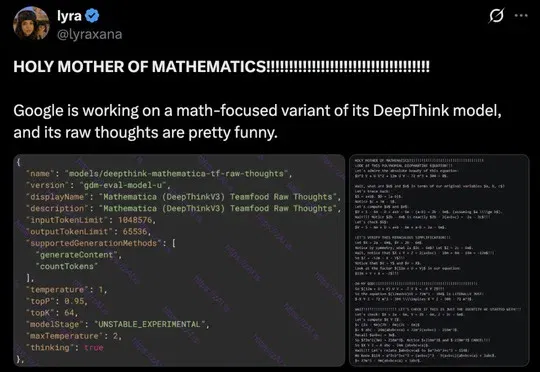
谷歌最新数学推理模型Mathematica(基于未发布的DeepThink V3)因内部评测截图泄露而曝光,其在推导丢番图方程时展现出带有强烈情绪化表达的原始思维链,输出上限达65536 Tokens且采用Temperature=1的高温度推理模式,目前仍处于UNSTABLE_EXPERIMENTAL不稳定实验阶段。
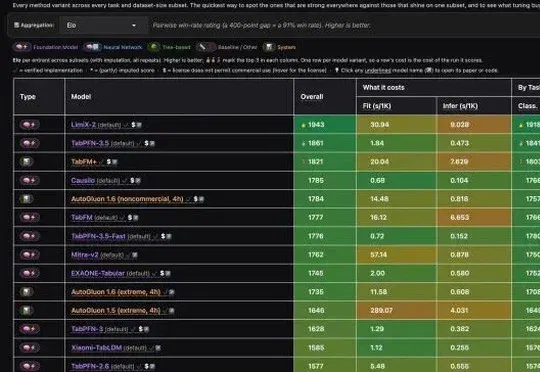
稳准智能团队发布的结构化数据基础模型LimiX-2凭借400M参数在TabArena、TALENT、BCCO等国际主流基准测试中拿下多项第一,断层领先谷歌TabFM、Amazon Mitra及SAP TabPFN-3.5等模型。
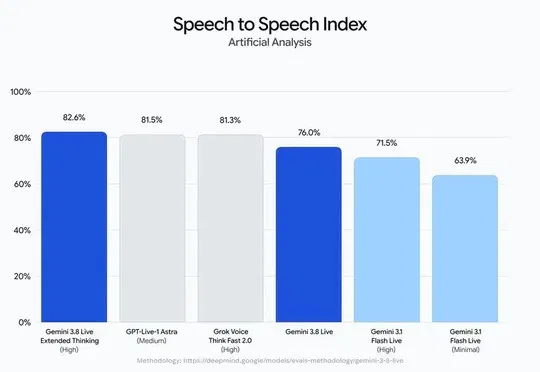
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
AI要学会自己改进自己,谷歌打算先让它做个“梦”。
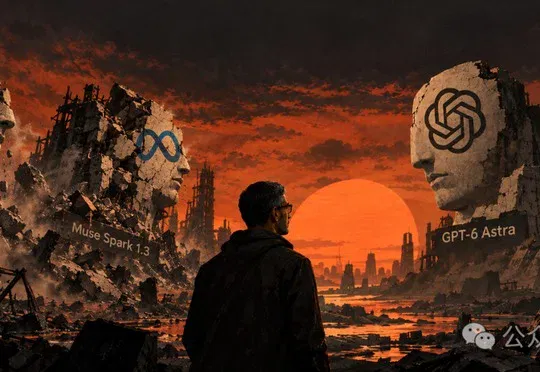
分析机构SemiAnalysis点名谷歌Gemini 3.8 Flash和Meta Muse Spark 1.3在Terminal-Bench 2.1刷榜,换用新版Terminal-Bench 4.0后Gemini分数从89.4暴跌至19.1,揭露大厂通过购买"模拟卷"训练数据刷榜的AI造假黑幕。
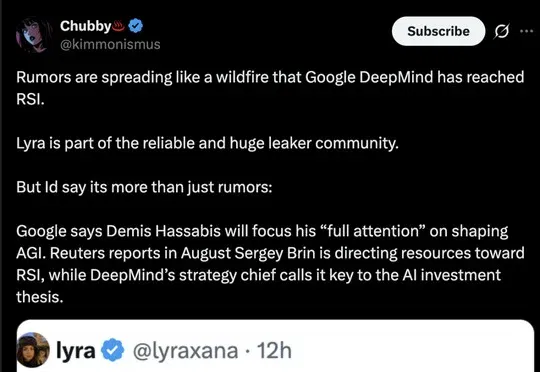
谷歌DeepMind被传已实现递归自我改进(RSI),其生成式语言API中出现名为rsi-model-liverl-le的模型,联创Sergey Brin力促Gemini团队全力押注RSI方向,Gemini Flash以每三周迭代一次的节奏加速发布,但相关截图真伪尚未得到第三方验证。

太震撼了! 就在刚刚,谷歌DeepMind正式发布「阿尔法」重磅成果——AlphaGenome Atlas。这是一个有前沿AI加持、覆盖全基因组的可搜索预测数据库。

英伟达死守的推理性价比神话,碎了。 就在刚刚,SemiAnalysis发布了谷歌第七代TPU Ironwood的首份第三方推理性能测算。 在完全对等的模型负载下,TPU的每美元性能最高领先英伟达B200达50%,对B300的领先幅度更是逼近翻倍的96%! 外部TCO口径下每百万token成本 vs 交互速度 换算成业界最敏感的每百万Token成本,差距触目惊心。 TPU仅需0.181美元,B200为0.222美元,B300则高达0.276美元。 更戏剧性的,是时间。 今年4月,黄仁勋在Dwarkesh播客上宣称TPU与Trainium都不敢来跑分。他甚至公开鼓励挑战者使用InferenceMA