第一性原理视角下的MoE推理的经济学分析(在新窗口打开)
随着DeepSeek R1、Kimi K2和DeepSeek V3.1混合专家(MoE)模型的相继发布,它们已成为智能前沿领域大语言模型(LLM)的领先架构。由于其庞大的规模(1万亿参数及以上)和稀疏计算模式(每个token仅激活部分参数而非整个模型),MoE式LLM对推理工作负载提出了重大挑战,显著改变了底层的推理经济学。
共 194 篇
随着DeepSeek R1、Kimi K2和DeepSeek V3.1混合专家(MoE)模型的相继发布,它们已成为智能前沿领域大语言模型(LLM)的领先架构。由于其庞大的规模(1万亿参数及以上)和稀疏计算模式(每个token仅激活部分参数而非整个模型),MoE式LLM对推理工作负载提出了重大挑战,显著改变了底层的推理经济学。
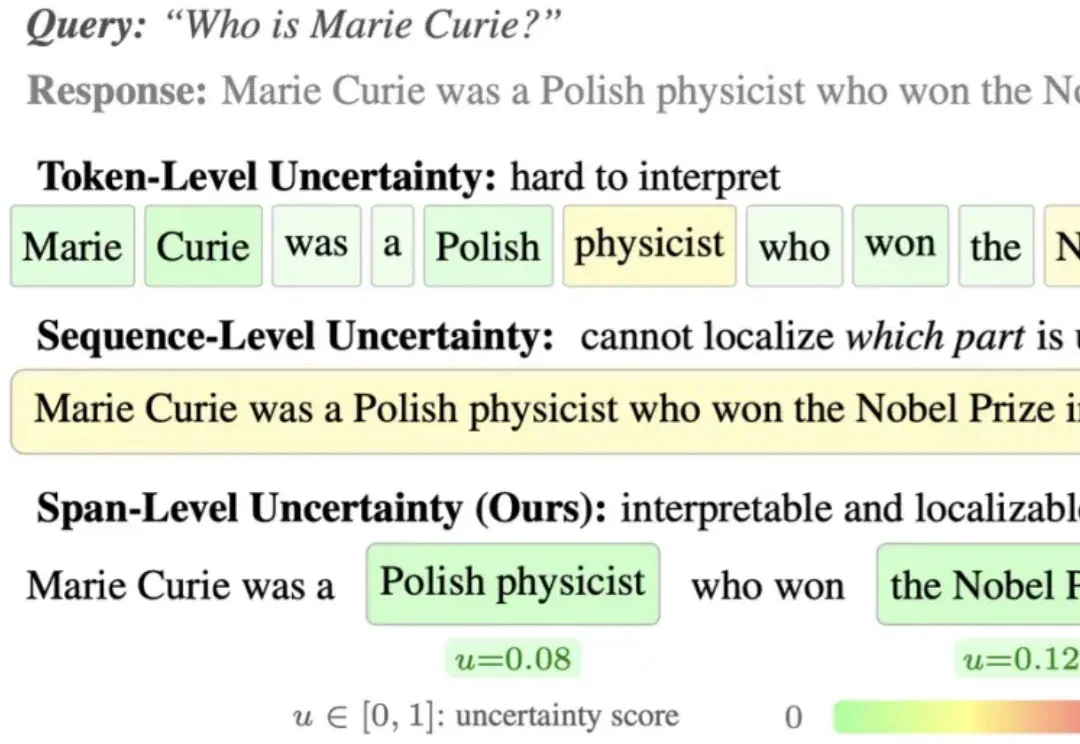
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
如果说大语言模型拉开了本轮人工智能革命的序幕,那么今天人机交互的瓶颈,早已不再是模型的智商,而是人类接收信息的生理带宽。
“这些人在往哪跑?为什么跑” “大模型浪潮狂飙三年半,国内AI人才也经历了三波大迁移。”资深科技猎头赵捷告诉雷峰网。 前两年,大家抢的是预训练人才,先是百度文心团队被疯抢,然后是AI六小虎人才遭遇瓜分,紧接着又是阿里、DeepSeek、字节、腾讯之间的人才大混战。 而现在,大家又开始抢推理、Agent等后训练人才;最近一年不少预训练人才,如Qwen Code负责人惠彬原、混元大语言模型预训练负责人姚星丞、混元多模态理解预训练负责人彭厚文,字节Seed核心专家顾全全等陆续离职,要么创业,要么流向更纯粹的AI研究团队。 是什么促成了这一轮轮AI人才大迁徙?这背后又藏着哪些AI行业更深层的逻辑转变?
据路透社援引三位知情人士爆料,苹果已和阿里巴巴展开合作,联合训练一款专门面向中国市场的大语言模型。就在8月8日,苹果悄然更新Mac使用手册,新增《在Mac上配合Apple智能使用千问》相关章节,这也是苹果首次对外官方披露国行Apple智能的合作细节,不过该章节后续已被删除。
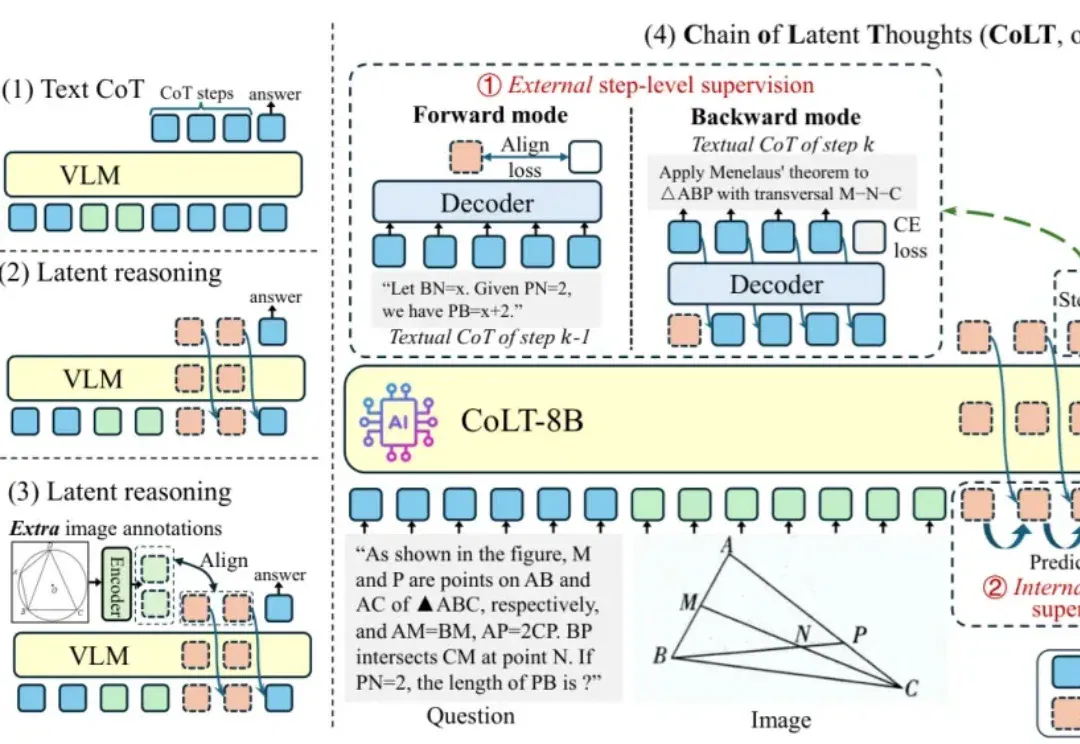
近年来,多模态大语言模型(MLLM)在视觉问答、图表理解、科学推理等任务上取得了令人瞩目的进展。
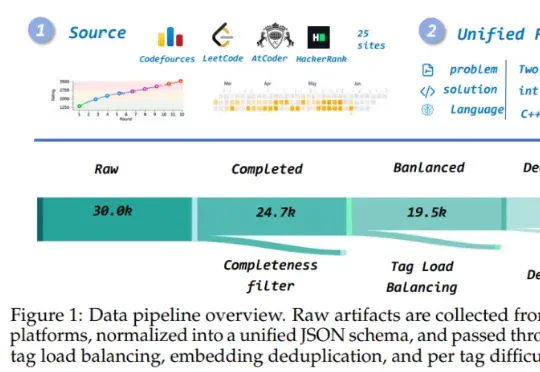
大语言模型在代码生成上的能力不断增强,但在复杂算法题,尤其是竞赛编程场景中,仍然容易因为算法选择错误、边界条件遗漏、复杂度判断失误或隐藏测试覆盖不足而失败。Solvita是一款面向竞赛编程的智能体框架,通过四个角色(Planner、Solver、Oracle、Hacker)形成闭环系统,并利用可训练的图结构知识网络积累经验。
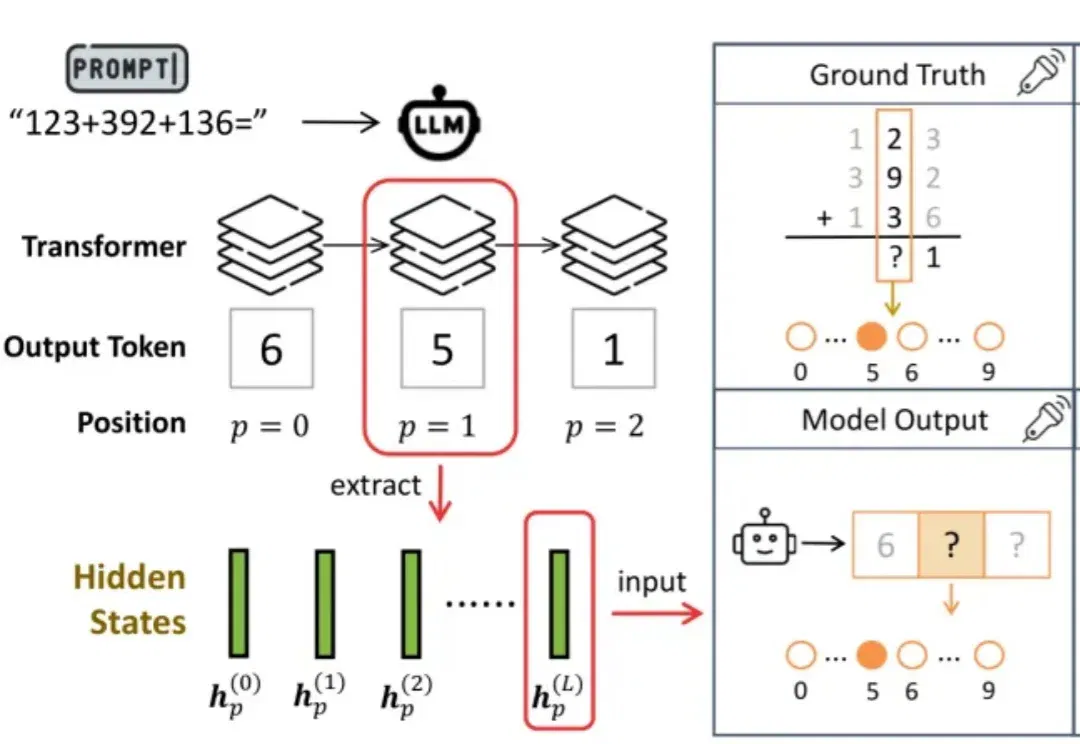
尽管大语言模型(Large Language Models, LLMs)在复杂数学推理、代码生成和知识问答上表现突出,但它们仍常在多位数加法这类基础算术任务上犯错。
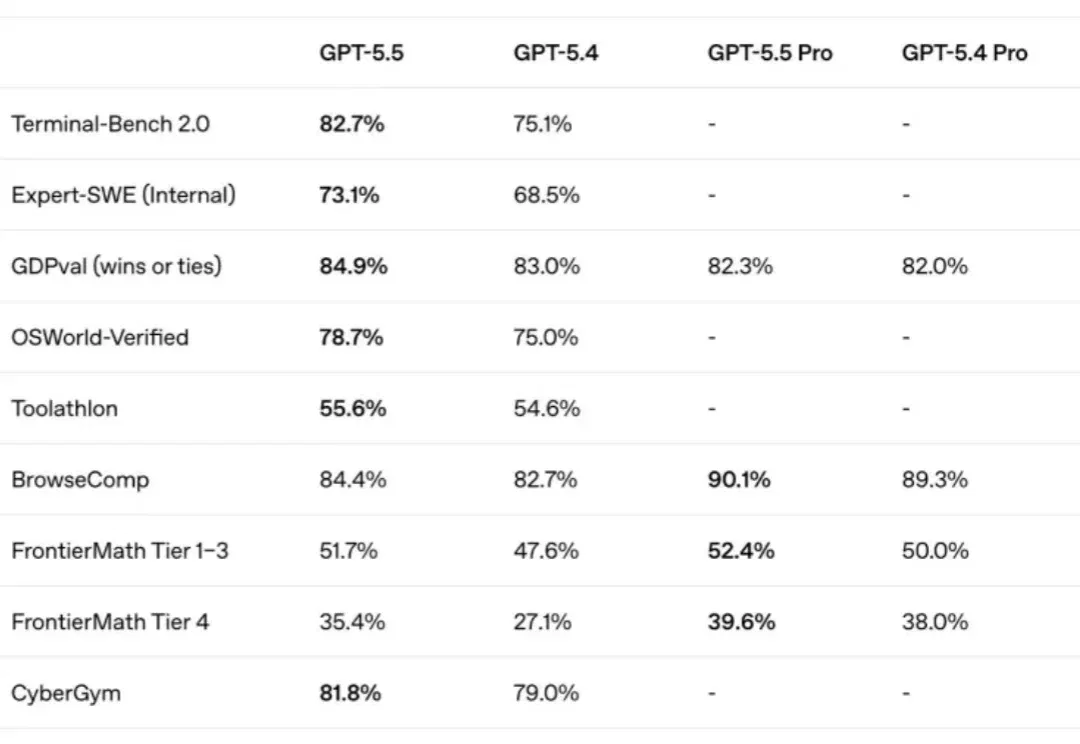
随着大语言模型逐步进入复杂推理、自动化研究和网络安全等高难度任务,传统的模型评测方式正在面临新的挑战。
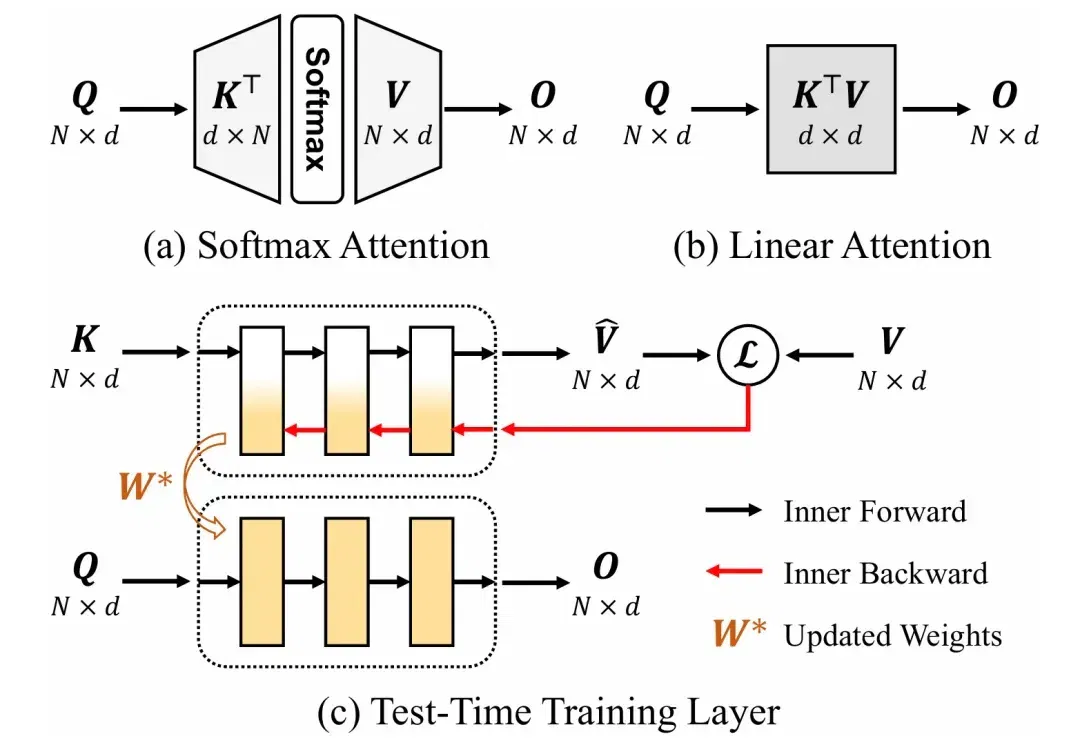
序列建模是大语言模型、计算机视觉等领域的基础共性问题。当前通用的 Transformer 模型计算复杂度随序列长度平方增长,在长序列任务中面临显著的计算挑战。因此,研究者们一直在探索具有线性计算复杂度的高效序列建模方法。