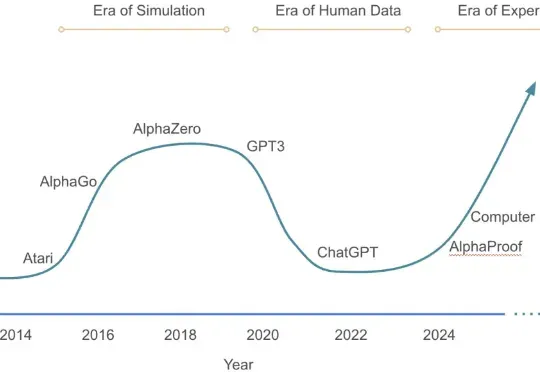
大模型推理学习新范式!ExGRPO框架:从盲目刷题到聪明复盘(在新窗口打开)
大模型在强化学习过程中,终于知道什么经验更宝贵了! 来自上海人工智能实验室、澳门大学、南京大学和香港中文大学的研究团队,最近提出了一套经验管理和学习框架ExGRPO—— 通过科学地识别、存储、筛选和学习有价值的经验,让大模型在优化推理能力的道路上,走得更稳、更快、更远。
共 1517 篇
大模型在强化学习过程中,终于知道什么经验更宝贵了! 来自上海人工智能实验室、澳门大学、南京大学和香港中文大学的研究团队,最近提出了一套经验管理和学习框架ExGRPO—— 通过科学地识别、存储、筛选和学习有价值的经验,让大模型在优化推理能力的道路上,走得更稳、更快、更远。
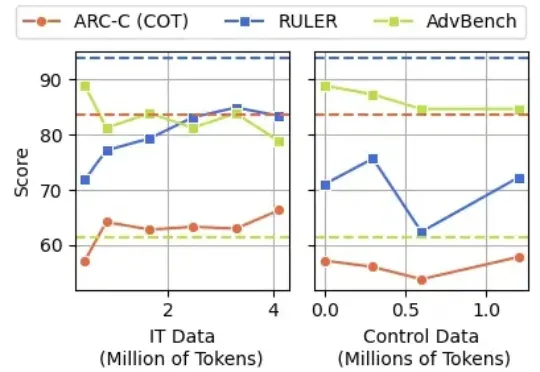
天天刷推,大模型的脑子也会坏掉。 终于有研究证明,互联网上的烂内容会让大模型得「脑腐」。 相信许多读者对「脑腐」这个词并不陌生,长时间沉浸在碎片化的网络信息中,我们经常会感到注意力下降、思维变钝。
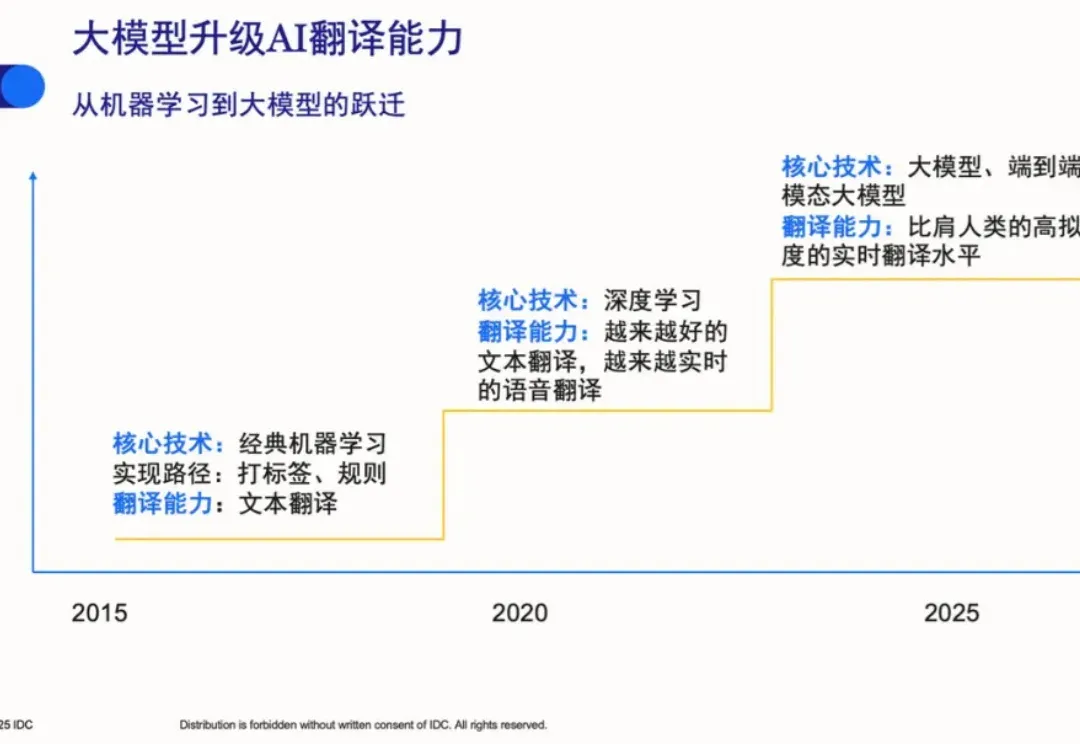
2025 年 10 月,国际数据公司(International Data Corporation,IDC)发布了《中国 AI 翻译技术评估》报告。这份以“大模型驱动 AI 翻译能力全面换新”为主题的报告指出,大模型技术的全面渗透正在深刻重塑 AI 翻译市场。
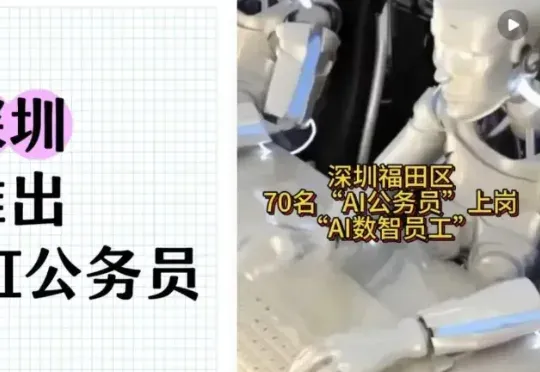
AI公务员的大脑就是政务大模型。 就在刚刚,中央网信办和国。就在刚刚,中央网信办和国家发展改革委联合印发了重磅文件——《政务领域人工智能大模型部署应用指引》(我们后面就叫它《指引》)。
在大模型训练时,如何管理权重、避免数值爆炸与丢失?Thinking Machines Lab 的新研究「模块流形」提出了一种新范式,它将传统「救火式」的数值修正,转变为「预防式」的约束优化,为更好地训练大模型提供了全新思路。
近日,国内首次针对AI大模型的实网众测结果正式公布,一场大型“安全体检”透露出不容忽视的信号:本次活动累计发现安全漏洞281个,其中大模型特有漏洞高达177个,占比超过六成,这组数据表明,AI正面临着超出传统安全范畴的新型威胁。
和大模型聊天如今也有了开盲盒的体验,只不过开的不是大模型的性能高低,而是哪家大模型更有性格。
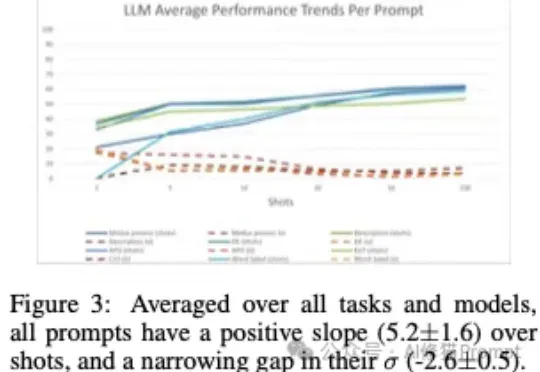
上下文学习”(In-Context Learning,ICL),是大模型不需要微调(fine-tuning),仅通过分析在提示词中给出的几个范例,就能解决当前任务的能力。您可能已经对这个场景再熟悉不过了:您在提示词里扔进去几个例子,然后,哇!大模型似乎瞬间就学会了一项新技能,表现得像个天才。
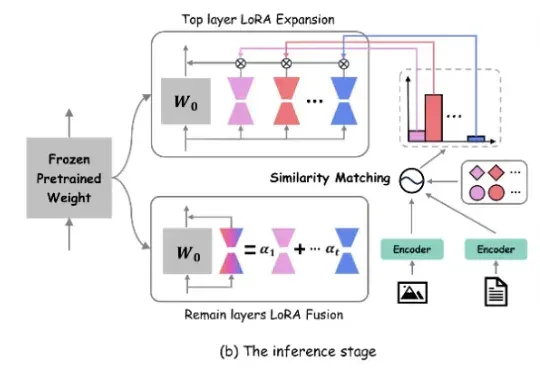
近年来,生成式 AI 和多模态大模型在各领域取得了令人瞩目的进展。然而,在现实世界应用中,动态环境下的数据分布和任务需求不断变化,大模型如何在此背景下实现持续学习成为了重要挑战
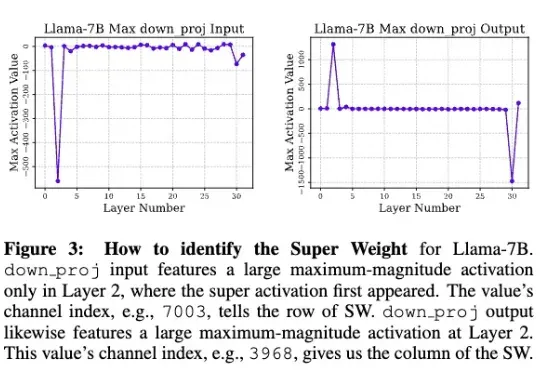
苹果研究人员发现,在大模型中,极少量的参数,即便只有0.01%,仍可能包含数十万权重,他们将这一发现称为「超级权重」。超级权重点透了大模型「命门」,使大模型走出「炼丹玄学」。