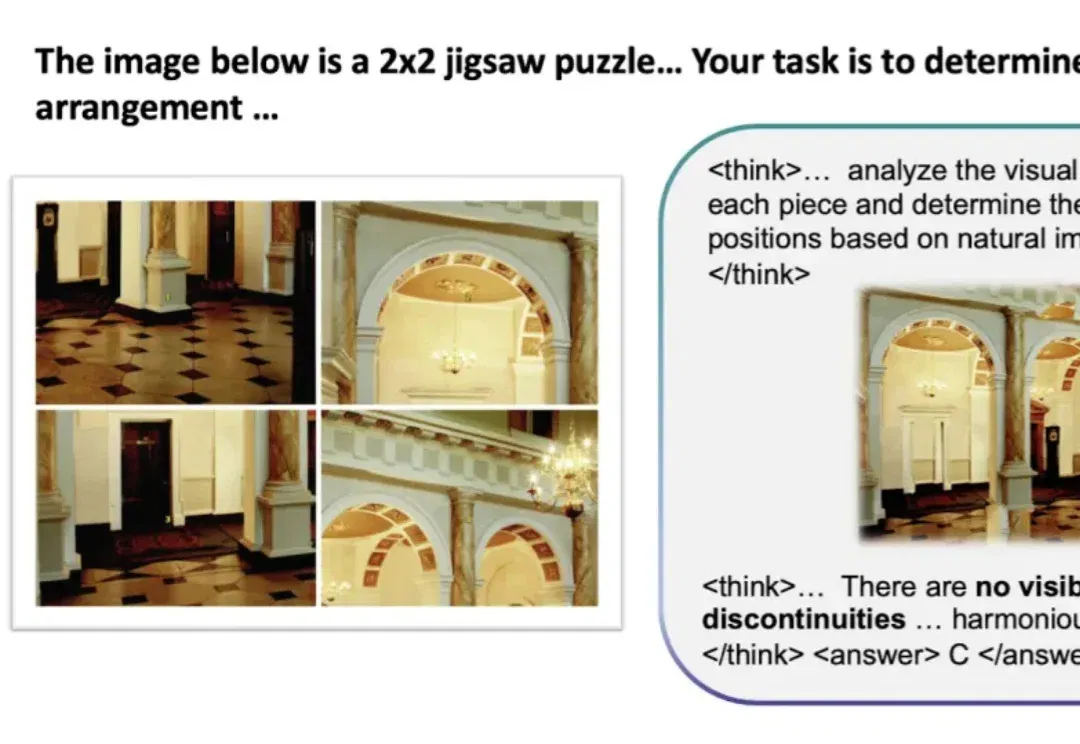
ICLR 2026|原生多模态推理新范式ThinkMorph ,让文字与图像在统一架构中共同演化(在新窗口打开)
NUS、ZJU、UW、Stanford、CUHK 联合提出 「ThinkMorph」,主张让文字与图像在统一架构里「原生协作」、「共同演化」,而不是像当下大多数多模态模型那样,看完图像就闭上眼睛,后续完全靠文字链条推进。仅用 2.4 万条数据微调 7B 统一模型,视觉推理平均提升 34.74%,多项任务比肩甚至超越 GPT-4o 和 Gemini 2.5 Flash。
共 438 篇
NUS、ZJU、UW、Stanford、CUHK 联合提出 「ThinkMorph」,主张让文字与图像在统一架构里「原生协作」、「共同演化」,而不是像当下大多数多模态模型那样,看完图像就闭上眼睛,后续完全靠文字链条推进。仅用 2.4 万条数据微调 7B 统一模型,视觉推理平均提升 34.74%,多项任务比肩甚至超越 GPT-4o 和 Gemini 2.5 Flash。
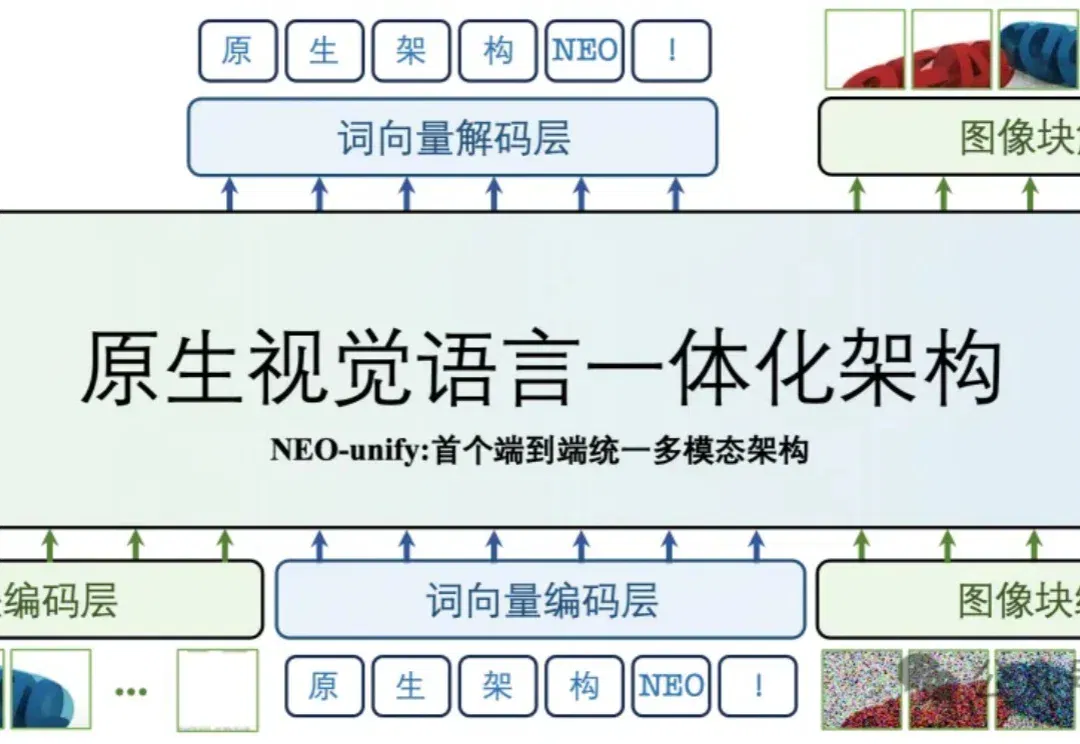
多模态大模型的研发范式,正在被彻底重构。
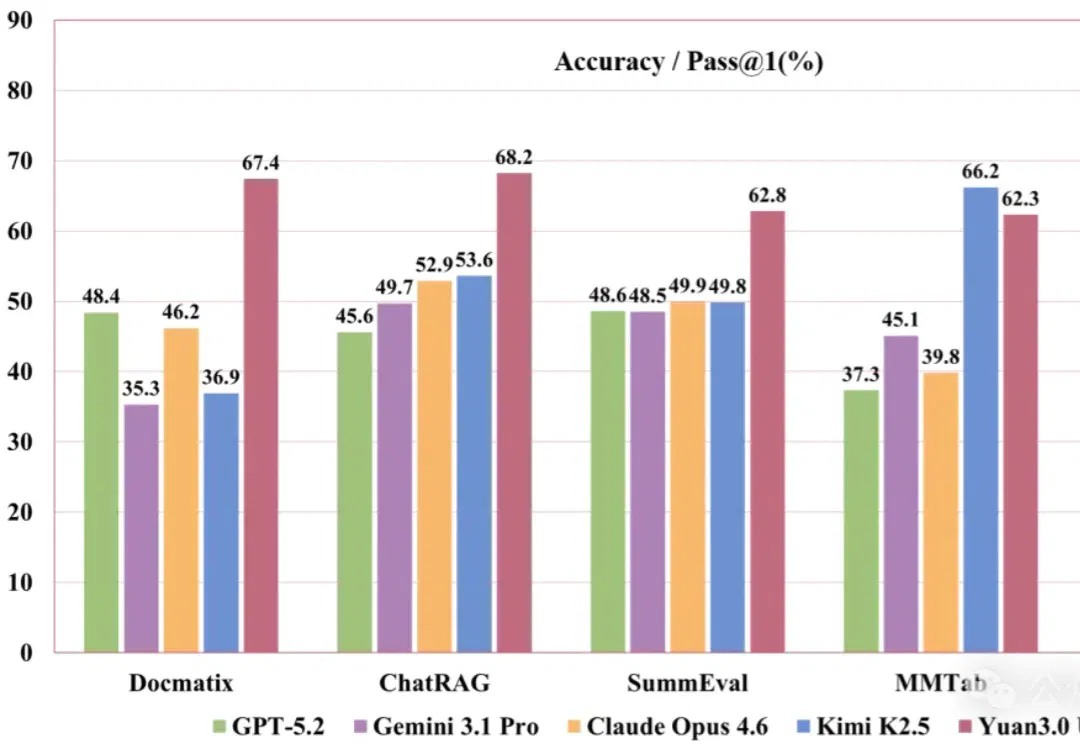
刚刚,YuanLab.ai团队正式开源发布源Yuan3.0 Ultra多模态基础大模型。
Meta联合多所高校发布首个可规模化自动生成第一视角音视频理解数据的引擎EgoAVU ,让多模态大模型首次真正「听懂世界」。
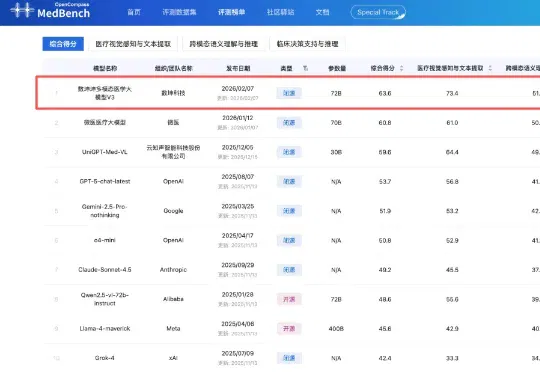
2月7日,中文医疗大模型评测平台MedBench公布最新多模态大模型评测榜单,数坤科技的数坤坤多模态医学大模型V3以63.6分拿下第一。在榜单中,V3的表现超过微医、云知声旗下医疗行业大模型,以及OpenAI、谷歌、阿里千问旗下通用大模型。
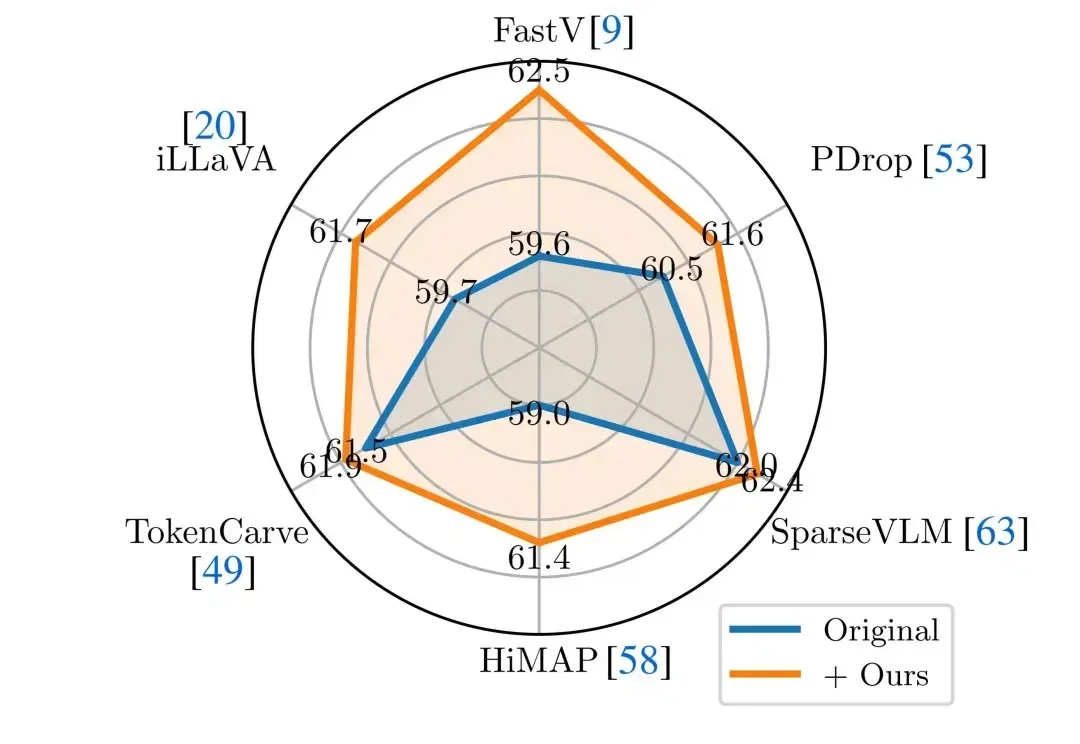
近年来,Vision-Language Models(视觉 — 语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。然而,这类模型在实际应用中往往面临推理开销大、效率受限的问题,研究者通常依赖 visual token pruning 等策略降低计算成本,其中 attention 机制被广泛视为衡量视觉信息重要性的关键依据。
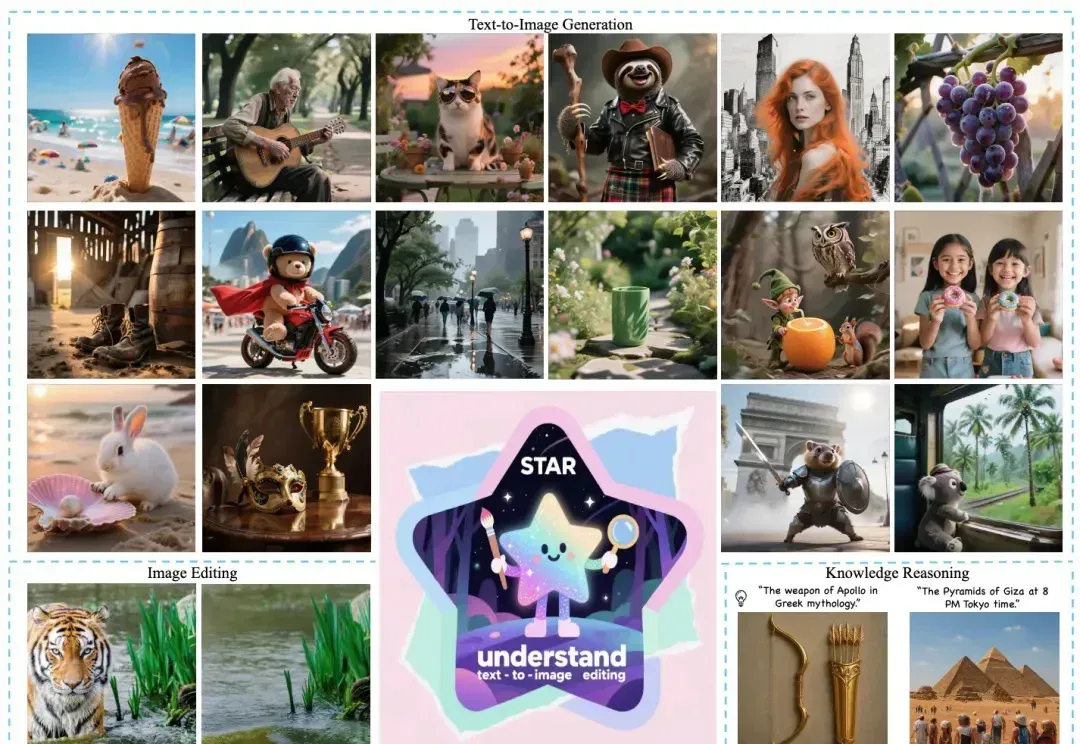
近日,美团推出全新多模态统一大模型方案 STAR(STacked AutoRegressive Scheme for Unified Multimodal Learning),凭借创新的 "堆叠自回归架构 + 任务递进训练" 双核心设计,实现了 "理解能力不打折、生成能力达顶尖" 的双重突破。
AI 网红们在社交平台上混得风生水起。 他们手握品牌合作,还坐拥百万粉丝,但很多人至今不知这些都是 AI 生成的,依然像追真人明星一样互动、点赞、被种草。 视频来源:X 博主 @thetripathi58 这也难怪有博主直呼:虚拟网红时代已经到来。 现在,昆仑万维也来添了把火,直接把背后的技术开源了。 1 月 29 日,Skywork AI 团队宣布开源 SkyReels-V3 多模态视频生成模型系列。该系列涵盖参考图像转视频、视频延长和音频驱动虚拟形象三大核心能力,在单一建模架构中实现高保真多模态视频生成,达到业界领先水平。 比如,只需一张虚拟主播照片配上音频,就能生成口型精准、表情生动的主
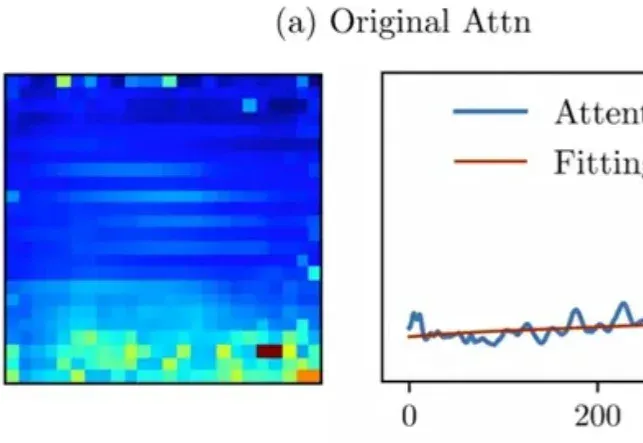
Attention真的可靠吗? 近年来,Vision-Language Models(VLMs)在多模态理解任务中取得了显著进展,尤其是在视觉问答、图像理解和视频理解等场景中,模型通常通过language-to-vision attention来衡量视觉token与文本之间的相关性,并据此进行visual token pruning,以降低推理成本、提升运行效率。 然而,一个长期被忽视的问题是:attention本身是否真的能够作为“语义重要性”的可靠指标? 在最新研究中,上海大学曾丹团队系统分析了主流VLM中attention的行为模式,发现一个关键却容易被忽略的现象——attention并
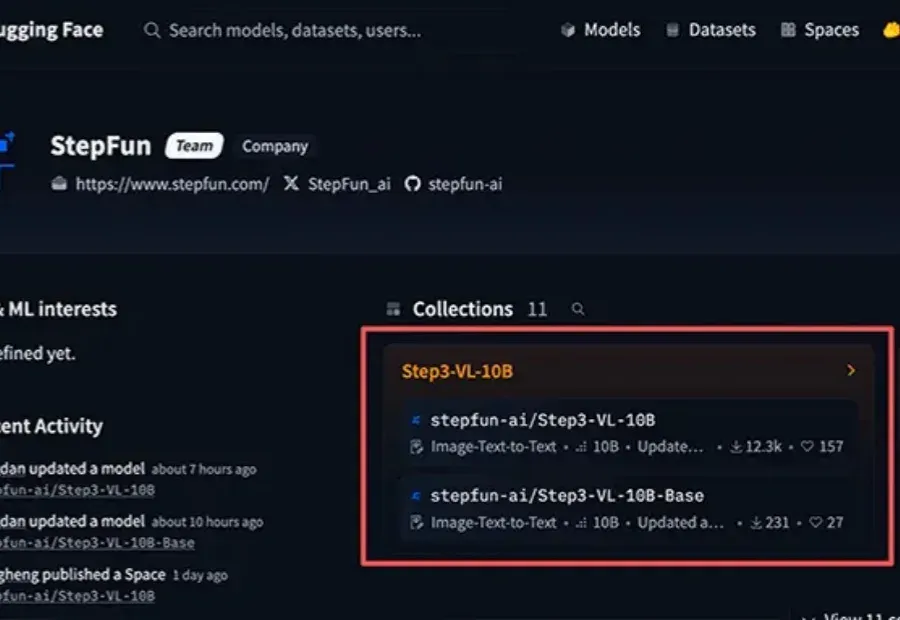
10B参数拥有媲美千亿级模型的多模态推理实力。