偶然刷到的一个逆天ElevenLabs开源平替!(在新窗口打开)
订阅了 ElevenLabs 的小伙伴看过来,它的开源平替来了!Chatterbox 是全球首个支持强烈情绪控制的开源TTS 模型,更是号称开源 TTS 中的 SOTA ,由 Resemble AI 推出。
共 23 篇
订阅了 ElevenLabs 的小伙伴看过来,它的开源平替来了!Chatterbox 是全球首个支持强烈情绪控制的开源TTS 模型,更是号称开源 TTS 中的 SOTA ,由 Resemble AI 推出。
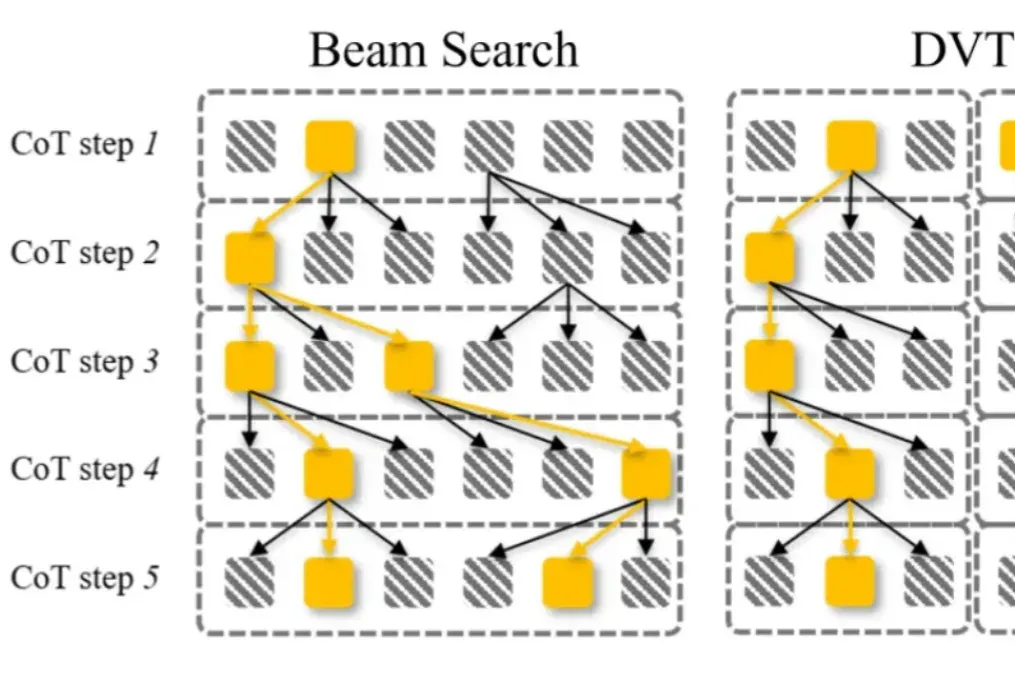
大语言模型通过 CoT 已具备强大的数学推理能力,而 Beam Search、DVTS 等测试时扩展(Test-Time Scaling, TTS)方法可通过分配额外计算资源进一步提升准确性。然而,现有方法存在两大关键缺陷:路径同质化(推理路径趋同)和中间结果利用不足(大量高质量推理分支被丢弃)。
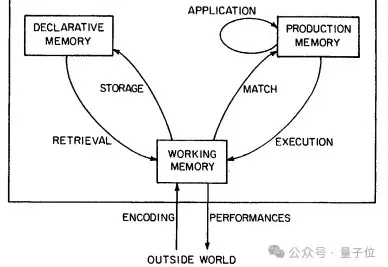
TTSE 将智能体经验拆为环境事实与条件式技巧,分别检验和更新。团队报告五项基准结果,并在 WorkSwarm 展示表格与文档任务中的复用案例。
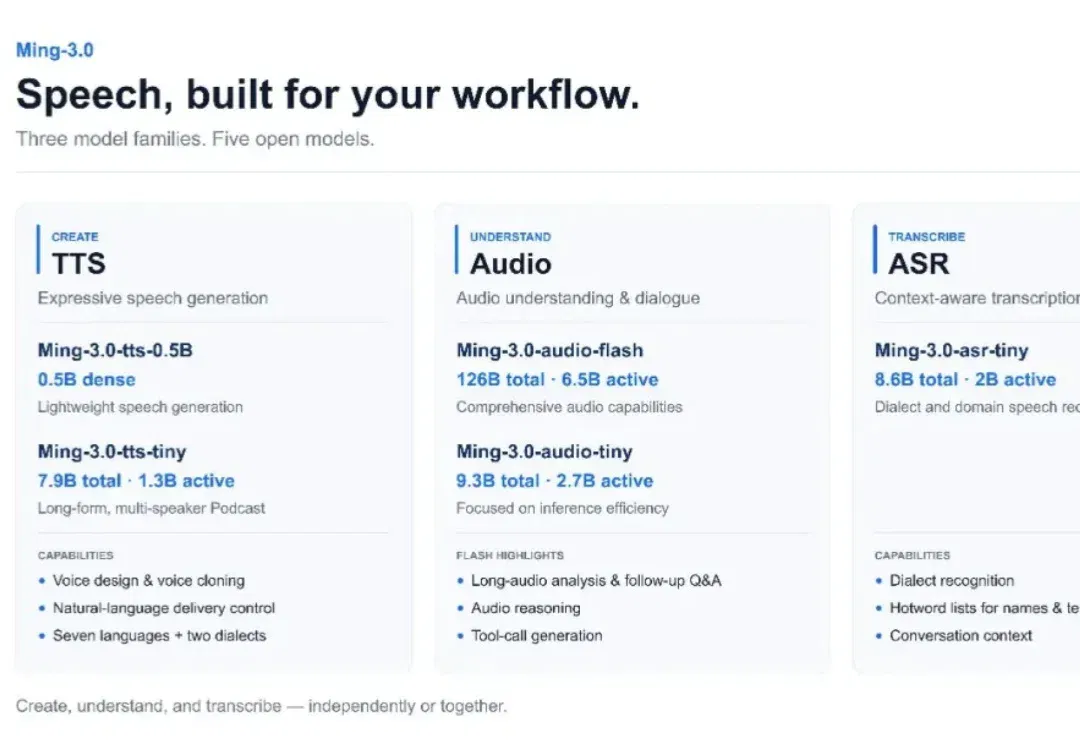
配音、听录音、转写全覆盖。 智东西10月20日报道,今日,蚂蚁百灵开源Ming-3.0语音系列模型,共包含用于语音合成、音频理解与对话、语音识别的五款模型,重点支持音色与台词表演控制、长音频分析与连续问答,以及结合热词和对话上下文的语音识别。 具体来看,语音合成系列包含Ming-3.0-tts-0.5B、Ming-3.0-tts-tiny,其中tiny版本还支持长篇多角色播客生成;音频理解与对话系列包含Ming-3.0-audio-flash、Ming-3.0-audio-tiny,面向会议、访谈等录音分析场景;语音识别模型为Ming-3.0-asr-tiny,支持中英文及方言转写。 此次发布
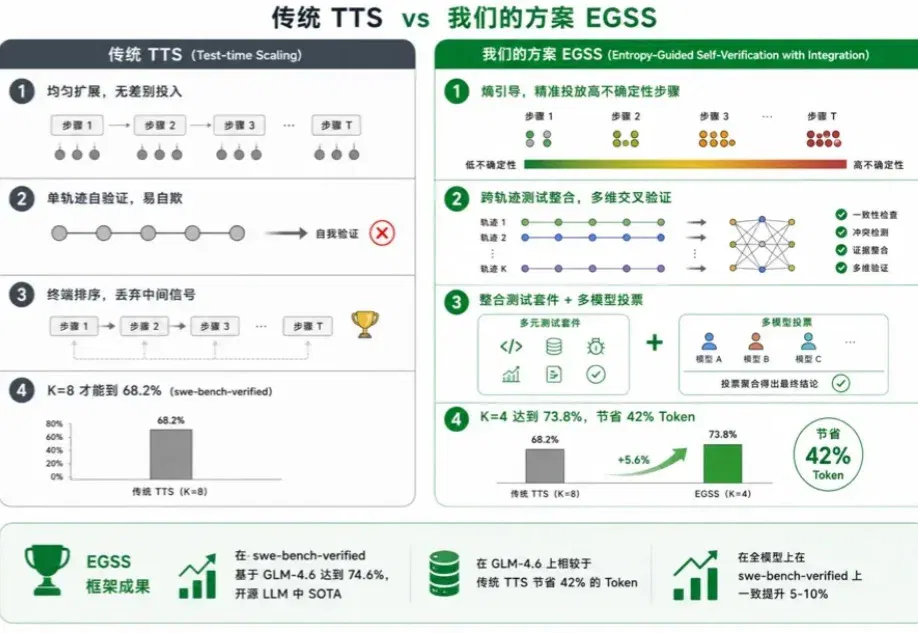
更聪明的计算远比更多的计算更有效。 这正是蚂蚁集团CodeFuse团队,用一篇ACL 2026主会论文验证的核心结论。 Test-Time Scaling(TTS)是通过在推理阶段投入更多计算资源,让Agent多次尝试、探索不同推理路径再选最优的关键范式,是当前LLM在复杂任务上取得SOTA的核心方法。 然而业界主流TTS方法对所有推理步骤一视同仁地投入计算,大量Token浪费在确定性操作上,且多轨迹选择仅靠“谁得票多”,Agent自我验证通过率88%中却有35.7%是错的—— 投入翻倍,收益边际递减。 针对这一现状,蚂蚁集团CodeFuse团队提出EGSS: 通过“工具熵”指标精准识别高不确
Boson AI 与 SGLang-Omni 团队宣布,SGLang-Omni 已完成对 Higgs Audio v3 TTS 的端到端 Serving 支持。作为一家成立于 2023 年的 AI 基础设施公司,李沐与 Alex Smola共同创立了 Boson AI,聚焦大模型时代的系统与基础设施创新。
大模型推理的爆发,实际源于 scaling 范式的转变:从 train-time scaling 到 test-time scaling(TTS),即将更多的算力消耗部署在 inference 阶段。典型的实现是以 DeepSeek r1 为代表的 long CoT 方法:通过增加思维链的长度来获得答案精度的提升。那么 long CoT 是 TTS 的唯一实现吗?
Voice Agent 赛道正在爆发,但它迫切需要一个能让对话真正「流动起来」的底层引擎,一个能撑起下一代交互体验的 TTS 模型。竞争的焦点,已经从 LLM 的「大脑」,延伸到了 TTS 的「嗓音」。谁掌握嗓音,谁就掌握着下一代 AI 商业化的钥匙。而 10 月 30 日 MiniMax 发布的 Speech 2.6 模型,似乎正是一个专为解决这些痛点而来的答案。
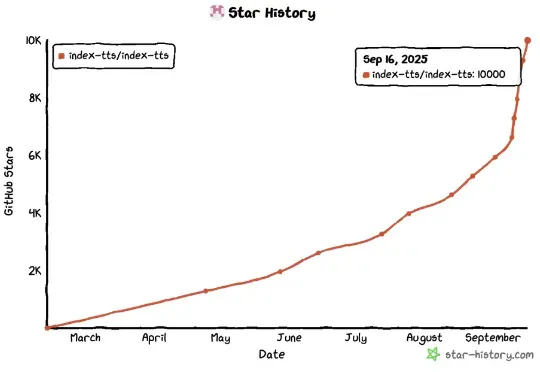
最近在 B 站上,你是否也刷到过一些 “魔性” 又神奇的 AI 视频?比如英文版《甄嬛传》、坦克飞天、曹操大战孙悟空…… 这些作品不仅完美复现了原角色的音色,连情感和韵律都做到了高度还原!更让人惊讶的是,它们居然全都是靠 AI 生成的!
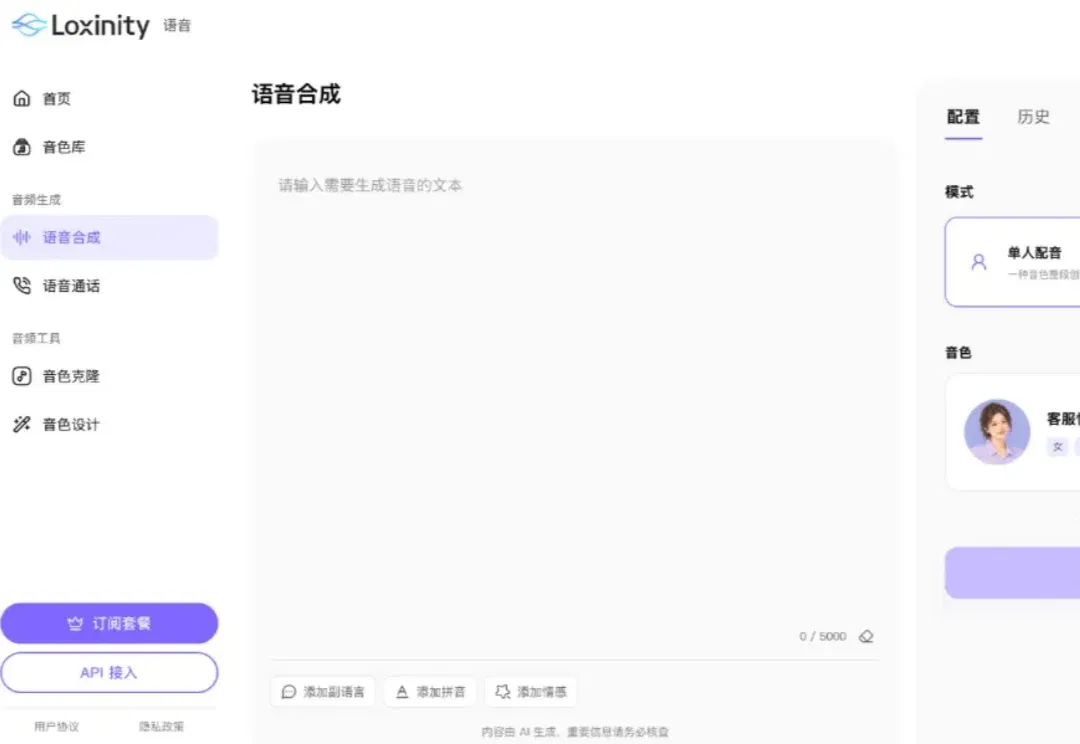
《读佳》独家获知,Soul将推出专为交互场景打造、超具活人感的语音合成产品“Loxinity(洛希无限)”,和市面上面向配音、短视频的TTS不同,这套模型从底层瞄准实时交互场景,主打强活人感。它支持单人配音、多人对话两种模式,配套音色克隆、音色设计等工具,还开放API接入。Loxinity下辖语音合成模型Loxi Speech和视频生成模型Loxi Avatar。