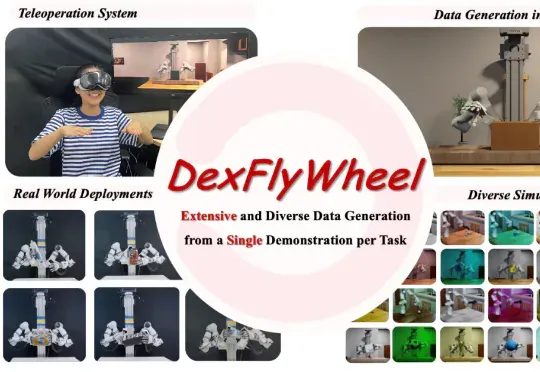
NeurIPS 2025 Spotlight | 只需一条演示,DexFlyWheel框架让机器人学会「自我造数据」(在新窗口打开)
近期,北京大学、哈尔滨工业大学联合 PsiBot 灵初智能提出首个自我增强的灵巧操作数据生成框架 ——DexFlyWheel。该框架仅需单条演示即可启动任务,自动生成多样化的灵巧操作数据,旨在缓解灵巧手领域长期存在的数据稀缺问题。目前已被 NeurIPS 2025 接受为 Spotlight(入选率约 3.2%)
共 23 篇
近期,北京大学、哈尔滨工业大学联合 PsiBot 灵初智能提出首个自我增强的灵巧操作数据生成框架 ——DexFlyWheel。该框架仅需单条演示即可启动任务,自动生成多样化的灵巧操作数据,旨在缓解灵巧手领域长期存在的数据稀缺问题。目前已被 NeurIPS 2025 接受为 Spotlight(入选率约 3.2%)
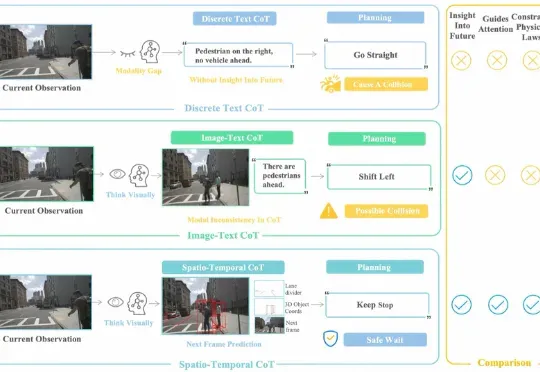
面向自动驾驶的多模态大模型在 “推理链” 上多以文字或符号为中介,易造成空间 - 时间关系模糊与细粒度信息丢失。FSDrive(FutureSightDrive)提出 “时空视觉 CoT”(Spatio-Temporal Chain-of-Thought),让模型直接 “以图思考”,用统一的未来图像帧作为中间推理步骤,联合未来场景与感知结果进行可视化推理。
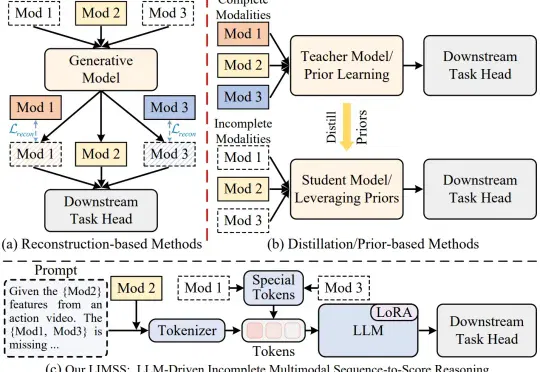
本文是北京大学彭宇新教授团队联合福州大学柯逍教授团队在细粒度多模态动作质量评价领域的最新研究成果,相关论文已被 ICML 2026 接收为 Spotlight,并已开源。真实世界中的多模态数据往往并不完整。在动作质量评价任务中,视频、光流、音频等模态能够从不同角度描述动作执行过程,但在实际采集时,传感器故障、环境噪声、隐私限制等因素都会导致模态缺失。
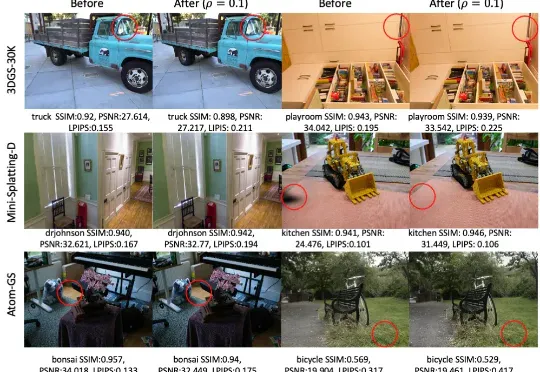
在三维视觉领域,3D Gaussian Splatting (3DGS) 是近年来大热的三维场景建模方法。它通过成千上万的高斯球在空间中“泼洒”,拼合成一个高质量的三维世界,就像是把一片空白的舞台,用彩色的光斑和粒子逐渐铺满,最后呈现出一幅立体的画卷。
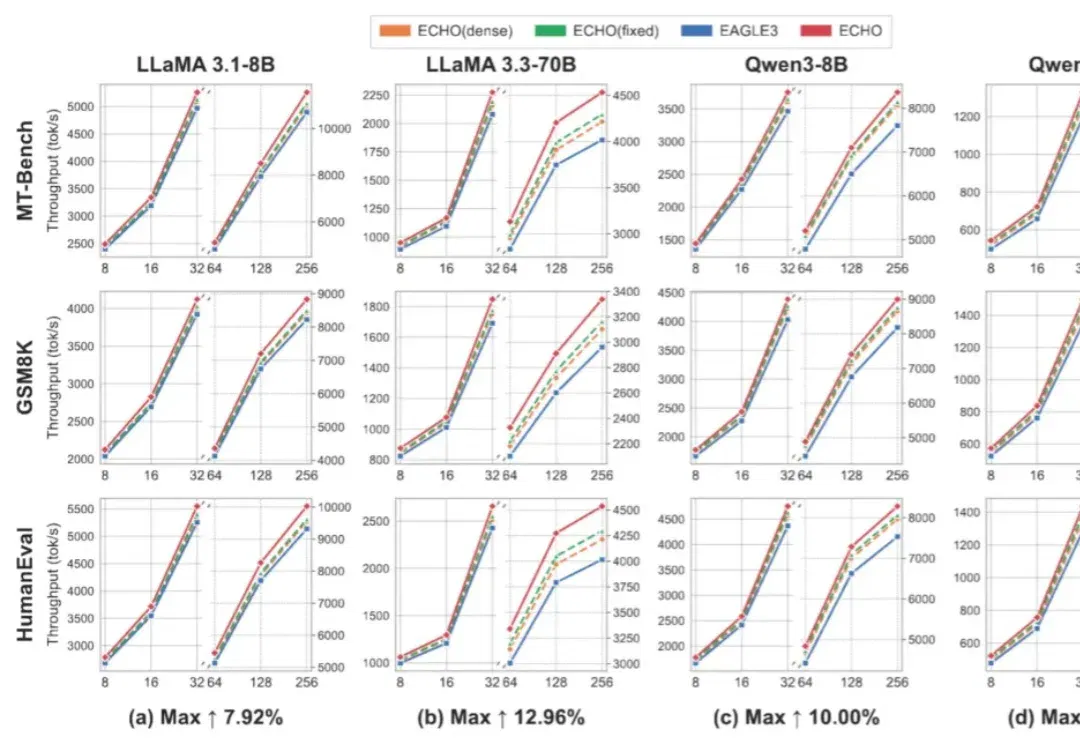
随着大模型参数规模持续扩大,推理成本已经成为生产级 LLM 服务的核心瓶颈。投机解码(Speculative Decoding, SD)通过「小模型 draft + 大模型 verify」的方式,将多个候选 token 放到一次目标模型前向中并行验证,从而缓解自回归解码的串行瓶颈。
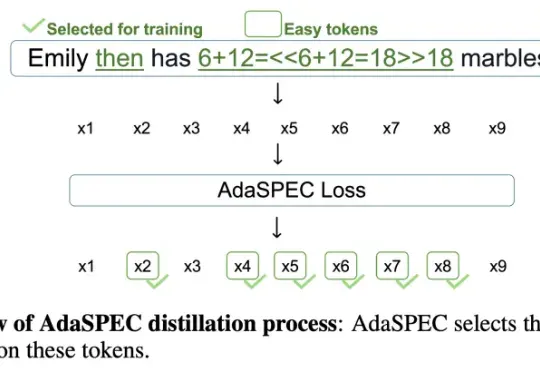
目前,最先进的对齐方法是使用知识蒸馏(Knowledge Distillation, KD)在所有 token 上最小化 KL 散度。然而,最小化全局 KL 散度并不意味着 token 的接受率最大化。由于小模型容量受限,草稿模型往往难以完整吸收目标模型的知识,导致直接使用蒸馏方法的性能提升受限。在极限场景下,草稿模型和目标模型的巨大尺寸差异甚至可能导致训练不收敛。
近年来,NeRF、SDF 与 3D Gaussian Splatting 等方法大放异彩,让 AI 能从图像中恢复出三维世界。但随着相关技术路线的发展与完善,瓶颈问题也随之浮现:
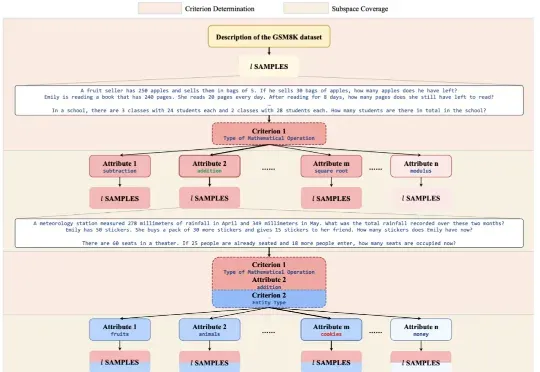
“TreeSynth” 就这样起源于作者们最初的构想:“如何通过一句任务描述生成海量数据,完成模型训练?” 同时,大规模 scalibility 对合成数据的多样性提出了新的要求。
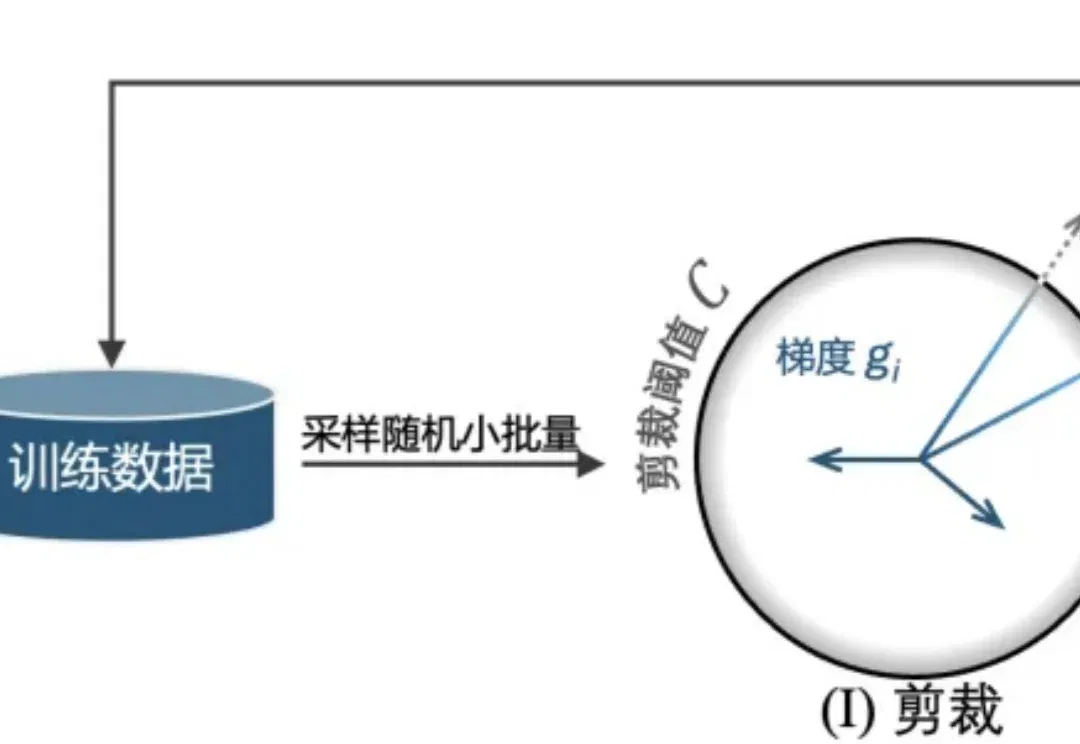
近日,来自英国南安普顿大学(University of Southampton)和广州大学的研究者团队提出 SlaClip,一种用于差分隐私随机梯度下降(DP-SGD)[1] 的自适应梯度剪裁方法。
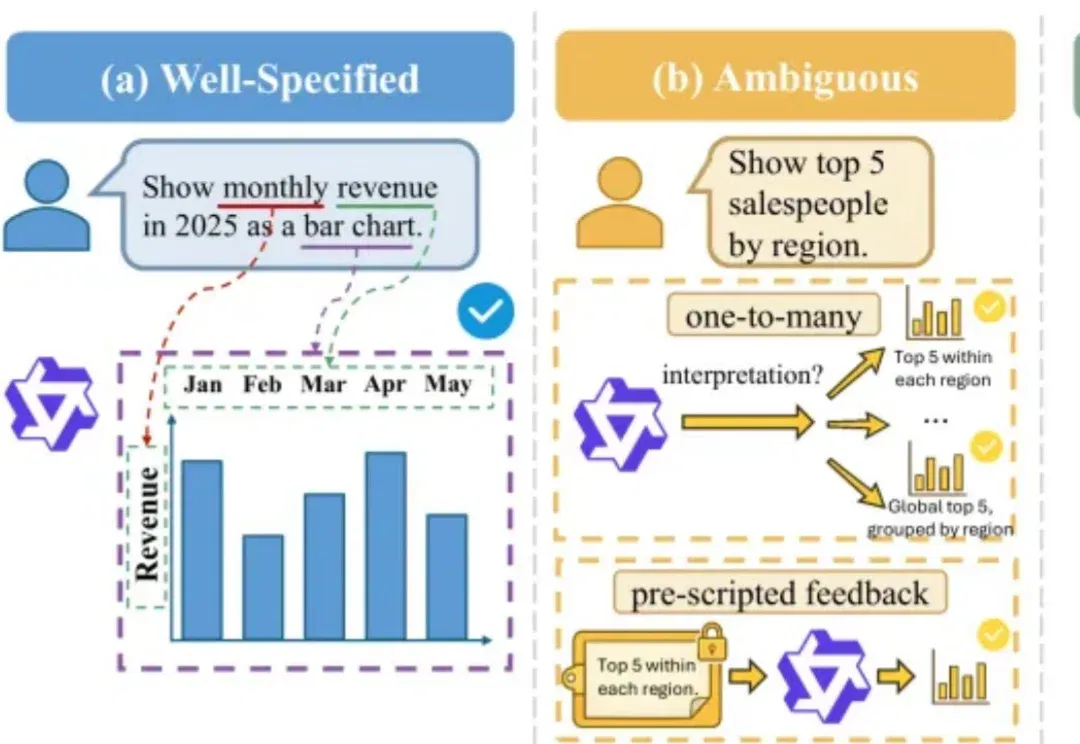
数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。