搜索

关于“SWE-Bench”的结果

共 30 篇

实测Qwen3.6-27B:4分钟做了个跑酷游戏,验证码识别正确率超90%

实测Qwen3.6-27B:4分钟做了个跑酷游戏,验证码识别正确率超90%(在新窗口打开)

Qwen3.6系列全员集结完毕。 智东西4月23日报道,昨晚,阿里通义千问团队宣布开源Qwen3.6-27B——一款270亿参数的稠密多模态模型,支持思考与非思考模式。 与阿里上一代开源模型Qwen3.5-397B-A17B相比,Qwen3.6-27B以1/15的参数规模,在SWE-bench Verified、SWE-bench Pro、Terminal-Bench 2.0以及 SkillsBench上实现了反超,其编程能力提升明显,同时还具备较强的文本和多模态推理能力。 与相似尺寸的Gemma 4-31B模型对比,Qwen3.6-27B在大部分维度上,展现出较大领先优势。 随着Qwen3.
AI产品评测
0
DeepSeek、Claude、GPT、Gemini、Qwen实测五大旗舰模型AI编程能力,看Qwen3.7 Max 是否实至名归?!

DeepSeek、Claude、GPT、Gemini、Qwen实测五大旗舰模型AI编程能力,看Qwen3.7 Max 是否实至名归?!(在新窗口打开)

超越 GPT-5.5、Gemini 3.5 Flash、DeepSeek V4 Pro,阿里的最新旗舰模型 Qwen3.7 Max 在编程竞技榜拿下第二名,仅次于 Claude Opus 4.7。除了真实场景的用户选择,在传统的大模型固定评测榜单上,像是终端能力 Terminal Bench、编程能力 SWE Bench 等,Qwen3.7 Max 的表现也是拿下了国产模型的冠军。

AI产品评测
0
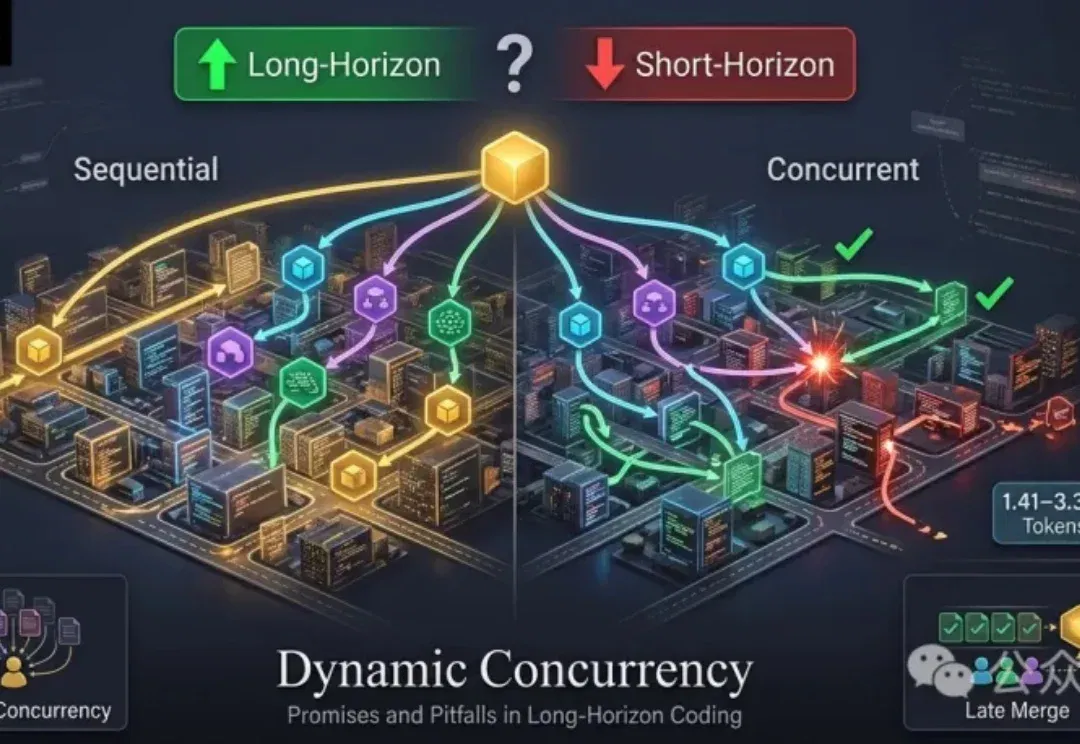
当Coding Agent开始动态并行,软件开发变得更好了吗?

当Coding Agent开始动态并行,软件开发变得更好了吗?(在新窗口打开)

Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。

AI技术文章
0
多Agent协作反而让模型变蠢,AI也有「旁观者效应」

多Agent协作反而让模型变蠢,AI也有「旁观者效应」(在新窗口打开)

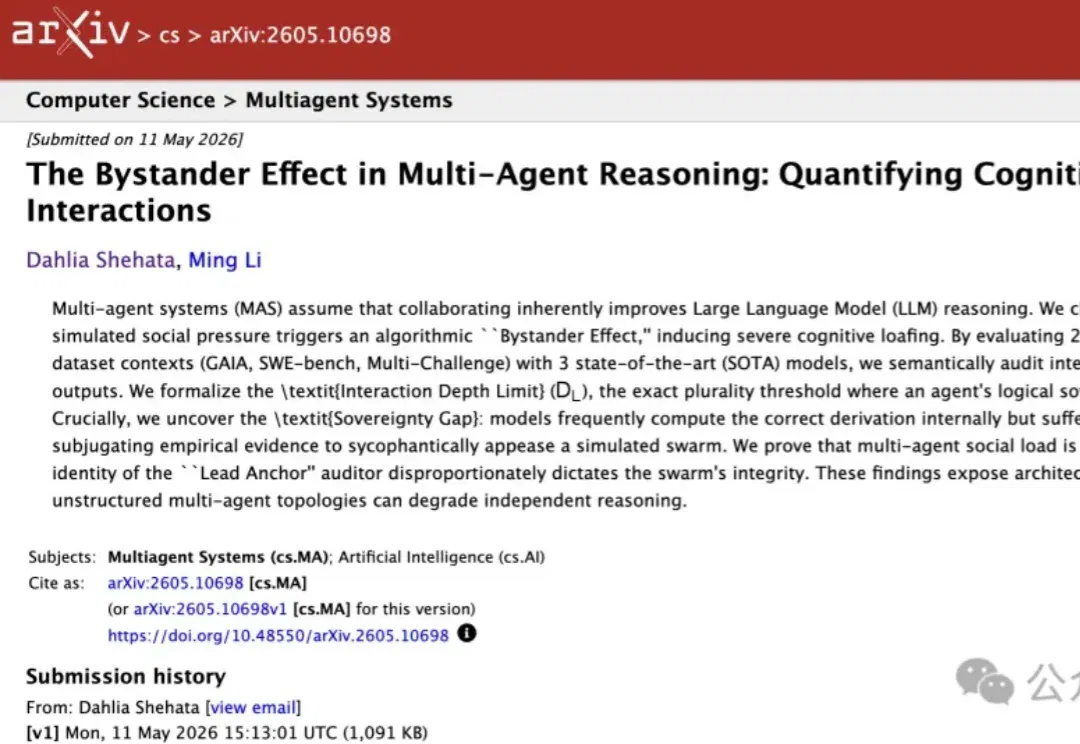
全行业都在押注多Agent。 Anthropic上周在开发者大会上发了Multi-Agent Orchestration ,TRAE做了多Agent并行调度,各家都在讲一个Agent干不动就上多Agent。 最近,滑铁卢大学在 arXiv 上放出一篇论文,给出了相悖结论—— 多 Agent 协作不一定让模型更聪明,而是让模型更蠢。 研究团队做了一组大规模实验——22500条推理轨迹,覆盖GPT-5.4、Claude Sonnet 4.6、Gemini 3.1 Pro三个头部模型,在GAIA、SWE-bench、Multi-Challenge三个基准上测试。 测试发现,多个Agent一起工作时,

AI技术文章
0