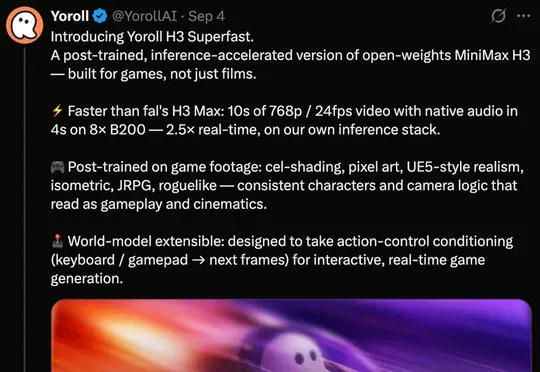
AI互动内容公司发布后训练模型 Yoroll H3 Superfast(在新窗口打开)
AI视频生成正从质量竞争转向实时速度竞争,AI互动内容公司Yoroll基于开源MiniMax H3模型推出后训练模型Yoroll H3 Superfast,可在4秒内生成10秒768p带音频视频,并上线由其驱动的实时互动叙事产品YoLive。
共 21 篇
AI视频生成正从质量竞争转向实时速度竞争,AI互动内容公司Yoroll基于开源MiniMax H3模型推出后训练模型Yoroll H3 Superfast,可在4秒内生成10秒768p带音频视频,并上线由其驱动的实时互动叙事产品YoLive。
近期,阿里巴巴 ROLL 团队(淘天未来生活实验室与阿里巴巴智能引擎团队)联合上海交通大学、香港科技大学推出「3A」协同优化框架 ——Async 架构(Asynchronous Training)、Asymmetric PPO(AsyPPO)与 Attention 机制(Attention-based Reasoning Rhythm),
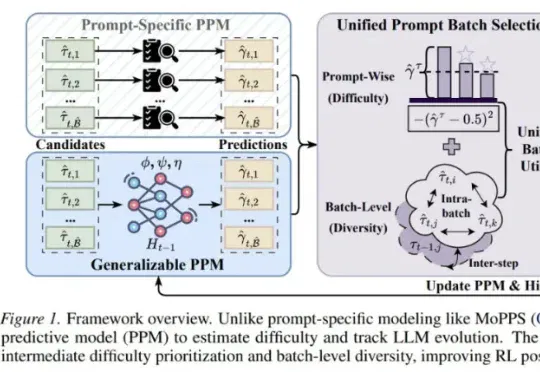
来自清华大学与腾讯的研究者提出了 Generalizable Predictive Prompt Selection(GPS)。GPS 的做法很直接:先训练一个小型、可泛化的 Prompt Predictive Model(PPM),让它预测不同 prompt 在当前模型下的难度;再根据难度和 batch 多样性选择训练样本,从而减少无效 rollout。
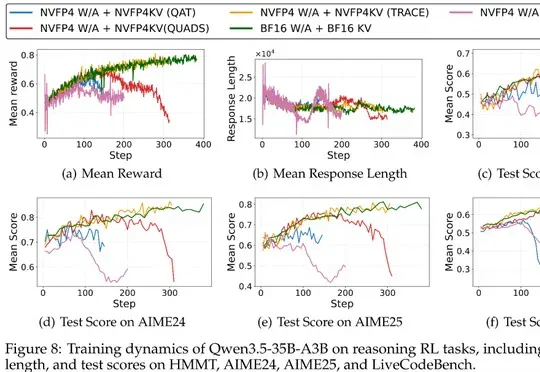
阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
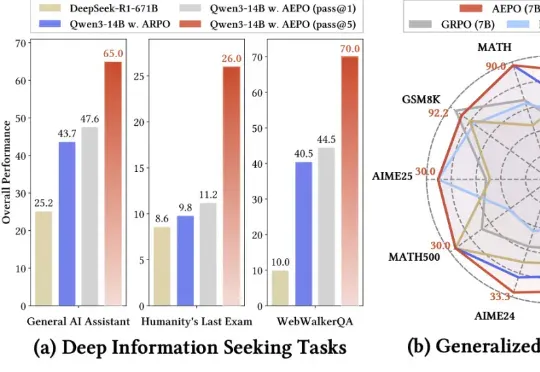
AEPO 系统性揭示了「高熵 Rollout 采样坍缩」和「高熵梯度裁剪」问题,并设计了「动态熵平衡 Rollout 采样」与「熵平衡策略优化」两项核心机制。前者通过熵预监控与连续分支惩罚实现全局与局部探索预算的自适应分配,后者在策略更新阶段引入梯度停止与熵感知优势估计以保留高熵 token 的探索梯度。
最近,硅谷兴起了一股新玩法,叫 AI Rollup。 简单来说,就是投资机构帮助AI应用公司收购一批传统小公司,然后把 AI 技术塞进去,让它们更高效、更赚钱,然后批量做大。 一个典型案例就是AI客服公司Crescendo。
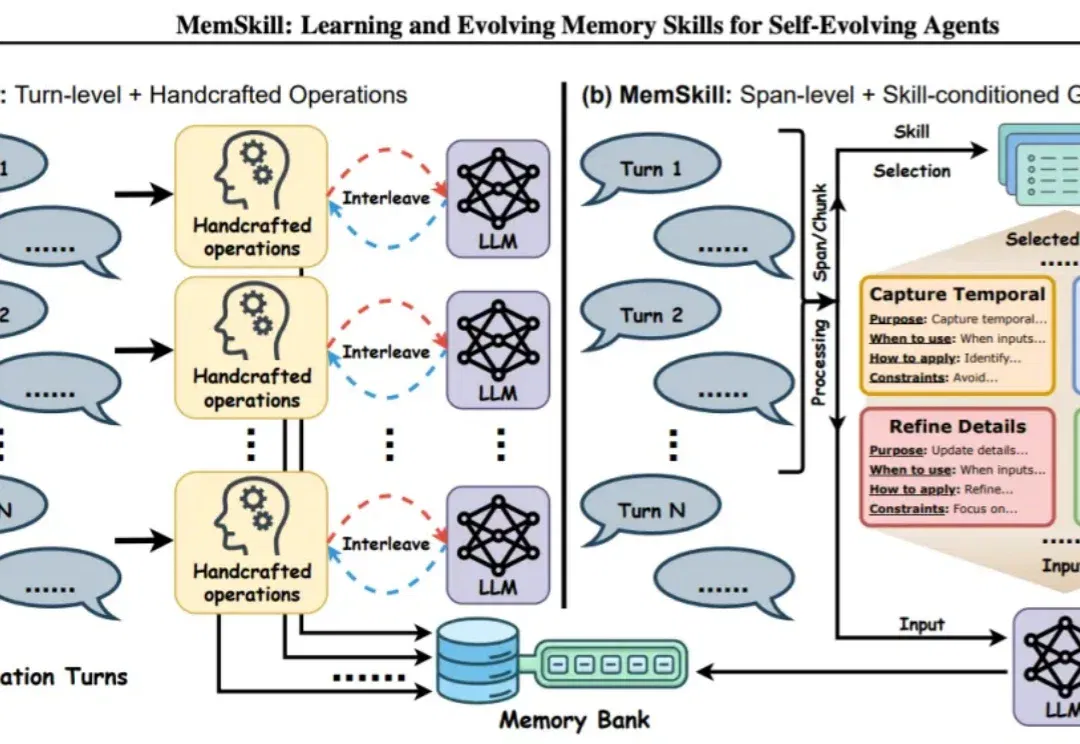
MemSkill 将智能体记忆操作封装为可复用的技能,由 Controller 学习选择,Executor 构建记忆,Designer 根据失败案例改进技能库。论文在长期对话、具身任务和迁移问答中评估表现;持续利用真实用户反馈适配偏好仍是后续研究方向。
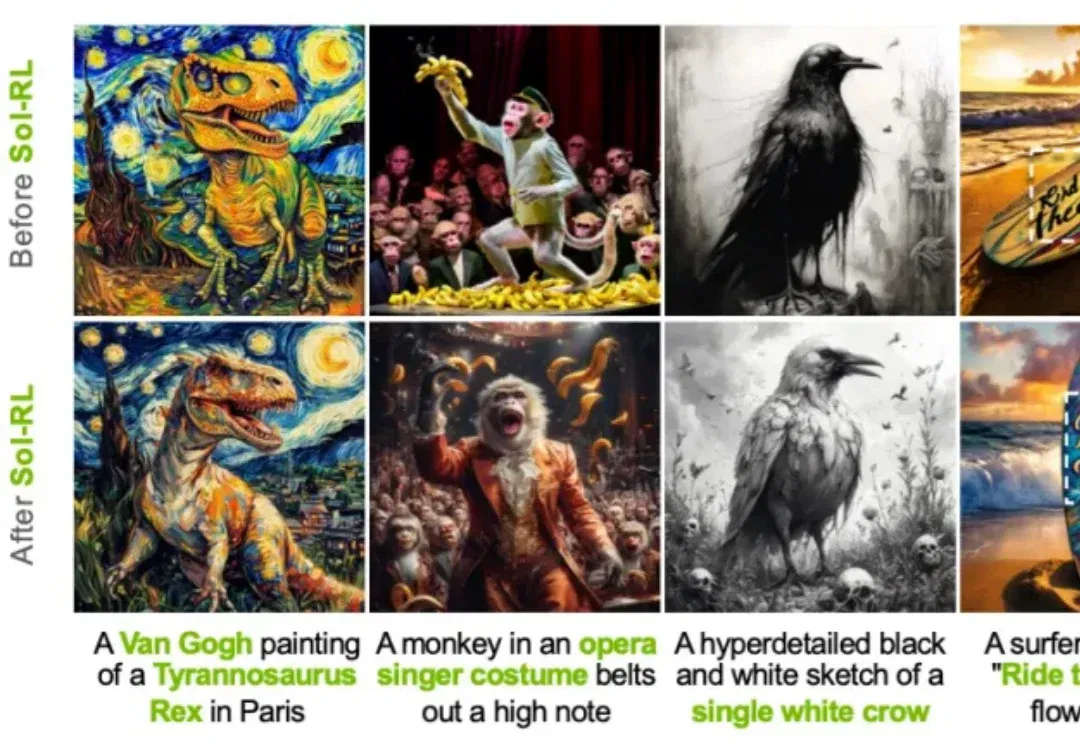
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。
智能体终于拥有了可以海量复制的“实战演练场”。阿里此次开源的新项目ROCK,解决了无法在真实环境中规模化训练的难题。有了ROCK,开发者想要训练AI执行复杂任务时可以不再“手搓”环境,直接进行标准化的一键部署。
本周「十字路口」,我们聊 FDE 这个正在被重新定义的岗位与分工:它究竟是在把“售前/交付”换个名字,还是代表 ToB AI 时代新的组织结构与商业边界?当模型越来越强,最后一公里为什么依然最难?企业真正缺的,到底是更强的模型,还是能把 AI 带进流程、接入系统、治理知识、持续迭代并对结果负责的人?