字节发完阿里发!Qwen-Image 2.0火线出击(在新窗口打开)
今天,阿里巴巴发布了新一代图像生成基础模型Qwen-Image 2.0,这一模型支持长达一千个token的超长指令、2k分辨率,并采用了更轻量的模型架构,模型尺寸远小于Qwen-Image 2.0的20B,带来更快的推理速度。
共 15 篇
今天,阿里巴巴发布了新一代图像生成基础模型Qwen-Image 2.0,这一模型支持长达一千个token的超长指令、2k分辨率,并采用了更轻量的模型架构,模型尺寸远小于Qwen-Image 2.0的20B,带来更快的推理速度。
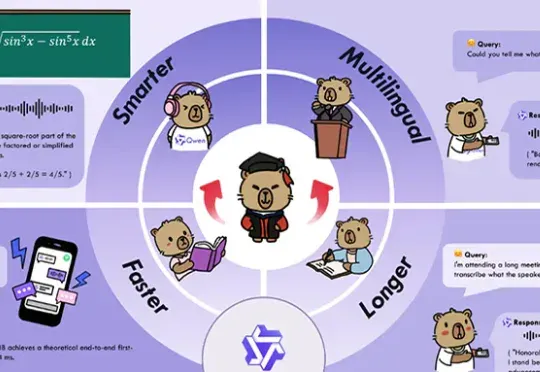
深夜,阿里通义大模型团队连放三个大招:开源原生全模态大模型Qwen3-Omni、语音生成模型Qwen3-TTS、图像编辑模型Qwen-Image-Edit-2509更新。Qwen3-Omni能无缝处理文本、图像、音频和视频等多种输入形式,并通过实时流式响应同时生成文本与自然语音输出。
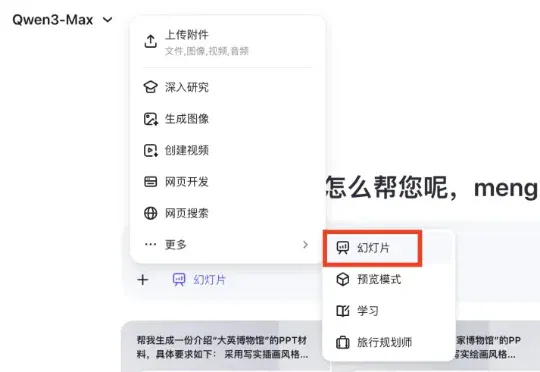
千问前脚刚把Qwen-Image-2.0甩出来,后脚就又放大招,冲着牛马党学生党的「痛处」下手了——就在这两天,重磅发布了AI PPT生成工具:Qwen AI Slides(幻灯片),据说从内容结构到视觉配图,一套全包……
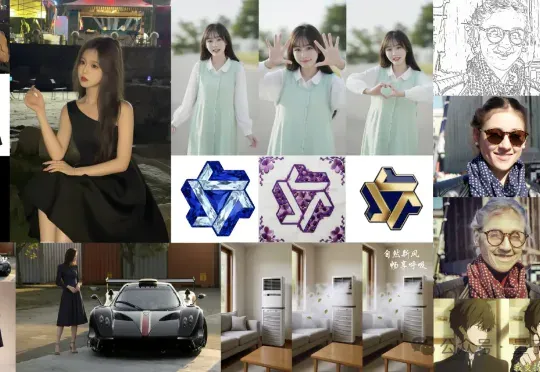
刚刚,Qwen推出了新图像编辑模型——Qwen-Image-Edit-2509。不仅支持多图融合,提供“人物+人物”,“人物+商品”,“人物+场景” 等多种玩法,还增强了人物、商品、文字等单图一致性。
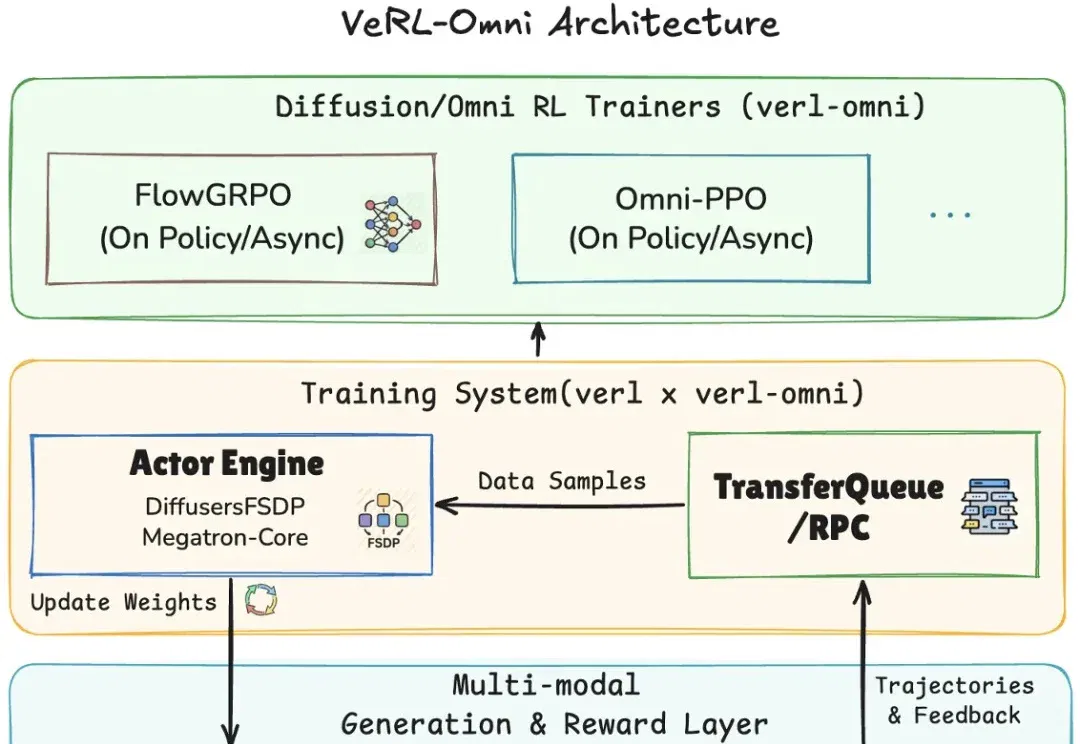
VeRL-Omni 是一个面向多模态生成模型的通用 RL 后训练框架,由 VeRL-Omni 团队在 verl 与 vllm-omni 之上构建。覆盖扩散 transformer(Qwen-Image)、混合 AR-DiT(Qwen-Omni)、统一理解 + 生成(BAGEL、HunyuanImage-3.0)等架构。
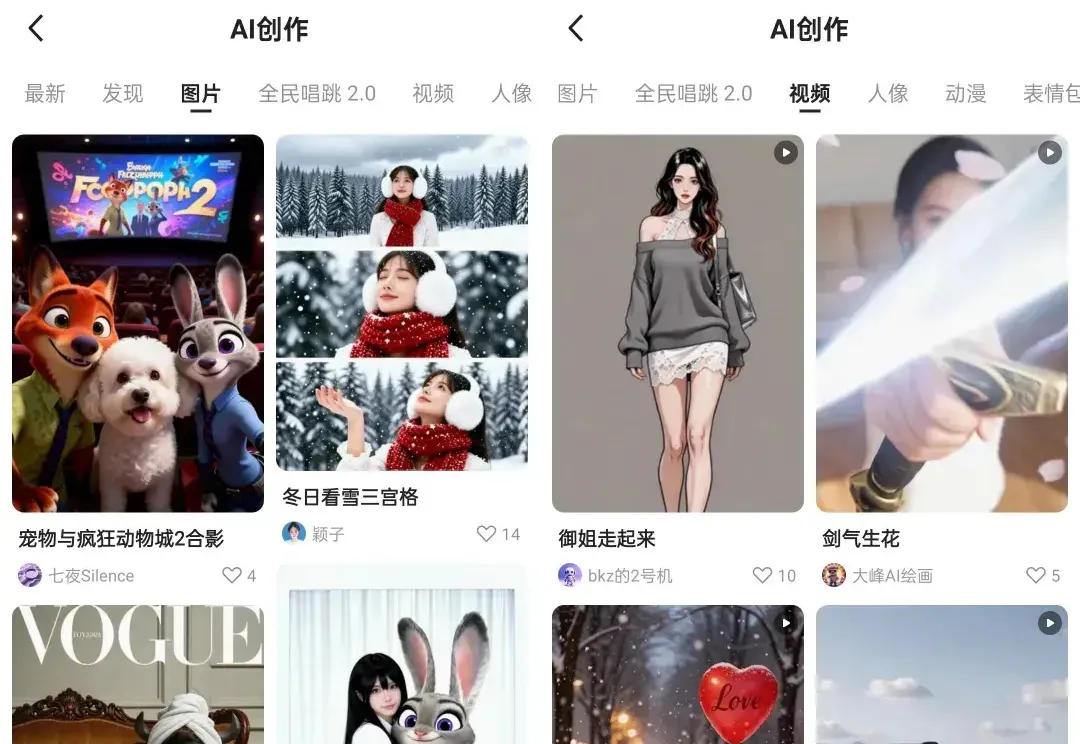
千问 App,大家都用上了吧? 这个被阿里委以重任的 AI 应用,今天迎来了一波史诗级更新:正式接入了阿里最强的两大视觉模型 —— Qwen-Image 和 Wan 2.5。 在 Hugging Face 等开源社区,Qwen-Image 系列模型长期霸榜,被全球开发者玩出了花;而 Wan 2.5 则是业内少有、具备「原生音画同步」能力的视频生成新贵。 但过去,想用上这些 SOTA 模型,你得会跑代码、部署 ComfyUI,或者苦等海外大厂的内测资格。 今天,门槛消失了。 千问 App 将这两大顶流模型深度整合,让普通用户在手机上也能拥有一座「掌上影像工作室」。 我们第一时间实测了这项更新,结
今天,阿里通义团队发布了他们第三代图像生成模型:Qwen-Image-3.0 。官方博客用了一个字来概括这一代的核心进步,「实」。不是好看,不是炫技,是「实」。内容丰实、细节真实、知识厚实。
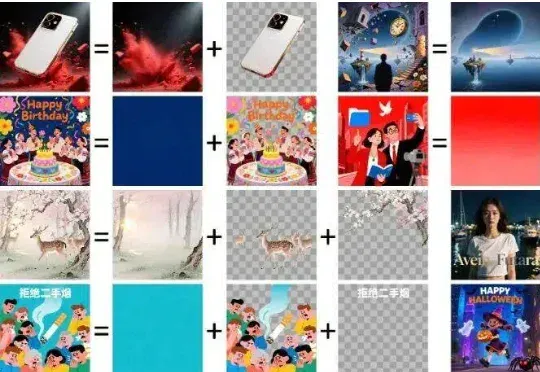
抽奖式的生图体验,确实让很多设计师在尝鲜之后又默默打开了 Photoshop。于是乎,阿里千问团队再次出手,开源了一个叫 Qwen-Image-Layered 的模型,试图从底层逻辑上解决这个问题。
UiT 架构探路者,底牌还没亮。 2026 年 5 月,智象未来开源了文生图模型 HiDream-O1-Image(8B),直接登顶 Artificial Analysis 开源模型全球第一,Elo 1187 的分数力压 Qwen Image(27B)和 FLUX.2 dev。值得注意的是,这也是 Artificial Analysis 榜单前十中唯一的开源模型。 但消息一出,有人说最强一代开源文生图模型“实至名归”,却也有人直接骂“生成质量一坨”。Artificial Analysis 可不是随便哪里冒出来的野生榜单,盲测 Arena 里都是用户实时投票打出来的结果。 两极分化的评价让我们感
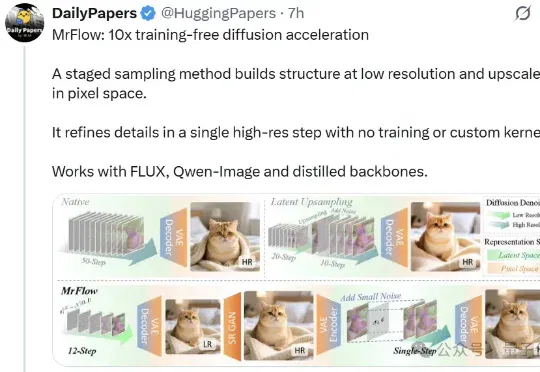
MrFlow(Multi-Resolution Flow Matching)就用这样的三阶段,在Qwen-Image等模型上把端到端生成时间从49.32s压到4.77s,实际加速10.35x。文章发布当日即登上Hugging Face Daily Papers;发布三天内,GitHub已收获200+stars;目前也已登上Hugging Face Trending Papers。