ICLR2026 Oral | 当情感识别不再是分类题:EmotionThinker 让 SpeechLLM 学会“解释情绪”(在新窗口打开)
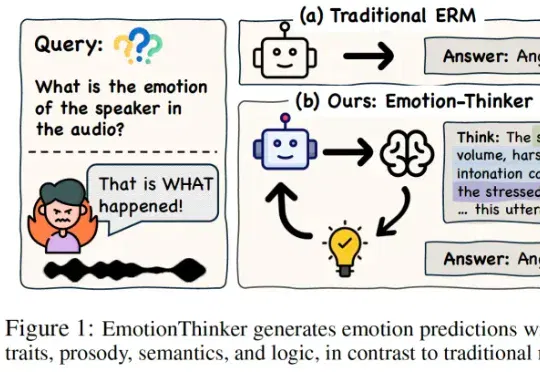
SpeechLLM 是否具备像人类一样解释 “为什么” 做出情绪判断的能力?为此,研究团队提出了EmotionThinker—— 首个面向可解释情感推理(Explainable Emotion Reasoning)的强化学习框架,尝试将 SER 从 “分类任务” 提升为 “多模态证据驱动的推理任务”。
共 17 篇
SpeechLLM 是否具备像人类一样解释 “为什么” 做出情绪判断的能力?为此,研究团队提出了EmotionThinker—— 首个面向可解释情感推理(Explainable Emotion Reasoning)的强化学习框架,尝试将 SER 从 “分类任务” 提升为 “多模态证据驱动的推理任务”。
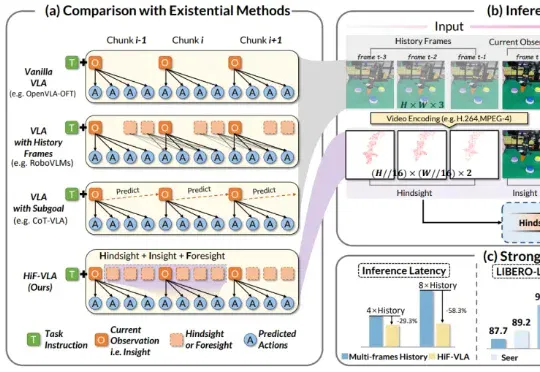
来自西湖大学、浙江大学、西湖机器人等机构的研究团队提出了一种以运动(Motion)为中心的全新双向时空推理框架 HiF-VLA。抛弃冗余的像素级输入,HiF-VLA 巧妙提取低维紧凑的 Motion 向量作为动态先验,在一个创新的「联合专家」模块中,同步完成未来视觉运动的预测与高精度动作序列的生成。
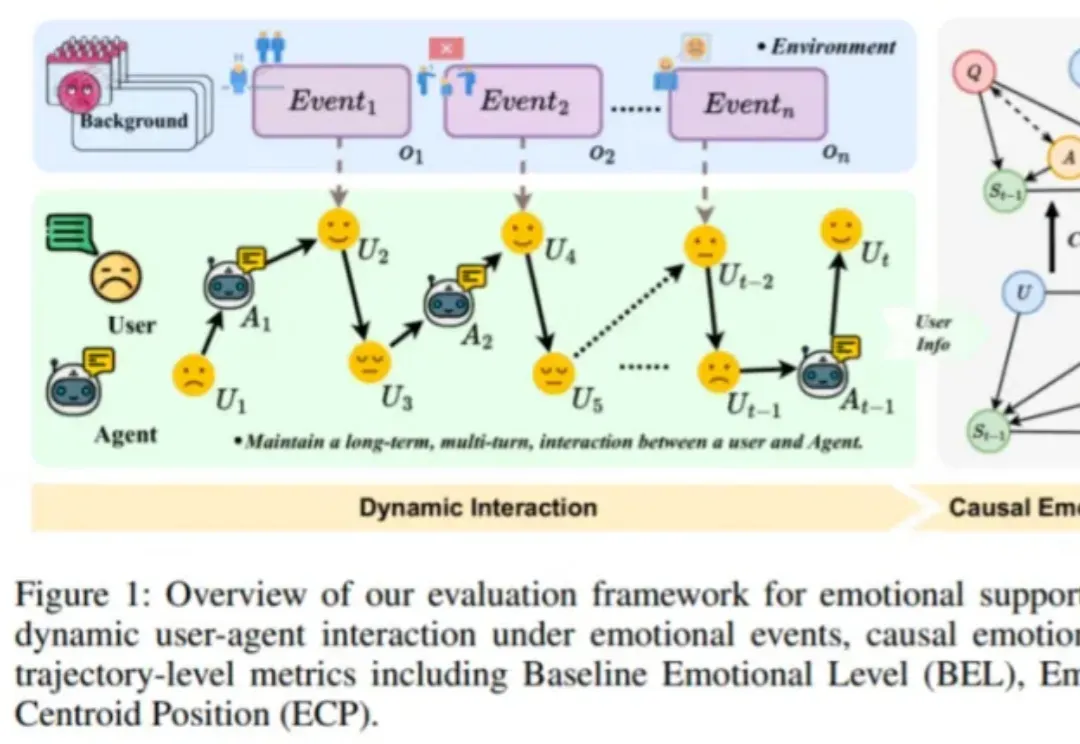
近日,由趣丸科技与北京大学软件工程国家工程研究中心共同发表的《Detecting Emotional Dynamic Trajectories: An Evaluation Framework for Emotional Support in Language Models(检测情感动态轨迹:大语言模型情感支持的评估框架)》论文,获 AAAI 2026 录用。
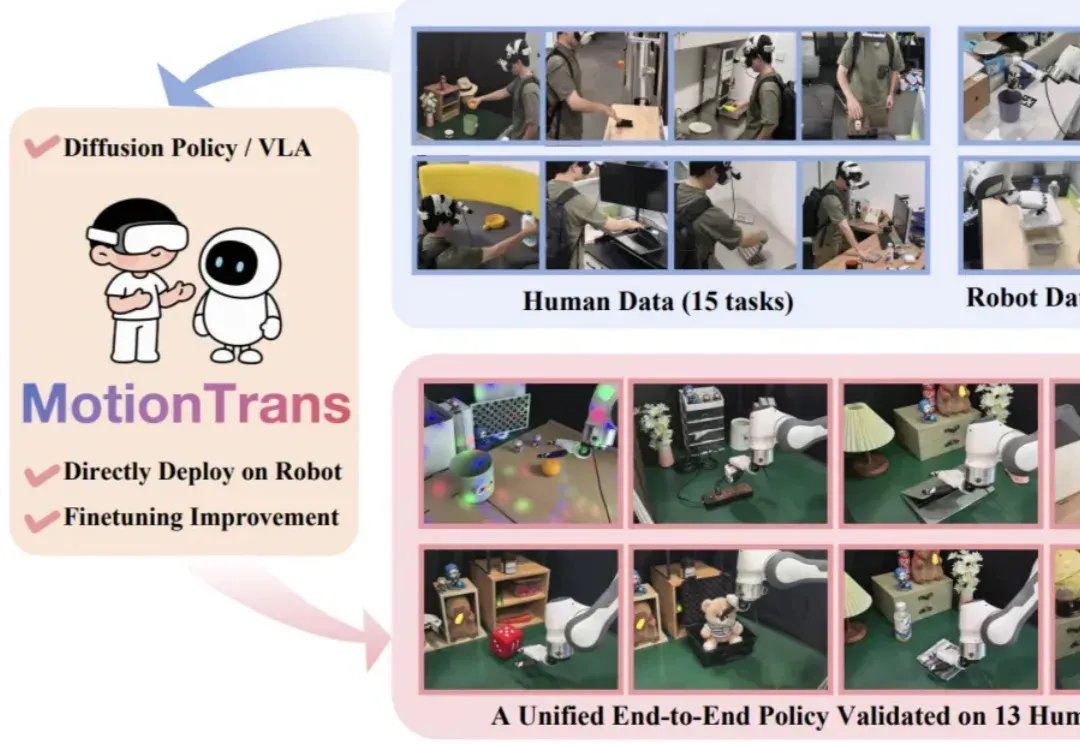
近期,Google DeepMind 发布新一代具身大模型 Gemini Robotics 1.5,其核心亮点之一便是被称为 Motion Transfer Mechanism(MT)的端到端动作迁移算法 —— 无需重新训练,即可把不同形态机器人的技能「搬」到自己身上。不过,官方技术报告对此仅一笔带过,细节成谜。
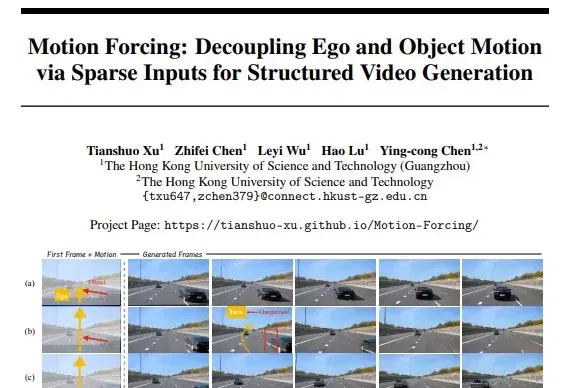
港科大(广州)团队在 Waymo 数据集的 100 段样本上比较生成效果。Motion Forcing 在所用的运动连贯性与物理合理性指标上得分更优。
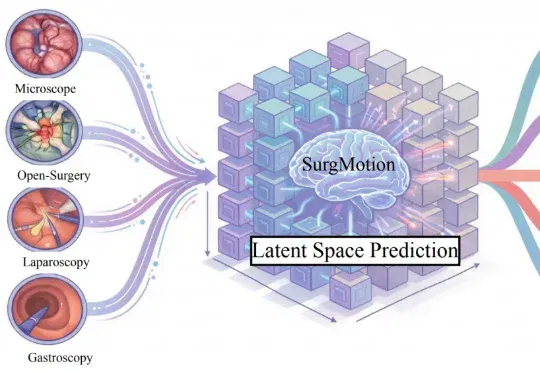
手术 AI 正在从 “单帧感知” 迈向 “全流程视频理解” 的全新时代!近日,由中国科学院香港创新研究院人工智能与机器人创新中心领衔,发布了全球首个十亿级参数、最大规模数据集练成的手术视频原生基础模型 ——SurgMotion!
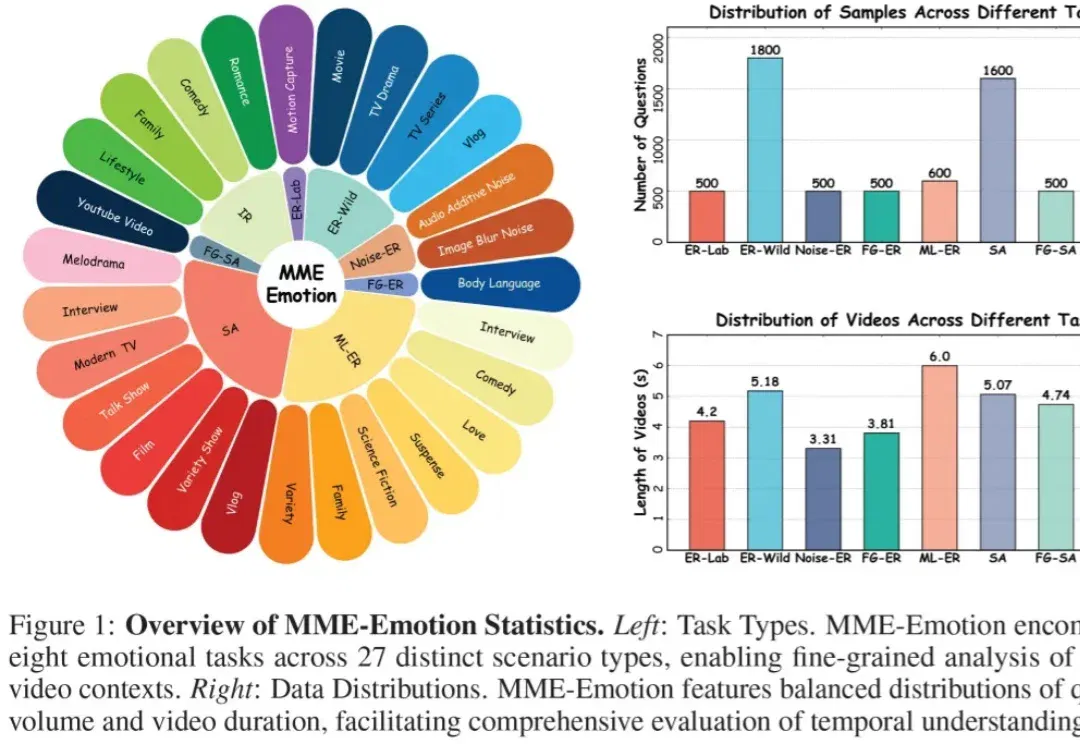
近年来,多模态大模型(Multimodal Large Language Models, MLLMs)正在迅速改变人工智能的能力边界。从图像理解到视频分析,从语音对话到复杂推理,大模型正在逐步具备类似人类的综合感知能力。但一个关键问题仍然没有得到充分回答:这些模型真的能够理解人类情绪吗?
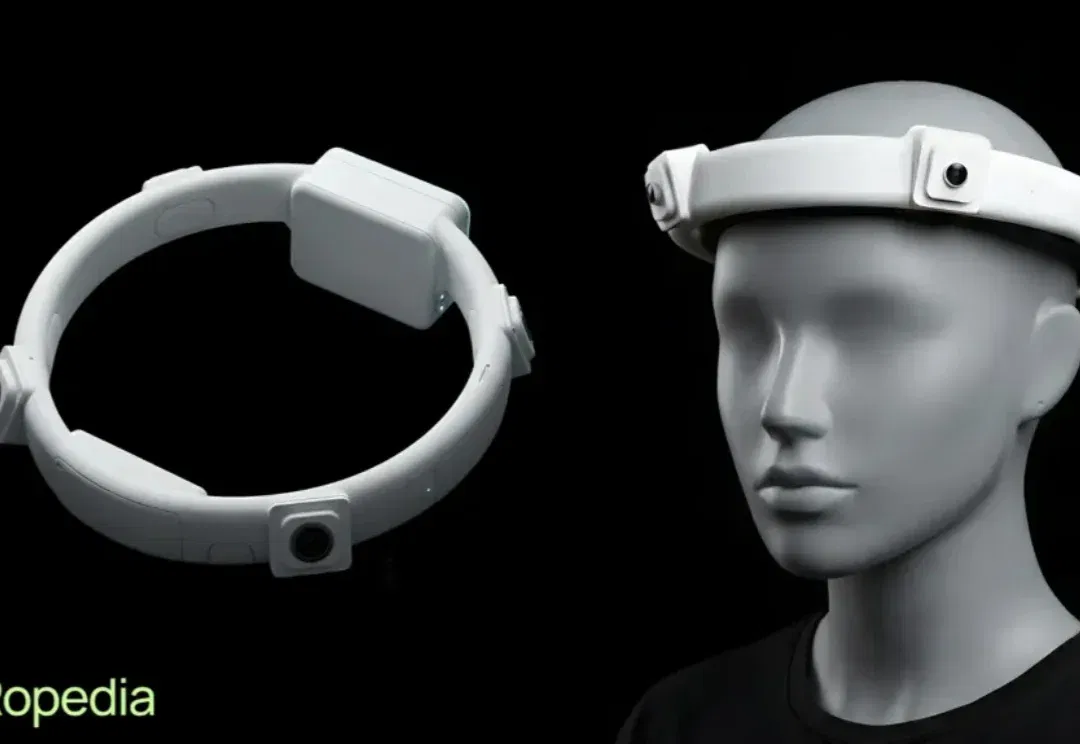
天使轮由一线美元基金,智能制造与大模型产业方共同领投;数据集 Xperience-10M 位列全平台数据集榜第 2 名,具身赛道第一名,目前已被多款具身基础模型 Qwen-VLA、MolmoMotion 等采用;多模态采集系统 HOMIE 进入规模化量产交付,新一代系统将于 2026 年 8 月发布。
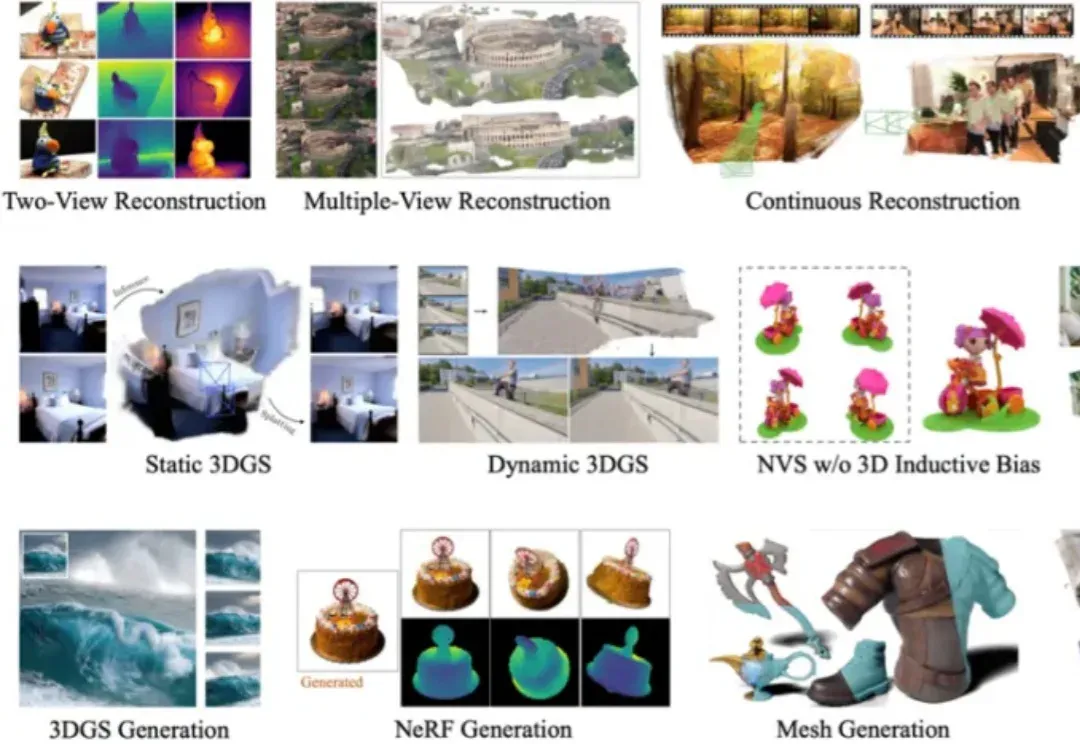
在 3D 视觉领域,如何从二维图像快速、精准地恢复三维世界,一直是计算机视觉与计算机图形学最核心的问题之一。从早期的 Structure-from-Motion (SfM) 到 Neural Radiance Fields (NeRF),再到 3D Gaussian Splatting (3DGS),技术的演进让我们离实时、通用的 3D 理解越来越近。
报道表示其同时保留Boson AI职务,双方计划结合模型与产业场景,推进商业世界模型及销售营销智能体。