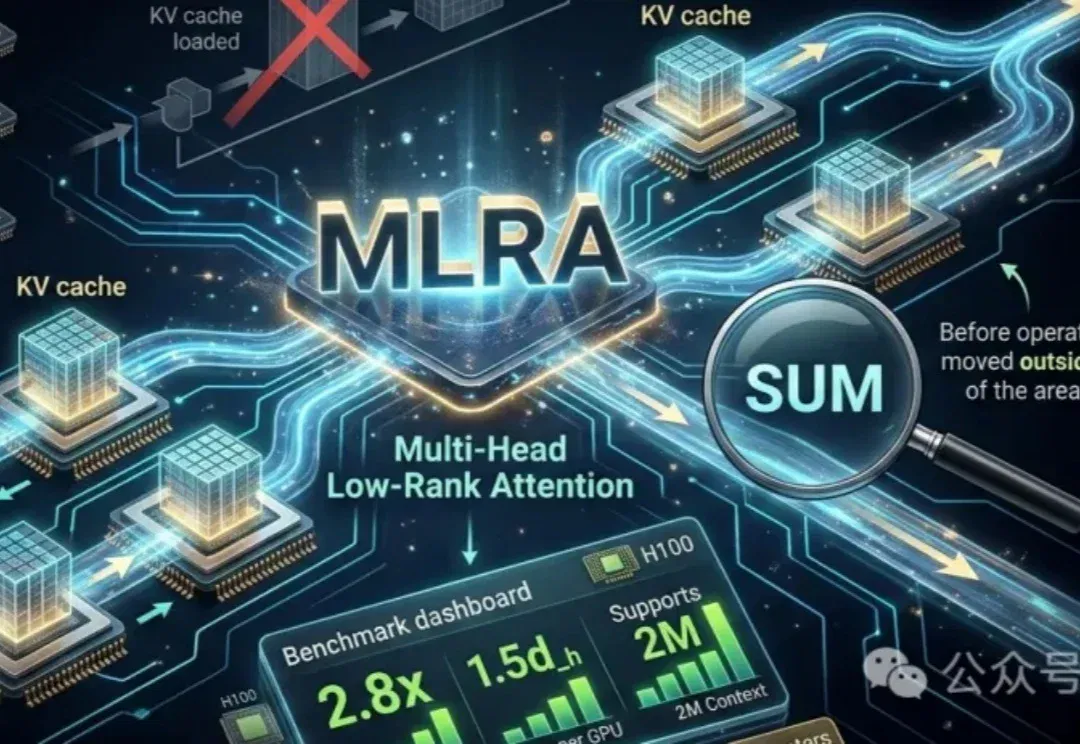
超越MLA!新架构MLRA百万token,解码最高2.8倍速 | ICLR'26(在新窗口打开)
MLRA通过拆分KV缓存为四个并行分支,显著降低显存占用并实现4路张量并行。推理速度比MLA最高快2.8倍,支持百万级上下文,且模型质量更优。无需牺牲性能,即可高效扩展长文本处理能力。
共 16 篇
MLRA通过拆分KV缓存为四个并行分支,显著降低显存占用并实现4路张量并行。推理速度比MLA最高快2.8倍,支持百万级上下文,且模型质量更优。无需牺牲性能,即可高效扩展长文本处理能力。
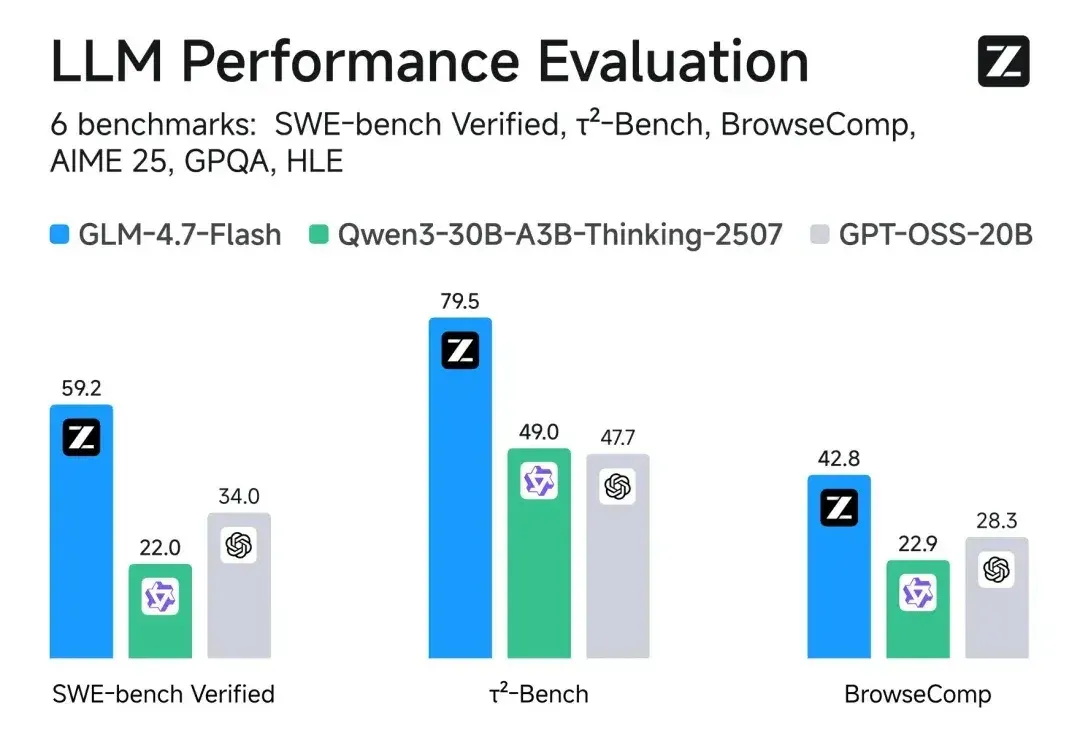
智谱AI上市后,再发新成果。 开源轻量级大语言模型GLM-4.7-Flash,直接替代前代GLM-4.5-Flash,API免费开放调用。 这是一个30B总参数、仅3B激活参数的混合专家(MoE)架构模型,官方给它的定位是“本地编程与智能体助手”。 在SWE-bench Verified代码修复测试中,GLM-4.7-Flash拿下59.2分,“人类最后的考试”等评测中也显著超越同规模的Qwen3-30B和GPT-OSS-20B。 作为去年12月发布的旗舰模型GLM-4.7的轻量化版本,GLM-4.7-Flash继承了GLM-4系列在编码和推理上的核心能力,同时针对效率做了专门优化。 除了编程
MMLab@NTU联合中山大学的最新研究,给出了一份从入门到精通的终极“菜谱”——VLANeXt。这项研究没有简单提出一个新模型了事,而是系统性地从12个关键维度,深度剖析了VLA的设计空间。从基础组件到感知要素,再到动作建模的额外视角,每一步都有扎实的实验支撑。
DeepSeek开源面向华为昇腾算力平台的基础设施组件,涵盖TileLang编译工具及DeepGEMM、DeepEP、TileKernels、FlashMLA、DeepSelect等计算与通信库,华为亦在CANN社区开源双方围绕昇腾950及超节点的联合创新实践。
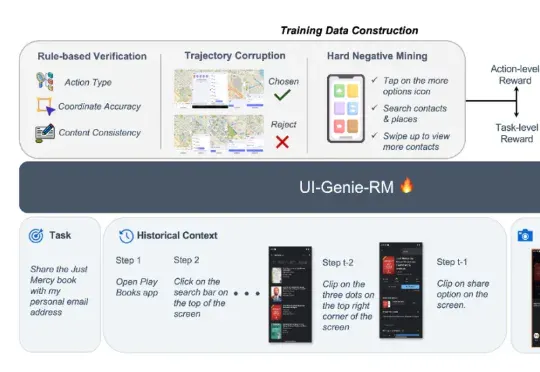
本文来自于香港中文大学 MMLab 和 vivo AI Lab,其中论文第一作者肖涵,主要研究方向为多模态大模型和智能体学习,合作作者王国志,研究方向为多模态大模型和 Agent 强化学习。项目 le
ForgeKernel 通过架构里程碑、硬件经验积累和实测反馈生成优化算子。团队展示了在 B200 上从数学定义出发优化 FlashMLA Prefill 的过程,并介绍昇腾评测与训练框架接入;单个算子的加速幅度不能直接折算为整机性能或全球算力开支节省。
过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
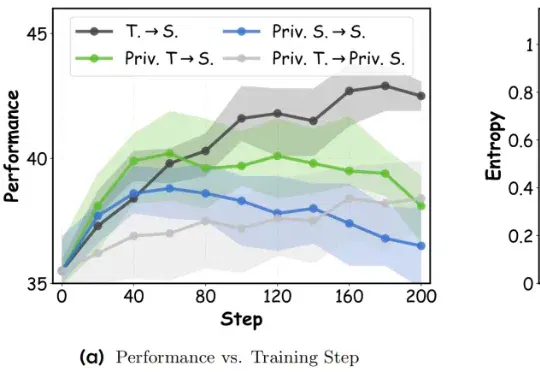
最近,来自新加坡国立大学、香港中文大学 MMLab、北京大学和京东探索研究院的研究团队提出了一种全新的在线策略蒸馏方法: DOPD (Dual On-policy Distillation) ,通过优势感知的双重蒸馏范式,成功破解了这一难题。
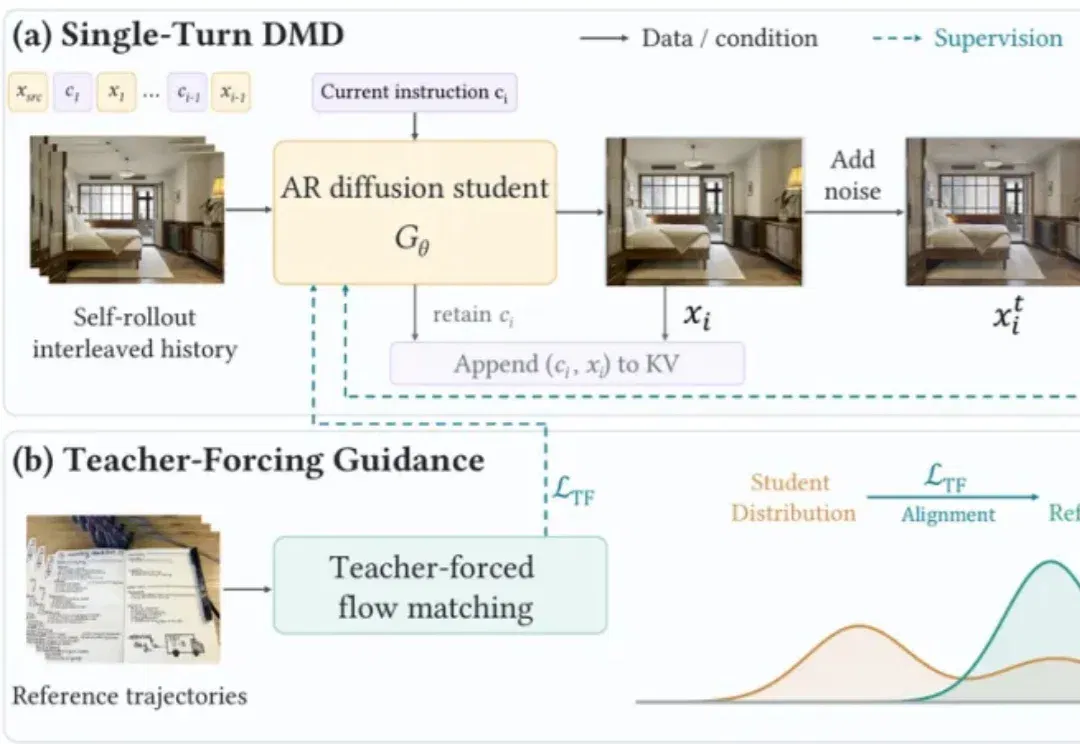
MT Forcing 让图像编辑学生模型接着自身输出训练,以单轮教师提供画质参照,再用参考轨迹约束内容延续。在两种SenseNova基座、100组八轮会话中,后期编辑稳定性改善;首轮部分指标仍低于基线。
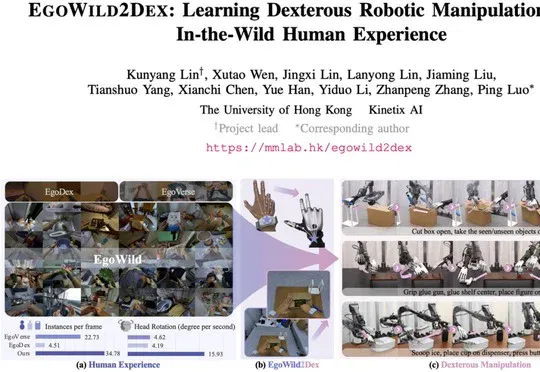
香港大学MMLab团队提出EgoWild2Dex,利用538.9小时真实人类第一视角数据训练机器人,每个下游任务使用不到1小时真机数据微调,拆快递、用热熔胶枪固定摆件和制作冰饮等任务的平均成功率达96.7%。