速递|开源AI模型运行工具Ollama融资6500万美元,团队仅14人,月活890万开发者(在新窗口打开)
流行的开源人工智能工具 Ollama 完成了 6500 万美元的 B 轮融资,由 Theory Ventures 领投,创始人兼首席执行官 Jeff Morgan 告诉 TechCrunch。Ollama 于 2023 年推出,帮助开发者在其个人电脑上运行开源权重的 AI 模型,让它们在数分钟内即可启动运行。
共 35 篇
流行的开源人工智能工具 Ollama 完成了 6500 万美元的 B 轮融资,由 Theory Ventures 领投,创始人兼首席执行官 Jeff Morgan 告诉 TechCrunch。Ollama 于 2023 年推出,帮助开发者在其个人电脑上运行开源权重的 AI 模型,让它们在数分钟内即可启动运行。
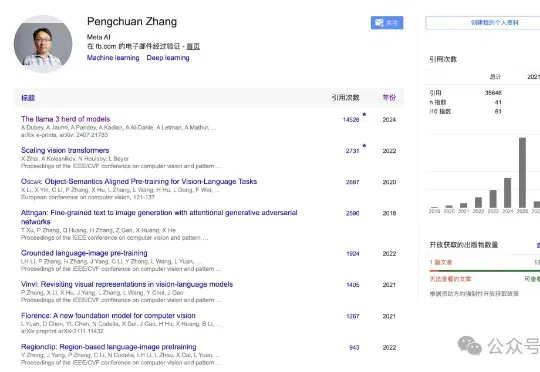
刚刚,毕业清华大学数学系,曾在Meta FAIR工作3.75年、主导过SAM与Llama多项核心工作的研究员张鹏川(Pengchuan Zhang)宣布离职。他的下一站,是来到OpenAI,投身于世界模拟与机器人学(World Simulation and Robotics)方向的研究。
Clawdbot火爆全球,国产算力却不能用?AI Agent迎来高光时刻:Ollama只支持CUDA,中国团队直接把国产版开源了!正面硬刚Ollama,5分钟让国产芯片跑通OpenClaw!
2026 年 3 月底,Ollama 发布了一则更新公告:其 Mac 版本的底层推理引擎,将从沿用多年的 llama.cpp 切换为苹果的 MLX 框架。
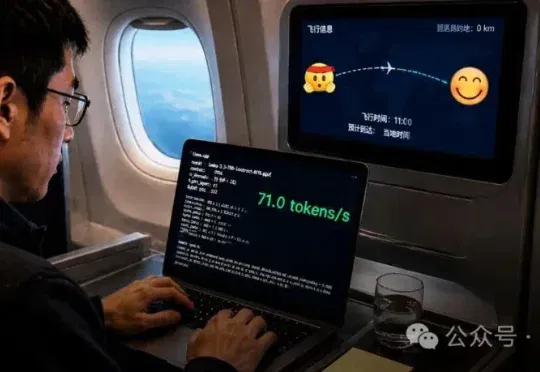
一位中国开发者,在横跨大西洋的航程中,在飞机上用 MacBook 本地跑 Llama 70B,整整 11 小时没有网络,帖子瞬间在X上爆火!但是随后,越来越多网友发现,这故事不太对啊?
过去,LlamaFactory 让每个人都能微调大模型;现在,PenguinHarness 希望让每个人都能构建自进化 Agent。
图灵奖大佬LeCun离职Meta后直接开怼:实锤Llama4造假传闻,炮轰原上司Alexandr Wang「不懂科研」,称Meta冲刺「超级智能」完全是被大模型洗脑。同时,他也透露自己的新公司即将在今年发布全新世界模型。
Llama4性能造假丑闻,OpenAI烧钱的速度远超过了盈利能力;另外一方面:国产模型凭借足够强大的性能与超高性价比,迅速占领了国际开源模型市场。是时候再次为国产AI鼓掌了!
几周前,我们发布了 jina-embeddings-v4 模型的 GGUF 版本,大幅降低了显存占用,提升了运行效率。不过,受限于 llama.cpp 上游版本的运行时,当时的 GGUF 模型只能当作文本向量模型使用而无法支持多模态向量的输出。
过去几年,大语言模型(LLM)的训练大多依赖于基于人类或数据偏好的强化学习(Preference-based Reinforcement Fine-tuning, PBRFT):输入提示、输出文本、获得一个偏好分数。这一范式催生了 GPT-4、Llama-3 等成功的早期大模型,但局限也日益明显:缺乏长期规划、环境交互与持续学习能力。