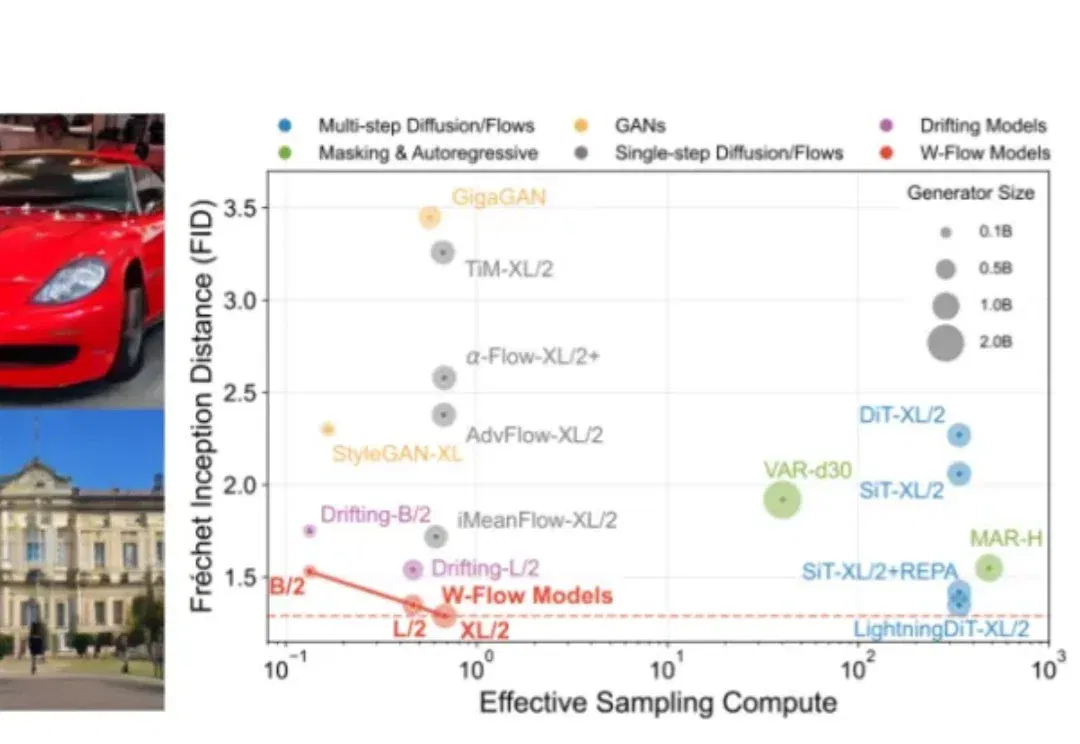
一步生成 ImageNet FID 1.29!斯坦福用 Wasserstein 梯度流重写一步生成模型(在新窗口打开)
训练时让分布沿最优传输的 “下山方向” 走,推理时只需一次网络前向。W-Flow 把多步演化压进静态生成器,在 ImageNet 256×256 上刷新一步生成指标。
共 19 篇
训练时让分布沿最优传输的 “下山方向” 走,推理时只需一次网络前向。W-Flow 把多步演化压进静态生成器,在 ImageNet 256×256 上刷新一步生成指标。
在开放研究领域里,苹果似乎一整个脱胎换骨,在纯粹的研究中经常会有一些出彩的工作。这次苹果发布的研究成果的确出人意料:他们用谷歌的 Nano-banana 模型做个了视觉编辑领域的 ImageNet。
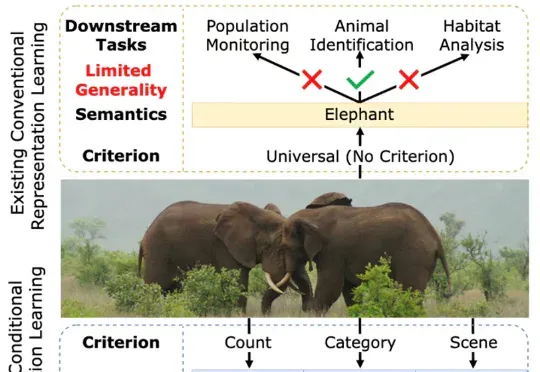
一张图片包含的信息是多维的。例如下面的图 1,我们至少可以得到三个层面的信息:主体是大象,数量有两头,环境是热带稀树草原(savanna)。然而,如果由传统的表征学习方法来处理这张图片,比方说就将其送入一个在 ImageNet 上训练好的 ResNet 或者 Vision Transformer,往往得到的表征只会体现其主体信息,也就是会简单地将该图片归为大象这一类别。这显然是不合理的。
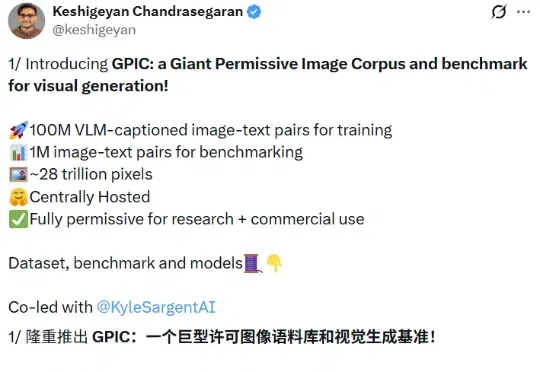
就在前两天,斯坦福大学等机构发布了一个名为 GPIC(Giant Permissive Image Corpus,巨型开放图像语料库)的数据集。
答案或许渐渐清晰。李飞飞团队与斯坦福 AI 实验室正式官宣:首届 BEHAVIOR 挑战赛将登陆 NeurIPS 2025。这是一个为具身智能量身定制的 “超级 benchmark”,涵盖真实家庭场景下最关键的 1000 个日常任务(烹饪、清洁、整理……),并首次以 50 个完整长时段任务作为核心赛题,考验机器人能否在逼真的虚拟环境中完成真正贴近人类生活的操作。
REG 是一种简单而有效的方法,仅通过引入一个 class token 便能大幅加速生成模型的训练收敛。其将基础视觉模型(如 DINOv2)的 class token 与 latent 在空间维度拼接后共同加噪训练,从而显著提升 Diffusion 的收敛速度与性能上限。在 ImageNet 256×256 上,
苏度科技联合创始人、董事长苏昊是ImageNet的核心作者之一,师从李飞飞。这家公司走了一条与硅谷主流“纯大脑黑盒大模型”不太一样的路:软硬件协同设计,上下分层架构,上层负责任务规划与环境理解,下层负责具体物体操作;Sim-to-Real作为核心训练范式,让机器人在虚拟世界里经历几百万年的进化,再迁移到现实。
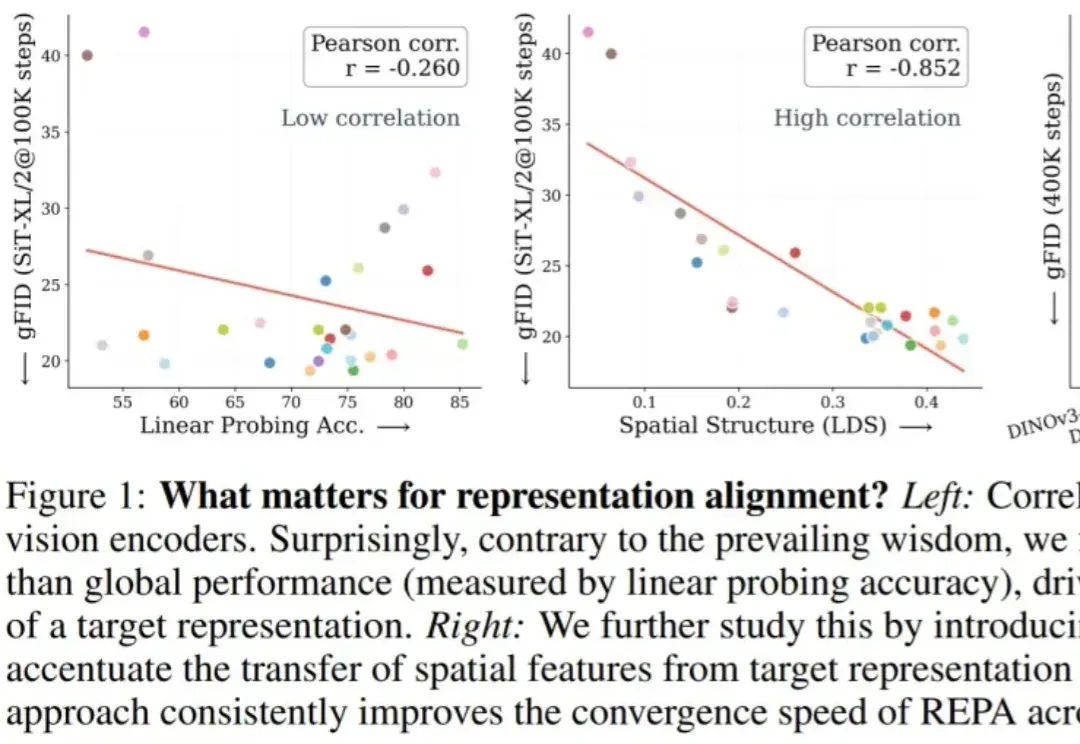
邹忌曾经有一个问题:吾与徐公孰美? 而对于 REPA,也有一个类似的问题:全局信息与空间结构,哪个对表征对齐更重要? 表征对齐(REPA)可通过将强大的预训练视觉编码器的表征蒸馏为中间扩散特征,来指导生成式训练。该方法于去年十月份问世,一直以来都备受关注,已成为加速扩散 Transformer(Diffusion Transformers)训练的一项有力技术。参阅报道《扩散模型训练方法一直错了!谢赛宁:Representation matters》。 但是,其还有一个很基本的问题悬而未决:对生成而言,目标表征的哪个方面更重要?是其「全局」语义信息(例如,以 ImageNet-1K 准确率衡量)
近日,RoboChallenge 重磅推出!这是全球首个大规模、多任务的在真实物理环境中由真实机器人执行操作任务的基准测试。
李飞飞团队最新发布ESI-Bench——一个专门用来评测具身空间智能的新基准。过去的空间智能评测默认给模型最优观测,而ESI-Bench第一个把观察者变成行动者,闭合了感知-行动回路。