搜索

关于“Gemma”的结果

共 28 篇

谷歌开源26B文本扩散MoE,劈柴:生成速度像赛马一样快

谷歌开源26B文本扩散MoE,劈柴:生成速度像赛马一样快(在新窗口打开)

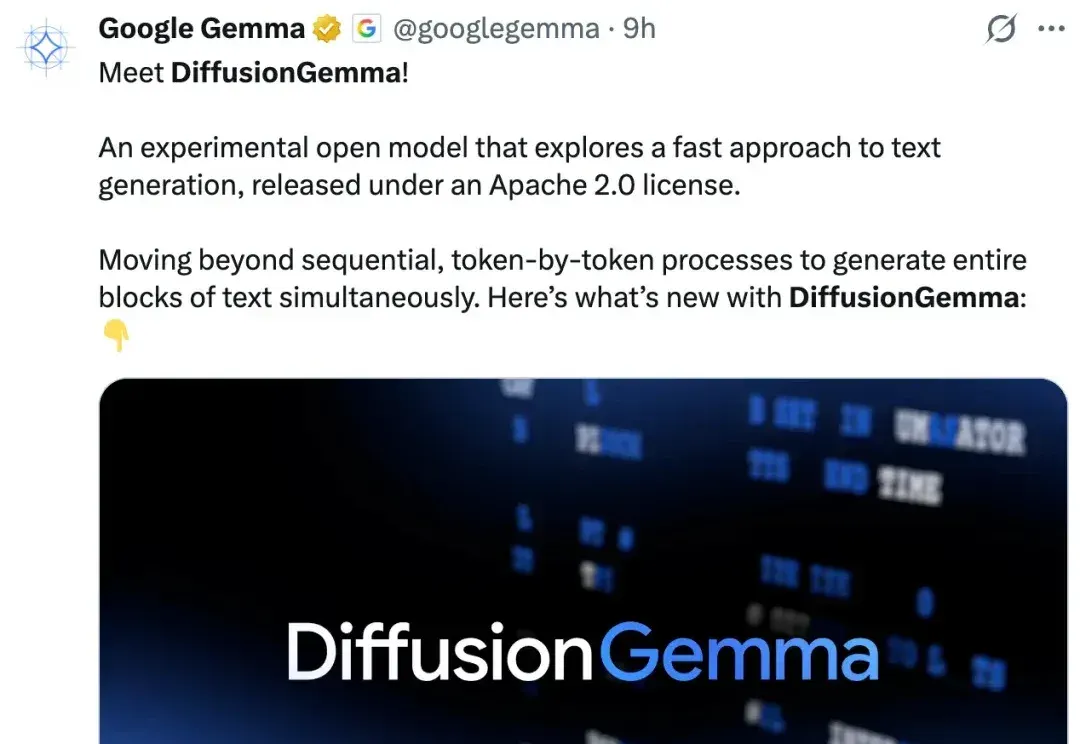
今天一早,谷歌又发新模型了! Gemmna 家族有了新成员 ——DiffusionGemma,一个探索文本扩散的实验性开源模型,在文本生成任务上速度极快。 根据官方介绍,DiffusionGemma 采用了 Apache 2.0 许可证发布,是一个 26B 规模的混合专家模型(MoE)。 该模型没有沿用典型自回归大语言模型(LLM)那种按顺序、逐 token 生成的方式,而是可以同时生成整块文本,在 GPU 上,文本生成速度最高可提升至 4 倍。 DiffusionGemma 建立在 Gemma 4 家族业界领先的「每参数智能水平」之上,同时吸收了 Gemini Diffusion 的前沿研究
AI资讯
0
重磅!谷歌开源Gemma 4 12B:统一的、无编码器的多模态模型,16G内存笔记本就可以跑

重磅!谷歌开源Gemma 4 12B:统一的、无编码器的多模态模型,16G内存笔记本就可以跑(在新窗口打开)

刚刚,谷歌DeepMind发布了Gemma 4 12B。一句话概括这个模型的定位:把原本需要高端服务器才能跑的多模态智能,装进你的笔记本电脑里。它填补的是Gemma家族里一个关键空缺:比边缘端的E4B更强,比26B混合专家模型(MoE)更轻。而且在整个Gemma 4系列里,它是第一个支持原生音频输入的中等规模模型。

AI资讯
0
谷歌的Gemma-4-31B适合哪些人?值得你放弃Qwen3.5-27B吗?深度调研战略报告

谷歌的Gemma-4-31B适合哪些人?值得你放弃Qwen3.5-27B吗?深度调研战略报告(在新窗口打开)

Gemma4 31B的发布,在开源模型社区引发了巨大的关注。面对这款由谷歌DeepMind于2026年4月2日 推出的重磅模型,很多技术团队和本地部署玩家都在问同一个问题:Gemma4的出现,到底是在开辟一条新的本地部署路线,还是只是给高端玩家多了一个可选项?我们到底需不需要把现有的Qwen3.5 27B工作流整体迁移过去?

AI技术文章
0
只要24GB 内存,能在本地 Mac上跑无限制的Gemma 4 31B了

只要24GB 内存,能在本地 Mac上跑无限制的Gemma 4 31B了(在新窗口打开)

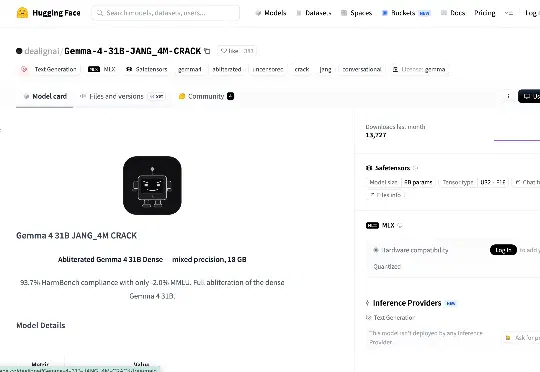
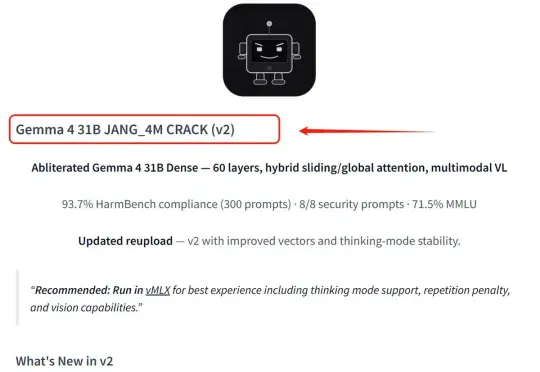
有个31B参数的大模型,正常需要80GB显存才能跑。但现在,24GB显存就能跑满血版。这个版本叫Gemma-4-31B-JANG_4M-CRACK——"CRACK"这个词不要理解歪了,它本质是量化压缩加上对齐微调之后的部署版本,不是什么黑客攻击,就是工程优化。24GB,MacBook Pro,直接跑。苹果用户优先优化,MLX原生支持,月下载13000次。

AI资讯
0
Mac用户可以在oMLX中使用TurboQuant了,搭配Gemma-4-31B,谷歌全家桶实测很能打!

Mac用户可以在oMLX中使用TurboQuant了,搭配Gemma-4-31B,谷歌全家桶实测很能打!(在新窗口打开)

对本地部署玩家,尤其是Mac用户来说,长上下文推理最大的痛点往往不是“模型不够聪明”,而是稍微多用点上下文,统一内存就被撑爆了”,这一点在最近的Gemma-4 31B的部署中尤为明显,在同等上下文的情况,显存占用比Qwen3.5-27B高约一倍不止,直接劝退了不少人。但好消息是,谷歌近期提出的TurboQuant KV缓存量化算法,正是为了解决这个痛点而生。

AI技术文章
0
英伟达GPU被SpaceX送上太空!在天上训练卡帕西的NanoGPT

英伟达GPU被SpaceX送上太空!在天上训练卡帕西的NanoGPT(在新窗口打开)

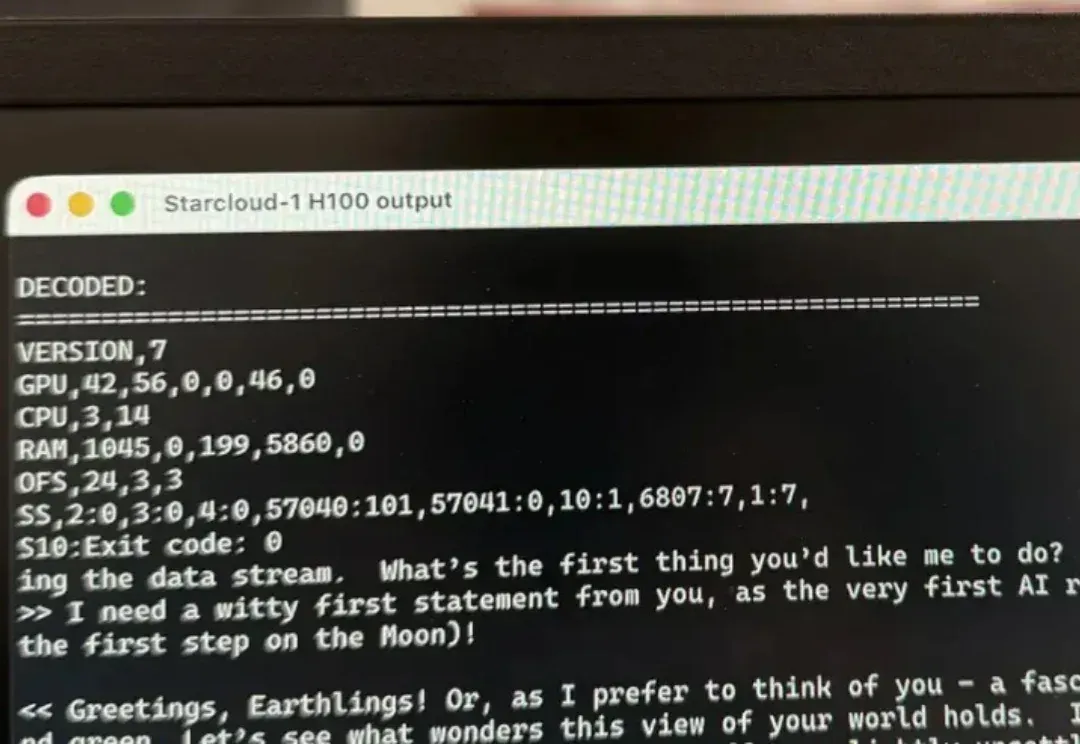
AI真的上天了。 人类首次实现了在太空训练、运行大模型。 而主角我们也很熟悉:英伟达、SpaceX、谷歌……还有前OpenAI联合创始人卡帕西的NanoGPT。 几个名字一出,故事就很明确了—— SpaceX火箭把英伟达H100芯片送上太空后,在轨道上运行了谷歌的开源AI大模型Gemma,并获取到了回应: 你们好,地球人! △图源:CNBC 除了Gemma之外,还在H100上用莎士比亚全集训练了卡帕西的大语言模型NanoGPT。 对此,网友有话说:以后外星人想研究地球就不用亲自来一趟了(doge)。 首次太空训练AI 上个月初,作为Nvidia Inception一员的、聚焦太空数据中心的初创

AI资讯
0