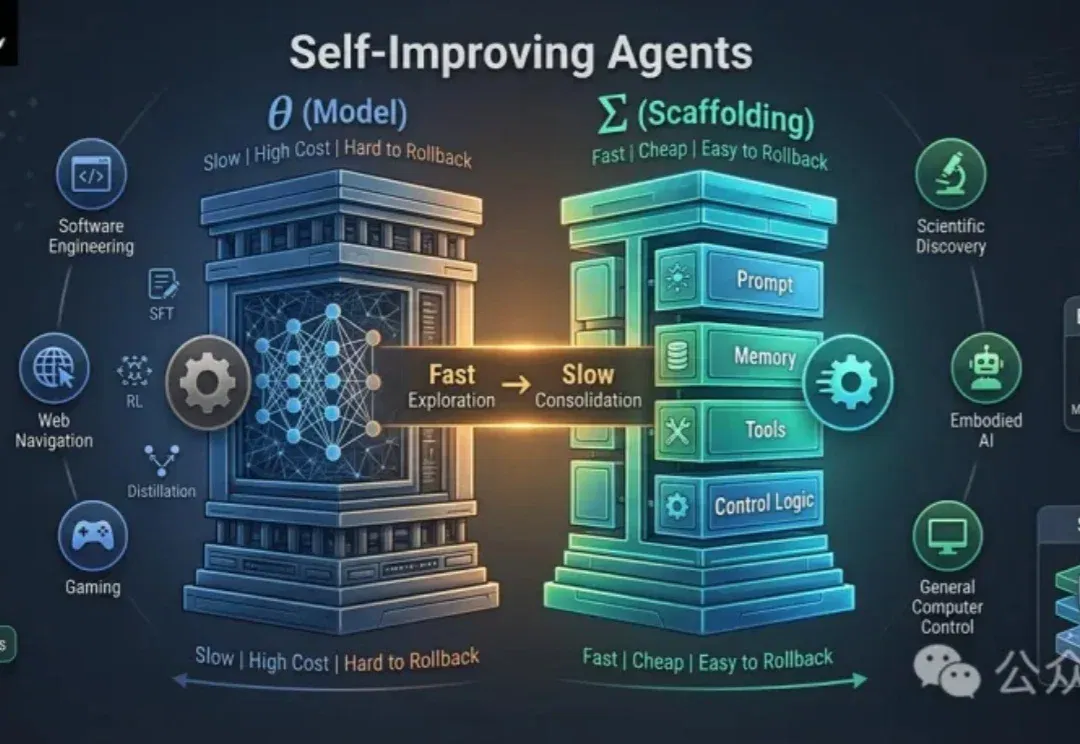
LSTM之父最新97页综述:Agent如何真正学会「自我进化」?(在新窗口打开)
过去两年,self-reflection、self-correction、self-play、agentic RL、skill learning、test-time adaptation、open-ended evolution、self-evolving agent等概念不断涌现。
共 54 篇
过去两年,self-reflection、self-correction、self-play、agentic RL、skill learning、test-time adaptation、open-ended evolution、self-evolving agent等概念不断涌现。
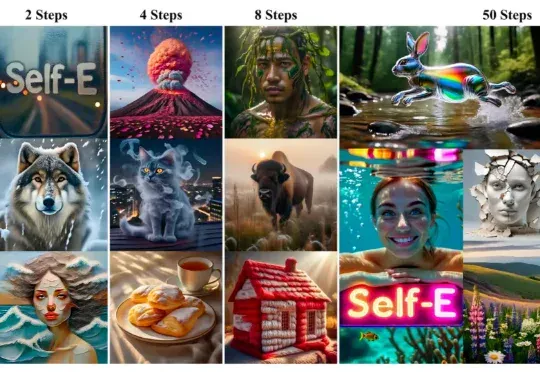
香港大学(The University of Hong Kong)与 Adobe Research 联合发布 Self-E(Self-Evaluating Model):一种无需预训练教师蒸馏、从零开始训练的任意步数文生图框架。其目标非常直接:让同一个模型在极少步数也能生成语义清晰、结构稳定的图像,同时在 50 步等常规设置下保持顶级质量,并且随着步数增加呈现单调提升。
何恺明,也下场做语言模型了。 只不过,这次他带队做的不是大家熟悉的、像ChatGPT背后那套“预测下一个词元”(next token prediction)的自回归范式。 而是另一条过去几年在图像领域大火、如今正被越来越多人搬进文本生成的新路线:扩散语言模型(Diffusion Language Model,DLM)。 在最新的论文中,何恺明团队放出全新连续扩散语言模型:ELF:Embedded Language Flows。 与不少还停留在token层面做扩散的语言模型不同,ELF把整个生成过程都留在了连续的embedding空间里,直到最后一步,才重新离散化,将表示变回token。 靠着这
2026年,Recursive Self-Improvement(RSI,递归式自我改进)开始从论文中的长期命题,变成了AI产业议程上一个新的赛道。学术界开始把RSI从分散研究方向变成一个独立议题。4月,ICLR首次为Recursive Self-Improvement(RSI,递归式自我改进)单独办了一场Workshop。
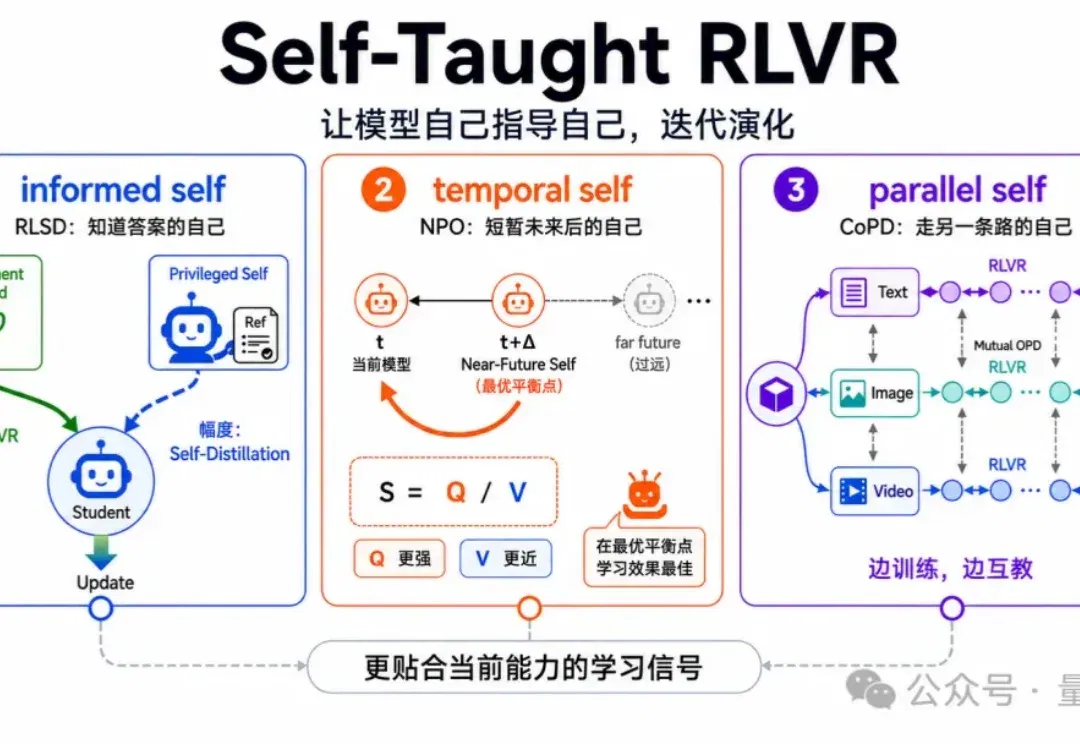
最近,京东和中科院信工所展开了Self-Taught RLVR的系列研究,并连发三篇后训练新作。
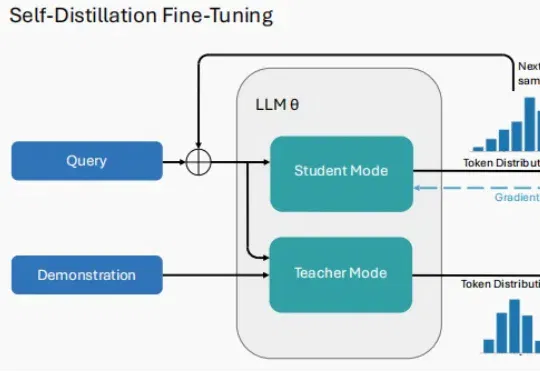
2026 年刚拉开序幕,大模型(LLM)领域的研究者们似乎达成了一种默契。 当你翻开最近 arXiv 上最受关注的几篇论文,会发现一个高频出现的词汇:Self-Distillation。
陈勇超在 x 平台宣布,正式创立 Apex Intelligence(中文名:超衍智能),主攻自主进化基础模型(Self-Improving Model),公司 Slogan 是"Unlock Undiscovered Discovery"(解锁尙被发现的发现),目标是让大模型从复刻人类已有知识,转向自主发现未知规律。
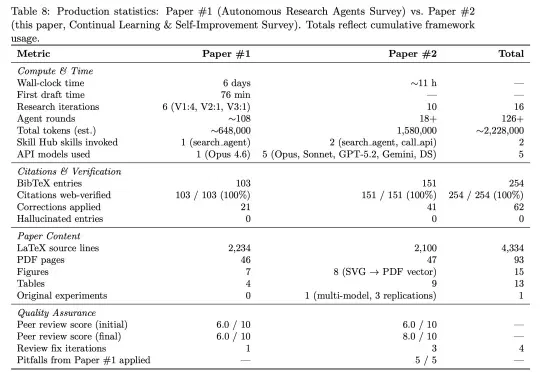
DeepSeek 研究员陈德里(Deli Chen)和 AI 合作的第二篇论文来了!论文地址:https://victorchen96.github.io/continual_learning_survey.pdf这篇论文聚焦 continual learning(持续学习) 与 self-iteration(自我迭代)。在陈德里看来,这是 AI 迈向 AGI 过程中极为关键的一步。
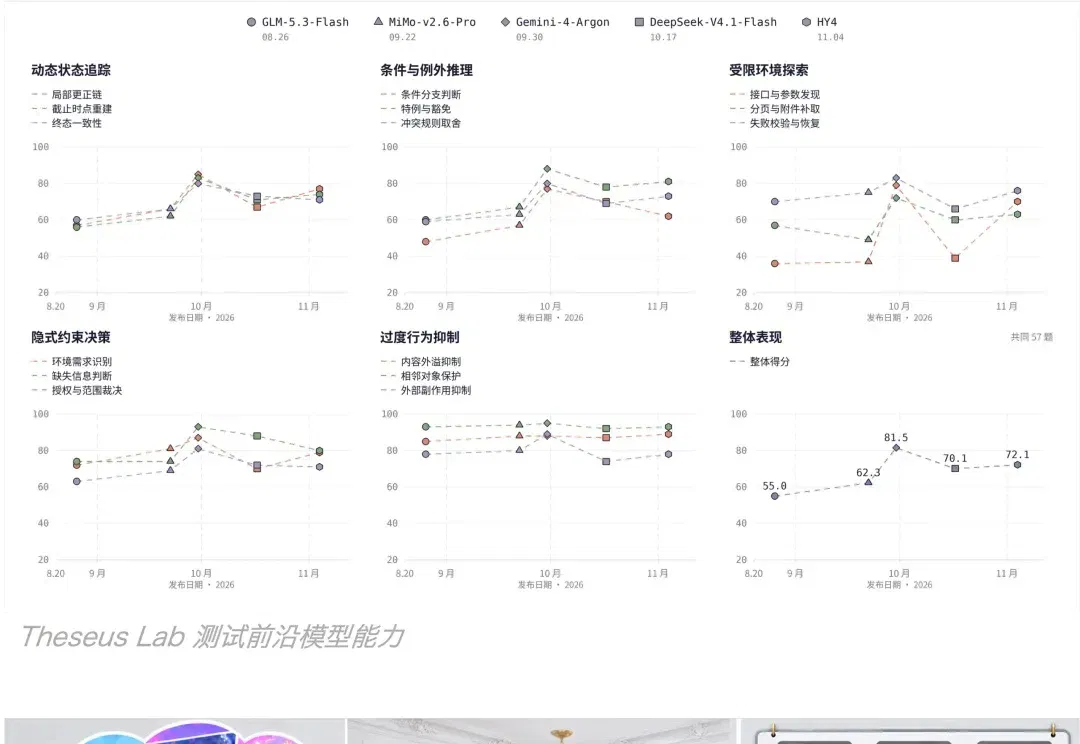
DeliverBench 考察完整项目交付,SelfImprove-Bench 测量改进能否迁移,AmbiHTMLBench 比较模型把视觉文档还原为 HTML 的表现。
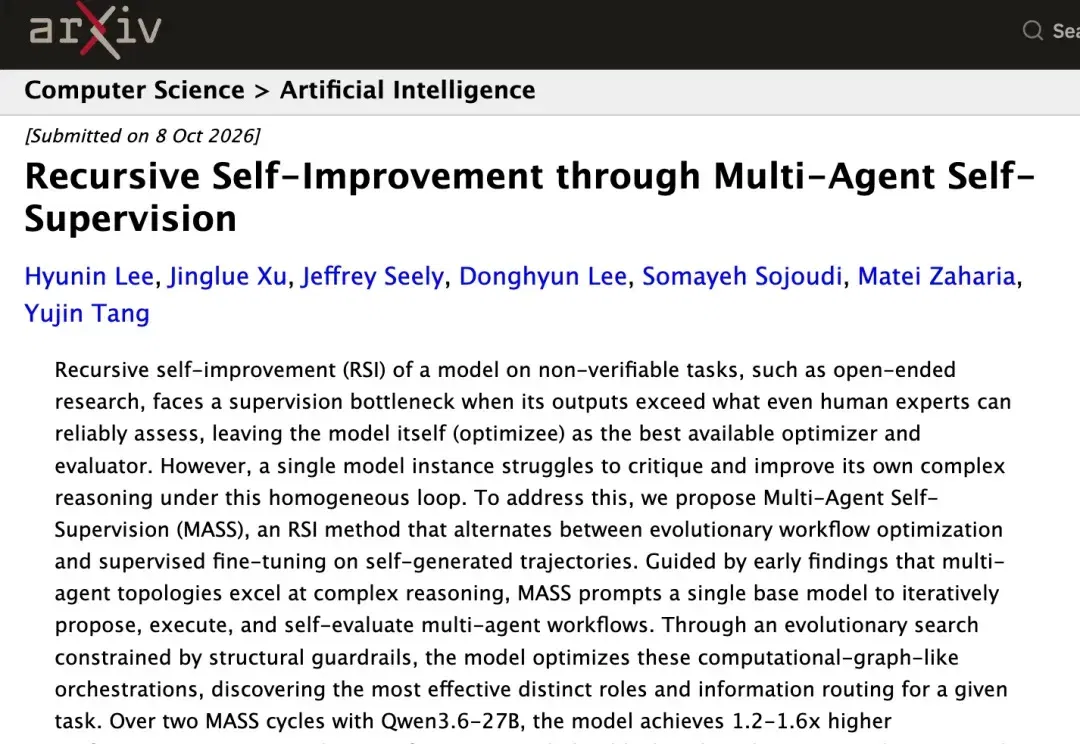
由Transformer奠基论文核心作者Llion Jones创办的 Sakana AI,联手UC Berkeley带来了一项递归自我改进(RSI)新成果:MASS(Multi-Agent Self-Supervision)。