搜索

关于“Disco”的结果

共 35 篇

直播中|Claude垫底,GPT表现不佳,PhAI Labs用DiscoveryRSI探索科研Agent自我进化

直播中|Claude垫底,GPT表现不佳,PhAI Labs用DiscoveryRSI探索科研Agent自我进化(在新窗口打开)

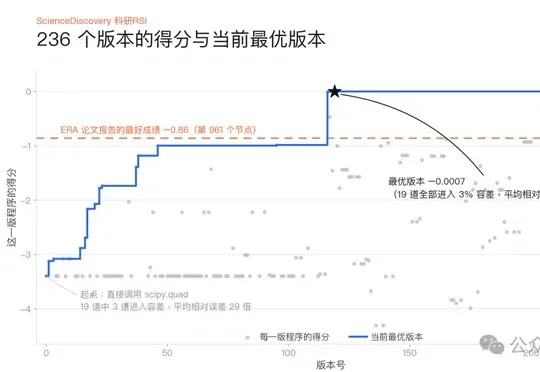
Claude,竟然排在最后? PhAI Labs 最新公布了一项 AI 研究能力对照,结合后续发表的科学文献,考察不同模型提出的研究假设能否为未来的研究思路与探索方向提供启发。报告所列的 Claude Opus 5 组对应比例为 2.3%,排在图中五个模型组的末位。GPT 组为 2.5%,GLM 为 2.8%,DeepSeek 为 5.4%。 排在最前面的,是 DiscoveryRSI:6.3%,约为 GPT 组的 2.5 倍、Claude 组的 2.7 倍。 图 1|五个模型组对未来研究的启发:DiscoveryRSI 总体比例为 6.3%。 这项比较观察的是:AI 提出的研究假设,能否在后
AI技术文章
0
斯坦福英伟达推出测试时强化学习:微调开源模型胜过顶级闭源模型,仅需几百美元

斯坦福英伟达推出测试时强化学习:微调开源模型胜过顶级闭源模型,仅需几百美元(在新窗口打开)

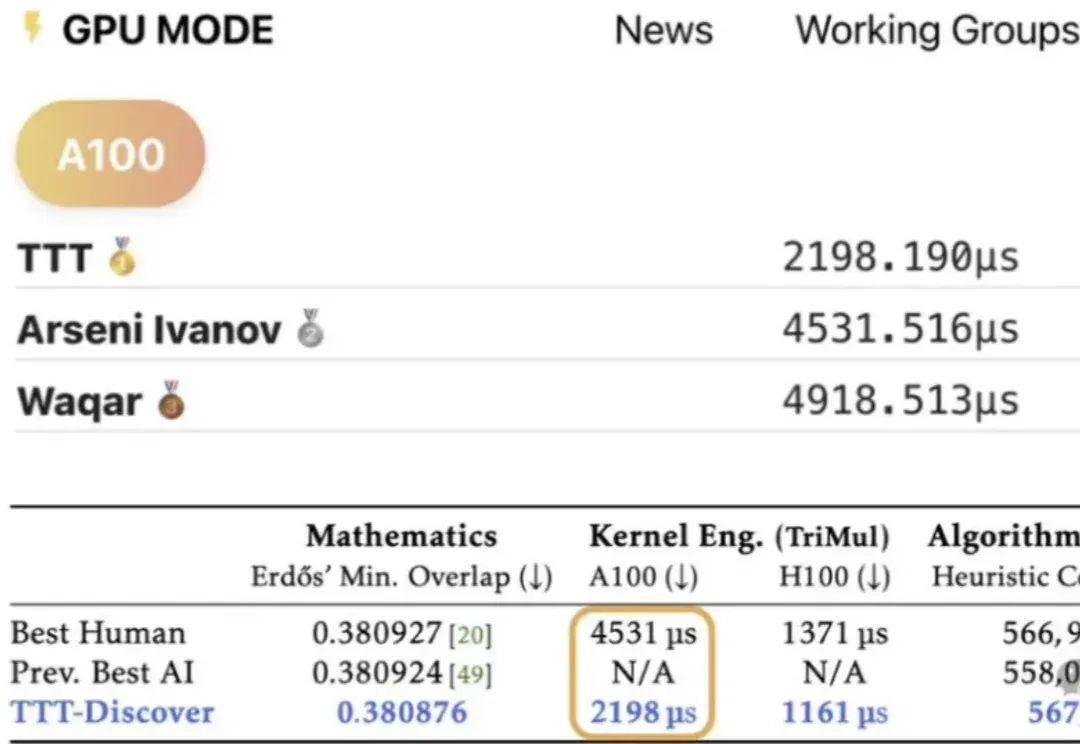
大模型持续学习,又有新进展! 来自斯坦福、英伟达等研究机构的最新研究,针对解决开放的科学问题,提出全新思路—— Test-Time Training to Discover (TTT-Discover)。 其基于开源模型gpt-oss-120b,在多个领域达到SOTA,优于人类专家与闭源前沿模型。 该方法不再沿用“测试时缩放”(Test-time Scaling)只通过Prompt调度冻结模型的做法。 而是在测试阶段,针对单个具体问题,引入强化学习(RL)对模型权重进行更新。 这种“测试时训练”使模型能够从该问题的失败尝试中实时获取经验,更新参数,实现模型能力的定向进化。 数学:给出了Erdő

AI技术文章
0