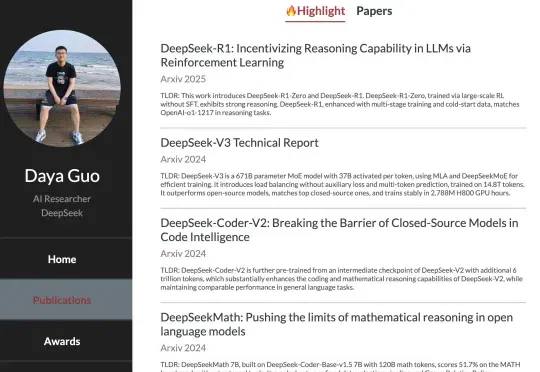
DeepSeek核心研究员郭达雅,曝入职字节(在新窗口打开)
刚刚,图灵联合创始人刘江在海外社交媒体X上透露,DeepSeek核心研究院——郭达雅已加入字节跳动。 郭达雅2023年博士毕业后加入DeepSeek,title是AI Researcher。公开论文显示,从 DeepSeek-Coder、DeepSeek-Math、DeepSeek-Prover、DeepSeek-V3到 DeepSeek-R1,他都出现在核心作者名单中。
共 36 篇
刚刚,图灵联合创始人刘江在海外社交媒体X上透露,DeepSeek核心研究院——郭达雅已加入字节跳动。 郭达雅2023年博士毕业后加入DeepSeek,title是AI Researcher。公开论文显示,从 DeepSeek-Coder、DeepSeek-Math、DeepSeek-Prover、DeepSeek-V3到 DeepSeek-R1,他都出现在核心作者名单中。
2025 年 1 月 20 日,DeepSeek(深度求索)正式发布了 DeepSeek-R1 模型,并由此开启了新的开源 LLM 时代。在 Hugging Face 刚刚发布的《「DeepSeek 时刻」一周年记》博客中,DeepSeek-R1 也是该平台上获赞最多的模型。
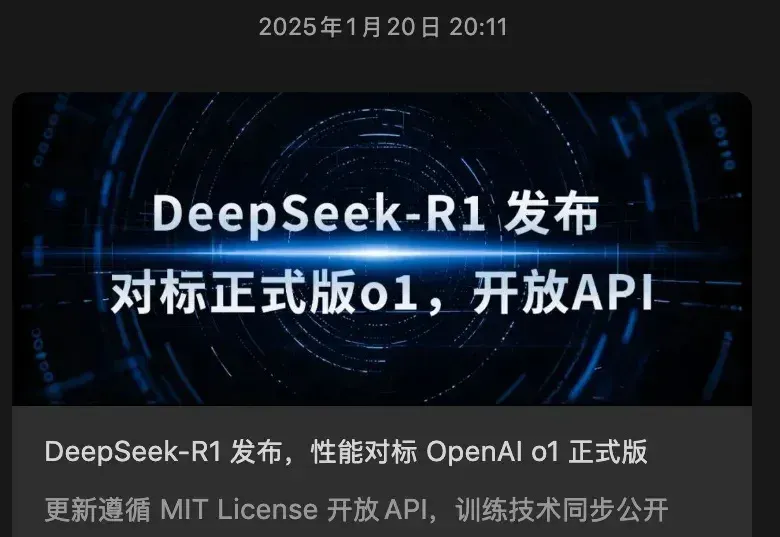
「服务器繁忙,请稍后再试。」 一年前,我也是被这句话硬控的用户之一。 DeepSeek 带着 R1 在一年前的今天(2025.1.20)横空出世,一出场就吸引了全球的目光。 那时候为了能顺畅用上 DeepSeek,我翻遍了自部署教程,也下载过不少号称「XX - DeepSeek 满血版」的各类应用。 一年后,说实话,我打开 DeepSeek 的频率少了很多。 豆包能搜索、能生图,千问接入了淘宝和高德,元宝有实时语音对话和微信公众号的内容生态;更不用说海外的 ChatGPT、Gemini 等 SOTA 模型产品。 当这些全能 AI 助手把功能列表越拉越长时,我也很现实地问自己:「有更方便的,为什
两天前,DeepSeek悄无声息地把R1的论文更新了,从原来22页「膨胀」到86页。DeepSeek向世界证明:开源不仅能追平闭源,还能教闭源做事!
大模型推理的爆发,实际源于 scaling 范式的转变:从 train-time scaling 到 test-time scaling(TTS),即将更多的算力消耗部署在 inference 阶段。典型的实现是以 DeepSeek r1 为代表的 long CoT 方法:通过增加思维链的长度来获得答案精度的提升。那么 long CoT 是 TTS 的唯一实现吗?
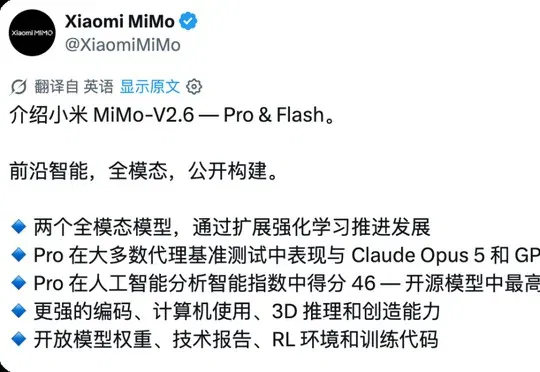
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
过去两年,大模型的推理能力出现了一次明显的跃迁。在数学、逻辑、多步规划等复杂任务上,推理模型如 OpenAI 的 o 系列、DeepSeek-R1、QwQ-32B,开始稳定拉开与传统指令微调模型的差距。直观来看,它们似乎只是思考得更久了:更长的 Chain-of-Thought、更高的 test-time compute,成为最常被引用的解释。
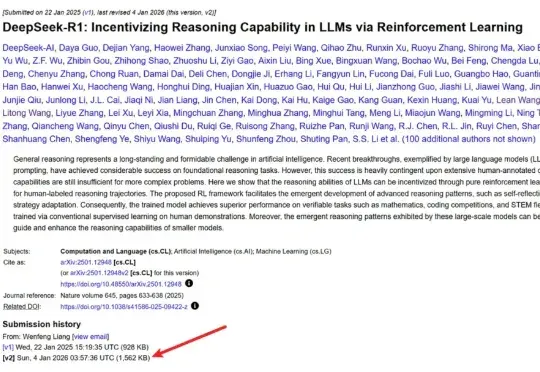
几天前,DeepSeek 毫无预兆地更新了 R1 论文,将原有的 22 页增加到了现在的 86 页。新版本充实了更多细节内容,包括首次公开训练全路径,即从冷启动、训练导向 RL、拒绝采样与再微调到全场景对齐 RL 的四阶段 pipeline,以及「Aha Moment」的数据化验证等等。
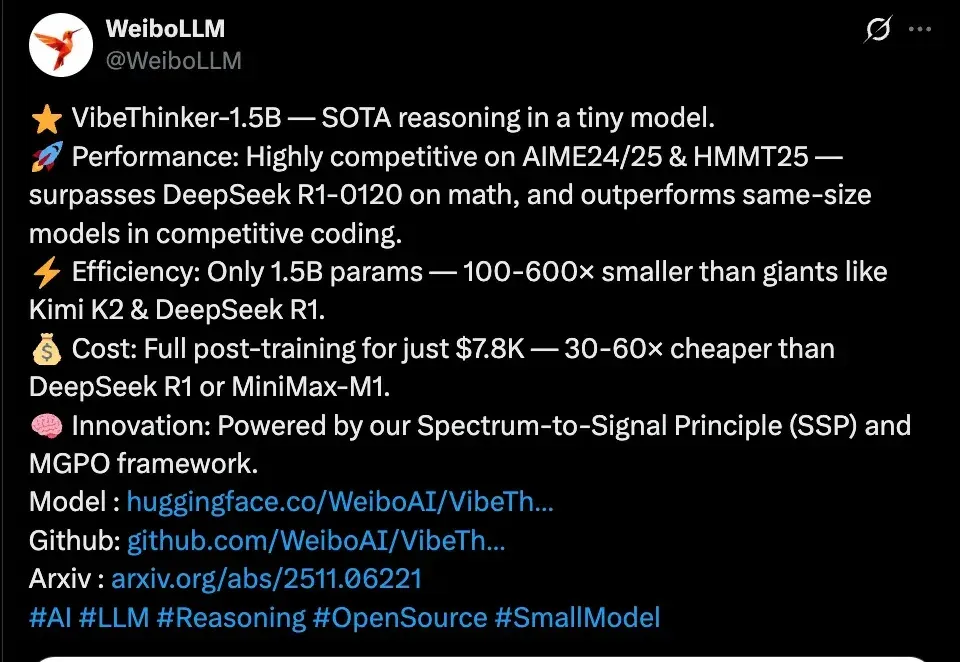
近日,微博正式发布首个自研开源大模型VibeThinker,这个仅拥有15亿参数的“轻量级选手”,在国际顶级数学竞赛基准测试上击败了参数量是其数百倍的、高达6710亿的DeepSeek R1模型。
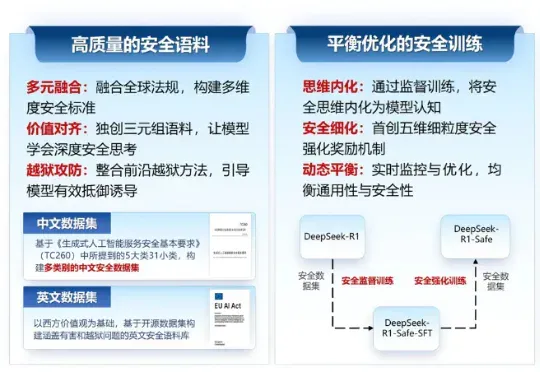
2025年9月18日,由浙江大学计算机科学与技术学院院长、区块链与数据安全全国重点实验室常务副主任任奎教授团队联合华为技术有限公司计算产品线共同研发的国内首个基于昇腾千卡算力平台的DeepSeek-R1-Safe基础大模型在“华为全联接大会2025”正式发布。