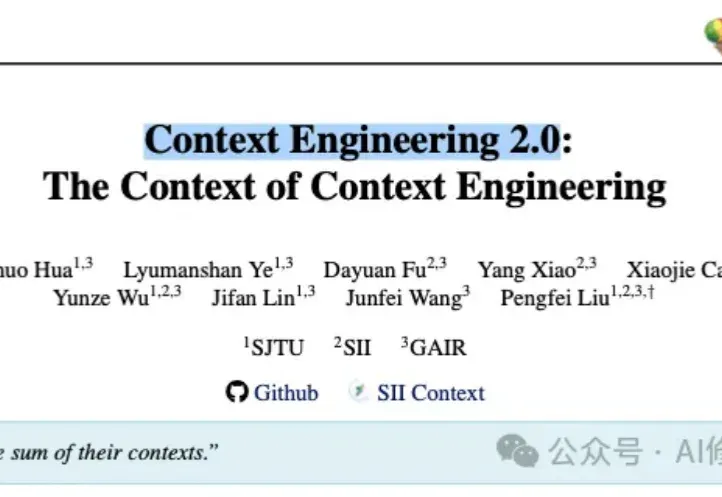
Context Engineering 2.0:在未来,一个人的本质,就是其所有上下文的总和|上海交大(在新窗口打开)
在几天前,上海交大发布了一篇名为 《上下文工程2.0:上下文工程的上下文》(Context Engineering 2.0: The Context of Context Engineering) 的重磅论文。
共 62 篇
在几天前,上海交大发布了一篇名为 《上下文工程2.0:上下文工程的上下文》(Context Engineering 2.0: The Context of Context Engineering) 的重磅论文。
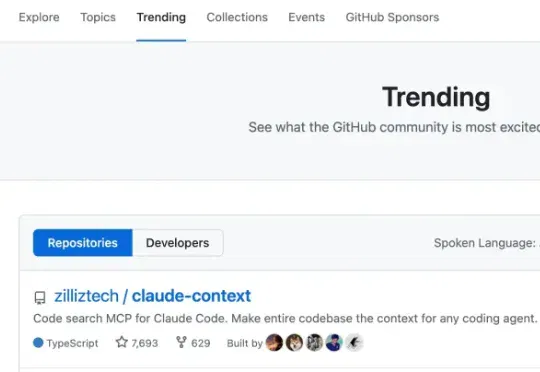
欢迎大家尝试前不久GitHub的日榜榜首项目——Claude Context。通过在AI coding场景引入混合检索,Claude Context相比使用grep的原生 Claude Code 能大幅提升检索精度和效率,减少约 40% 的 不必要Token 消耗。
本篇文章根据我在本月 43 Talks 线下活动中的分享整理而成。主理人李继刚邀请我时,给的主题词只有一个:Context。我想从 Agent 的视角出发,讨论一个判断:随着模型和 Harness 逐步趋同,真正决定 Agent 能力边界的,会越来越是 Context。
阿里AI办公领域,再落一子。 智东西8月17日报道,近日,千问办公开源了个人工作上下文基础设施MyContext,项目上线一周多,在GitHub上已收获超1k星,这也是千问办公的首个开源项目。 MyContext做的不是传统意义上的知识库,而是把飞书、钉钉里的聊天、文档、会议记录等工作痕迹收拢起来,持续整理成一份个人工作档案,让Agent逐渐知道你是谁、在做什么,以及平时怎么处理事情。 如果找一个熟悉的参照物,它有点像给Agent装上本地个人知识库Obsidian:同样强调本地优先、知识组织和数据主权,不同的是,Obsidian里的内容主要靠用户自己写,MyContext则试图从日常工作记录里
模型不更新,能力却持续增长。 这是Zeva最反直觉的地方,也是清华AIR与域变换联手给出的新答案。 在多个典型具身基准任务上,将冻结模型的累计成功率从26%提升到73%;在真实化学实验室,机械臂在多次尝试中越用越稳。 更关键的是,一次人类演示就能让模型“学会”一个新操作。 Zeva是首个实现In-Context Causal Learning(ICCL)的具身WAM。 它让模型可以在不更新权重的情况下,从自己的交互经验中持续学习。当这种能力逐步成熟,具身智能将迎来属于自己的“GPT时刻”。 项目信息 项目名称:Zeva 发布机构:清华AIR、域变换 论文题目:Zeva: In-Context
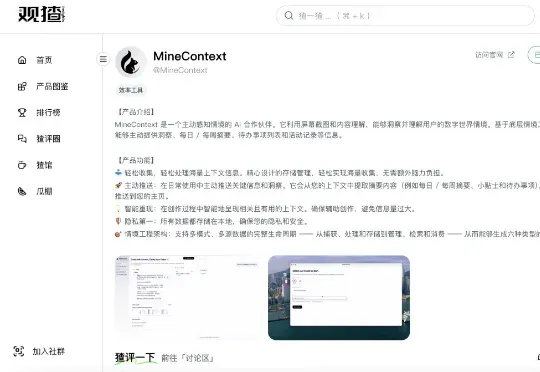
最近在开源社区闲逛,发现字节悄悄放出了一个叫 MineContext 的项目。和字节Viking团队的小伙伴聊天时,我了解到一个挺有意思的故事:MineContext 团队其实在今年四五月份就有了初步想法,甚至更早之前就在思考:如何围绕个人的完整记忆来做应用。
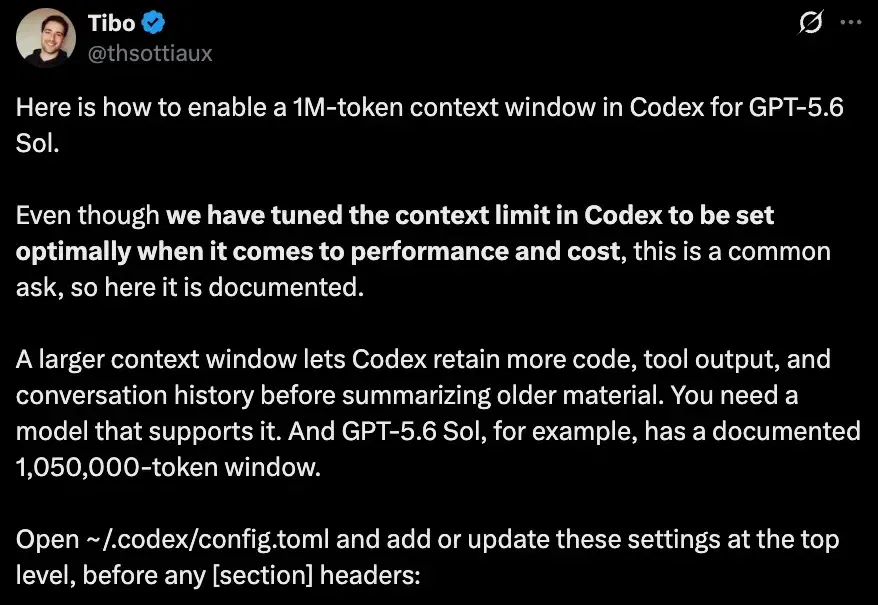
赛博义父Tibo,真·有求必应! 现在,3行配置就能让GPT-5.6 Sol封印解除,在Codex里用上1M上下文了。 model = “gpt-5.6-sol” model_context_window = 1000000 model_auto_compact_token_limit = 900000 非常简单,在Codex的config.toml文件开头输入以上咒语,重启客户端、开启新会话就OK。一直到约90万token时,GPT-5.6 Sol才会开始自动压缩历史内容。 本来是API专属的功能,现在就这么水灵灵地开放给ChatGPT和Codex账号了。 Tibo推文一发,又双叒大爆特爆,
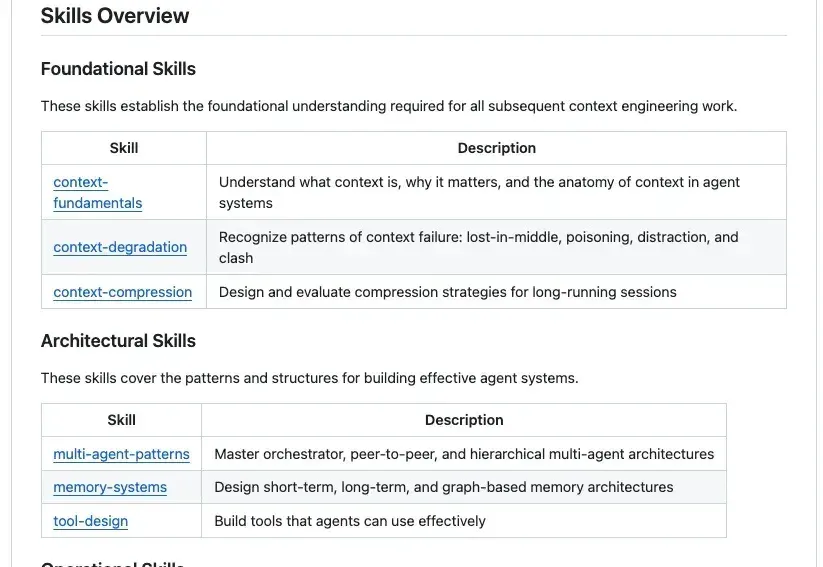
GitHub上最近出现了一个非常火的项目Agent-Skills-for-Context-Engineering,发布不到一周就斩获了2.3k Stars。为什么它能瞬间引爆社区?因为站在2025年末的节点上,我们已经受够了那些只存在于大厂白皮书里的Context Engineering(上下文工程) 理论。
AirJelly 发布了内测版本。 这是一款桌面端 AI 助手——通过屏幕截图捕捉你的工作上下文,理解你的意图,并主动帮你执行任务。 开发团队叫「持续低熵」(Low Entropy AI),创始人柏特是一名 00 后。去年他在字节主导了一款名为 MineContext 的上下文工程产品,随后便离职创业,很快拿到了来自五源资本的第一笔融资。 「MineContext 是 AirJelly 的脚手架。」 AirJelly 的核心理念是:不追求全量记录用户行为,而是以 Enter 键为锚点,捕捉用户每一次表达意图的瞬间。基于这些意图,AI 将行为建模为任务,主动推送下一步建议,甚至直接帮你完成。 「
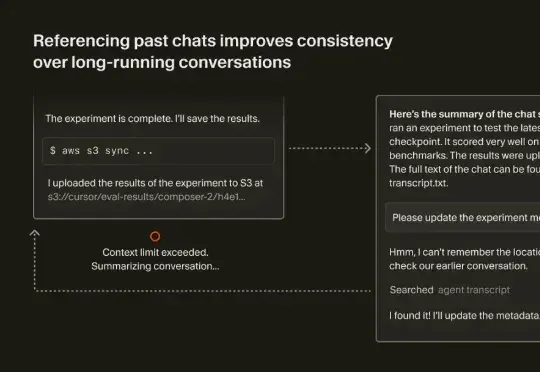
最近,Cursor 也发表了一篇文章《Dynamic context discovery》,分享了他们是怎么做上下文管理的。结合 Manus、Cursor 这两家 Agent 领域头部团队的思路,我们整理了如何做好上下文工程的一些关键要点。