全新合成框架SOTA:强化学习当引擎,任务合成当燃料,蚂蚁港大联合出品(在新窗口打开)
蚂蚁通用人工智能中心自然语言组联合香港大学自然语言组(后简称“团队”)推出PromptCoT 2.0,要在大模型下半场押注任务合成。实验表明,通过“强起点、强反馈”的自博弈式训练,PromptCoT 2.0可以让30B-A3B模型在一系列数学代码推理任务上实现新的SOTA结果,达到和DeepSeek-R1-0528, OpenAI o3, Gemini 2.5 Pro等相当的表现。
共 33 篇
蚂蚁通用人工智能中心自然语言组联合香港大学自然语言组(后简称“团队”)推出PromptCoT 2.0,要在大模型下半场押注任务合成。实验表明,通过“强起点、强反馈”的自博弈式训练,PromptCoT 2.0可以让30B-A3B模型在一系列数学代码推理任务上实现新的SOTA结果,达到和DeepSeek-R1-0528, OpenAI o3, Gemini 2.5 Pro等相当的表现。
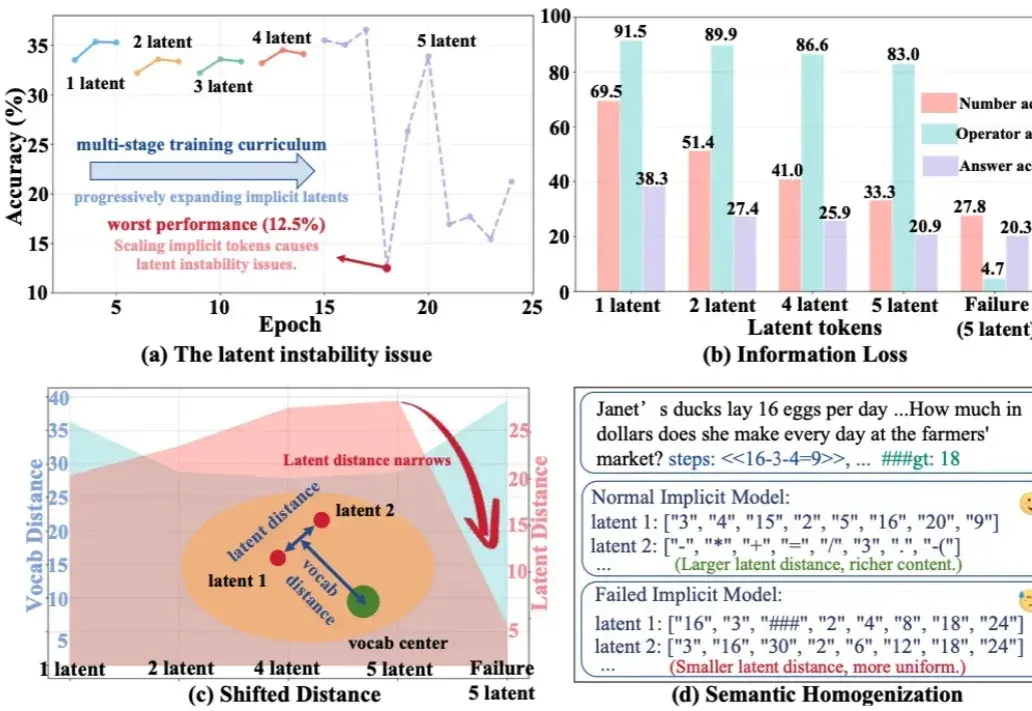
今天推荐一个 Implicit Chain-of-Thought(隐式推理) 的最新进展 —— SIM-CoT(Supervised Implicit Chain-of-Thought)。它直击隐式 CoT 一直「扶不起来」的核心痛点:隐式 token 一旦 scale 上去,训练就容易塌缩到同质化的 latent 状态,推理语义直接丢失。
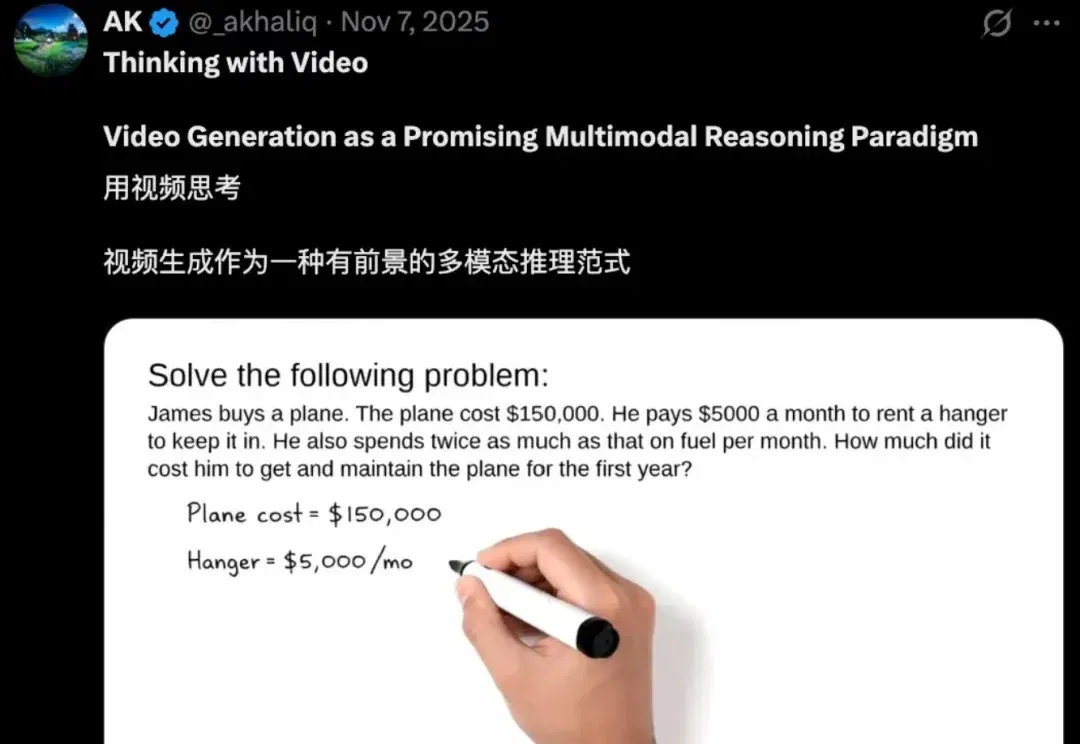
被CVPR 2026收录! 复旦邱锡鹏团队(OpenMOSS)首次提出Thinking with Video这一推理新范式: 借助视频生成模型,以视频帧为统一媒介进行多模态推理,打破视觉与文本的界限。 团队发现,Thinking with Text(基于文本的CoT推理)和Thinking with Images(在CoT中加上图像辅助推理)范式已大幅提升了LLMs和VLMs的推理能力。 但它们仍有局限:静态图像无法展现动态过程,文本与视觉模态的割裂阻碍了统一理解与生成。 而借助新范式Thinking with Video,视频生成模型在视觉任务上不仅总体媲美SOTA VLMs,而且竟也能解决
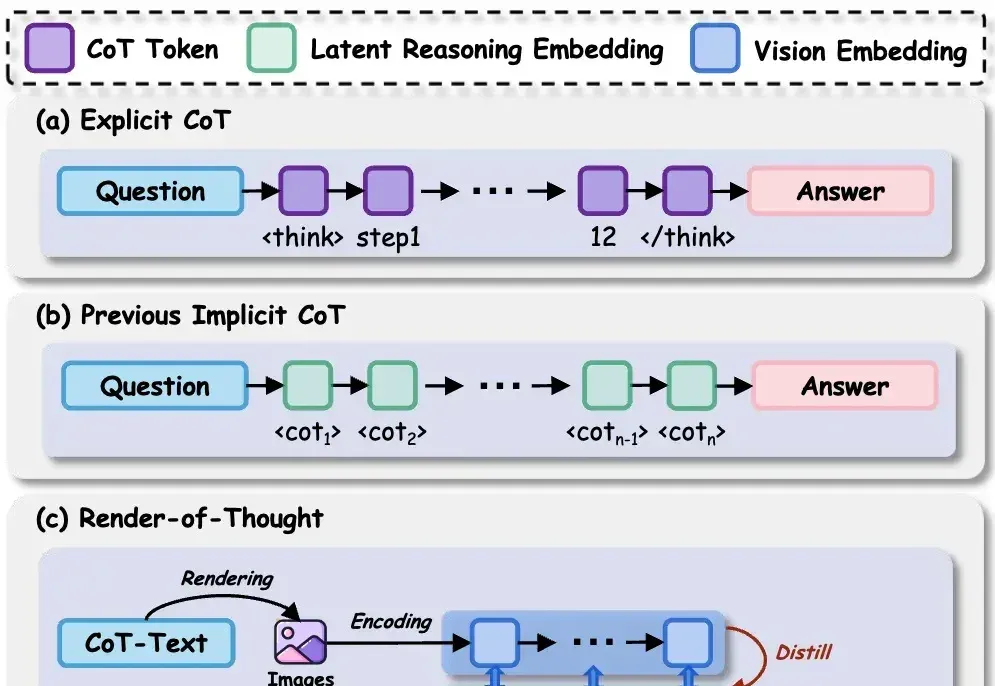
在 LLM 时代,思维链( CoT)已成为解锁模型复杂推理能力的关键钥匙。然而,CoT 的冗长问题一直困扰着研究者——中间推理步骤和解码操作带来了巨大的计算开销和显存占用,严重制约了模型的推理效率。
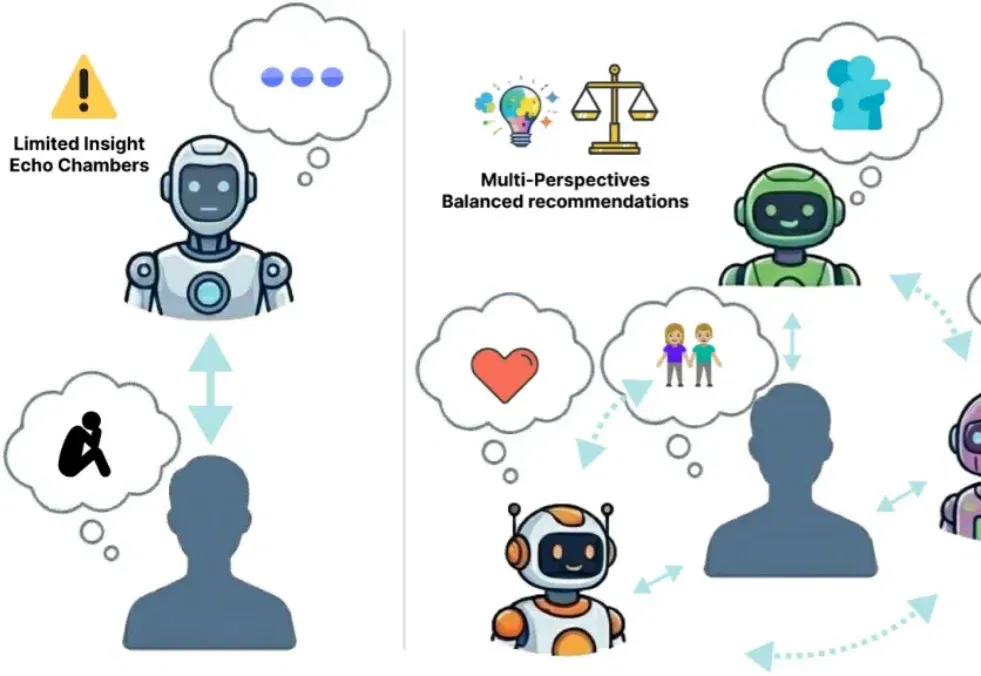
MASCOT 将多智能体群聊拆成角色行为对齐与主持人协调两个训练阶段,减少多个角色反复附和、缺少新贡献的问题。研究在情感支持与会议讨论数据上结合模型评分和人工盲评验证效果,现有证据主要来自英语和受控情境,长期互动仍待检验。
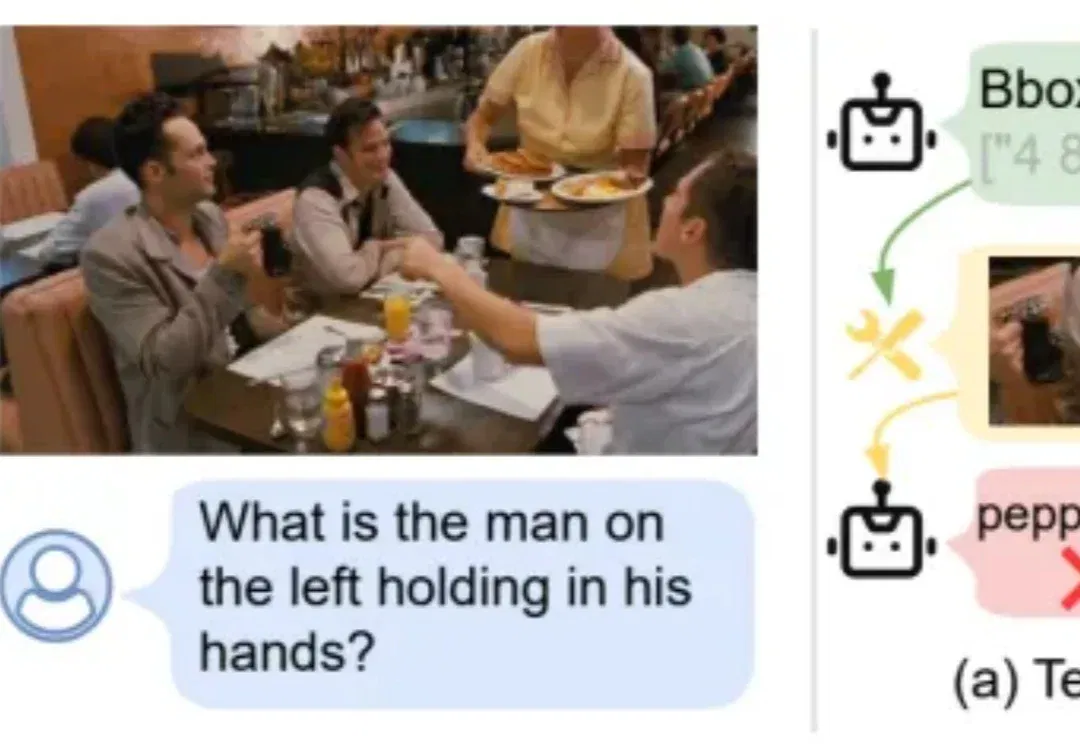
视觉模型即使理解了问题,也可能因图像裁切位置不准而错过细节。NV-CoT 用连续坐标替代离散位置选择,结合监督微调与强化学习改善区域定位;多项高分辨率测试展示了收益,但更精确的坐标仍无法替代正确的语义理解。
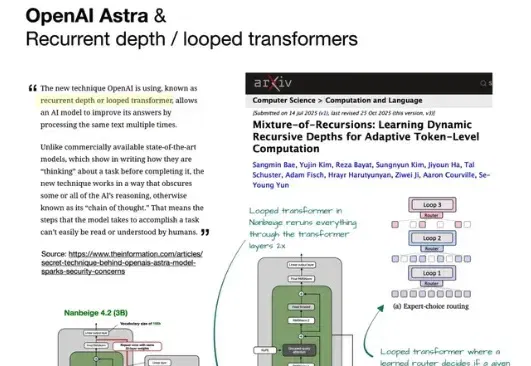
OpenAI这次真狠,GPT-6用起来有一种2023年GPT-4的感觉。
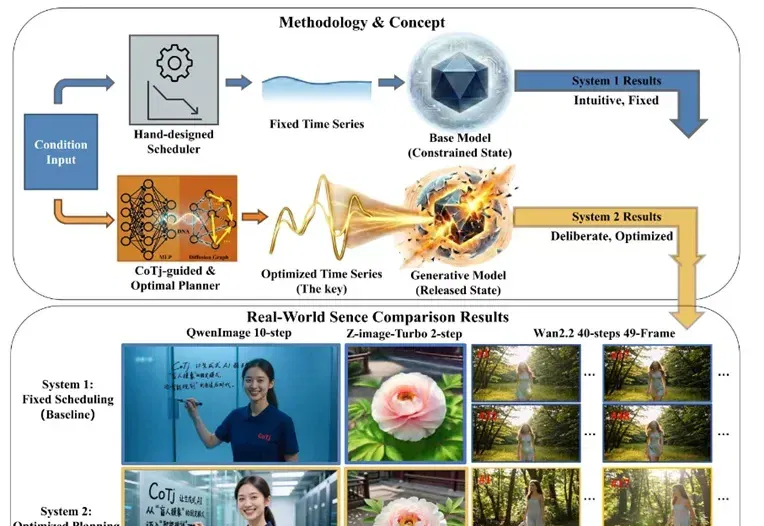
扩散模型终于学会“看题下菜碟”了! 一直以来,文生图模型都是“凭直觉”作画——不管提示词是“黑色的天空”还是“梵高风格的漩涡星空”,都死板地用同一套固定步数采样。 结果就是:简单题算力过剩,复杂题细节崩坏。 中国联通数据科学与人工智能研究院联合高校提出的新框架“轨迹链”(CoTj),彻底打破了这一僵局。它让扩散模型拥有了“系统2”的规划能力,能根据提示词的复杂程度,动态分配计算资源。 更颠覆的是,在5步的极端压缩下,CoTj规划出的轨迹配上最朴素的1阶求解器,画质居然吊打了传统方法配高阶求解器——证明“找对路”比“用什么交通工具”更重要。 目前,该研究的论文已在arXiv发布,推理代码也已开源
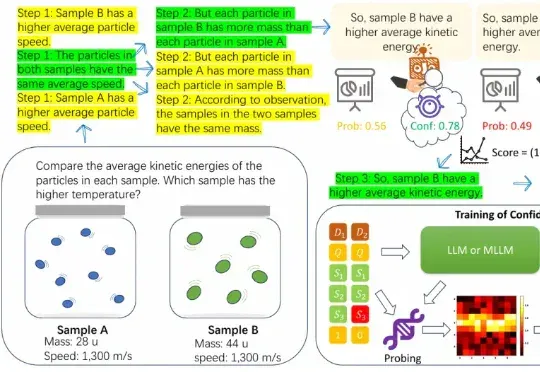
近年来,大语言模型在算术、逻辑、多模态理解等任务上之所以取得显著进展,很大程度上依赖于思维链(CoT)技术。所谓 CoT,就是让模型在给出最终答案前,先生成一系列类似「解题步骤」的中间推理。 这种方式
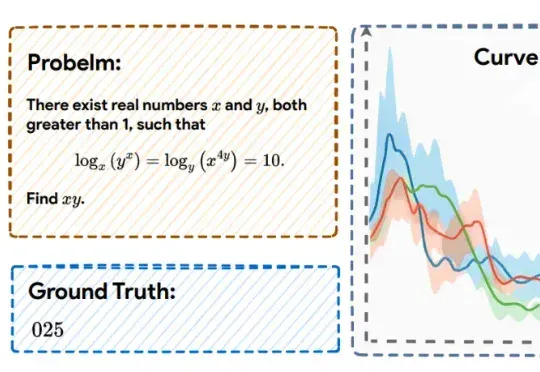
近日,上海人工智能实验室的研究团队提出了一种全新的后训练范式——RePro(Rectifying Process-level Reward)。这篇论文将推理的过程视为模型内部状态的优化过程,从而对如何重塑大模型的CoT提供了一个全新视角: