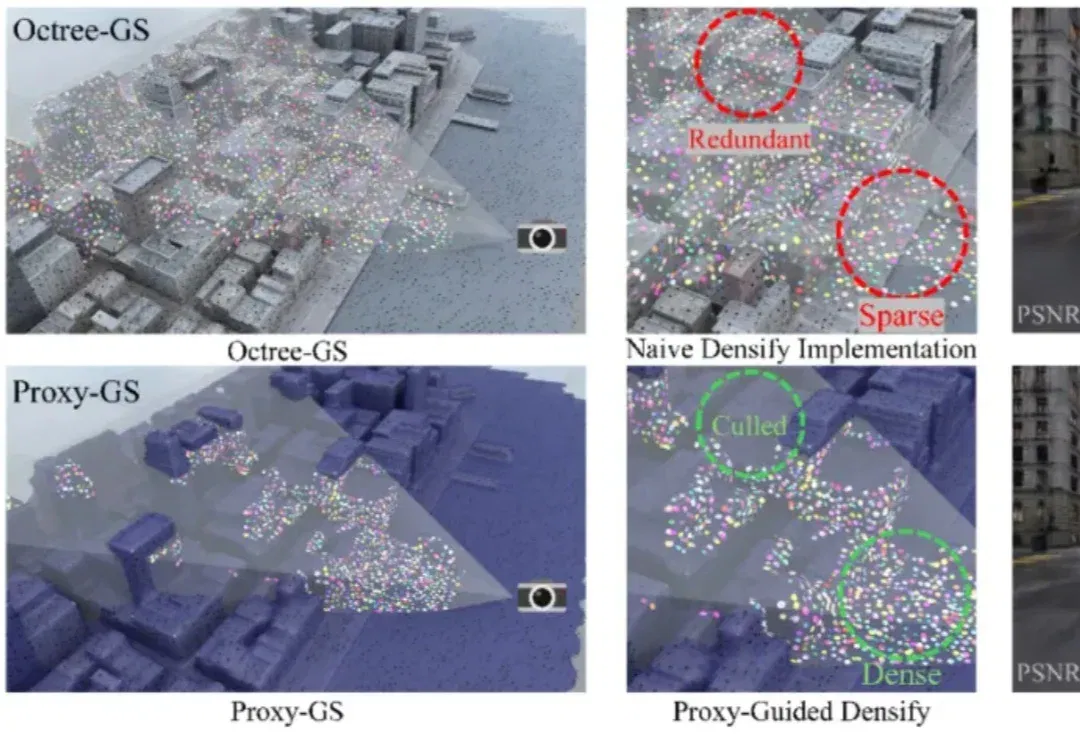
CVPR2026满分论文:Proxy-GS为结构化3D高斯溅射引入统一遮挡先验(在新窗口打开)
上海交通大学钟志航团队联合上海人工智能实验室、西北工业大学、四川大学等高校在 CVPR 2026 上提出Proxy-GS(Proxy-GS: Unified Occlusion Priors for Training and Inference in Structured 3D Gaussian Splatting),面向基于 MLP 的结构化 3D 高斯溅射(3DGS),
共 62 篇
上海交通大学钟志航团队联合上海人工智能实验室、西北工业大学、四川大学等高校在 CVPR 2026 上提出Proxy-GS(Proxy-GS: Unified Occlusion Priors for Training and Inference in Structured 3D Gaussian Splatting),面向基于 MLP 的结构化 3D 高斯溅射(3DGS),
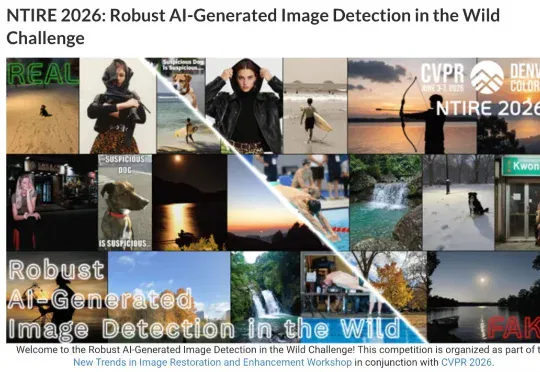
最近,计算机视觉领域的顶级会议 CVPR 2026 的 NTIRE 鲁棒性 AIGC 图像检测挑战赛( Robust AI-Generated Image Detection in the Wild Challenge )结果出炉。蚂蚁集团 AI 安全实验室的队伍 MICV 凭借在鲁棒性测试样本上 ROC AUC 达到了惊人的 0.9723,成功摘得「复杂真实场景鲁棒性样本测试」挑战赛的冠军。
CVPR 2026 汇总16034份投稿算力表,录取与拒稿组的GPU数量中位数分别为4张和2张,研发计算投入也有差异。统计反映相关性,算力数据不向审稿人提供;报告同时展示低算力创新与效率奖励,不能据此推导录取所需的最低卡数。
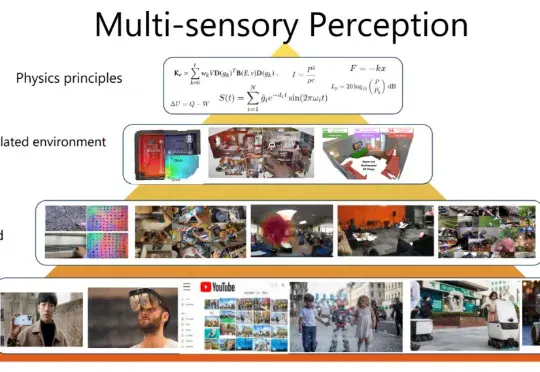
以往的空间音频模型,要么受限于实验室的苛刻采集条件,要么被高昂的人工标注成本卡住脖子。而团队的核心洞察是:相机的自运动本身就是一种免费的监督信号。当相机转动时,声源在声场中的相对位置随之改变——这种变化无需人工标注,模型即可从中学习空间对应关系。这项工作入选CVPR 2025 Highlight,投稿论文前2%。
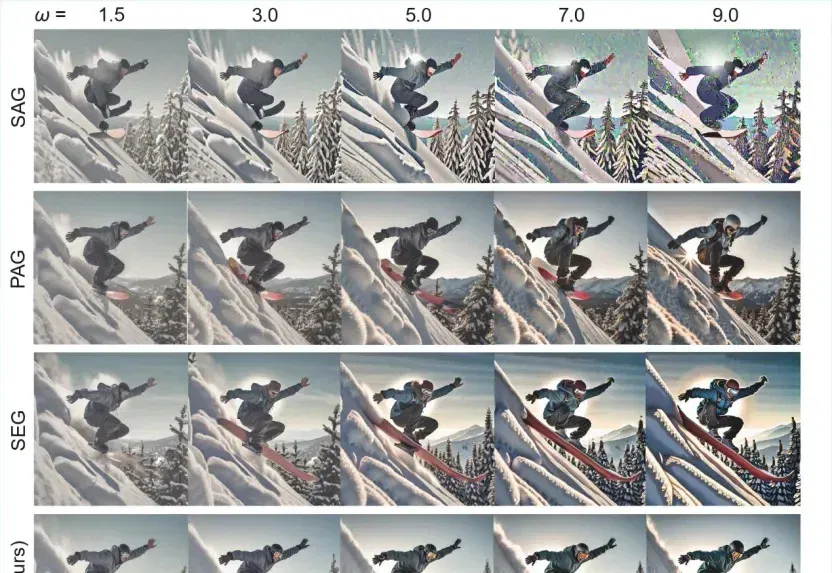
扩散模型又被玩出新花样了。 一直以来,提高扩散模型生成质量的关键手段,是在推理阶段加入引导(guidance)。 要么依赖文本条件(如CFG)——需要专门的训练策略,没有文本条件就不能用; 要么靠显式加噪破坏模型推理——然而效果有限。 现在,一种全新的思路来了: 不需要文本条件,不加噪声,不改模型,只在内部交换token。 来自上海交大和vivo的研究者提出了一种十分简单但非常有效的方法:自交换引导(Self-Swap Guidance,SSG)。该工作已被CVPR 2026国际会议接收为Oral。 一句话总结: 通过在空间和通道维度上交换token特征,把模型“搞差”,再用这个“变差”的路径
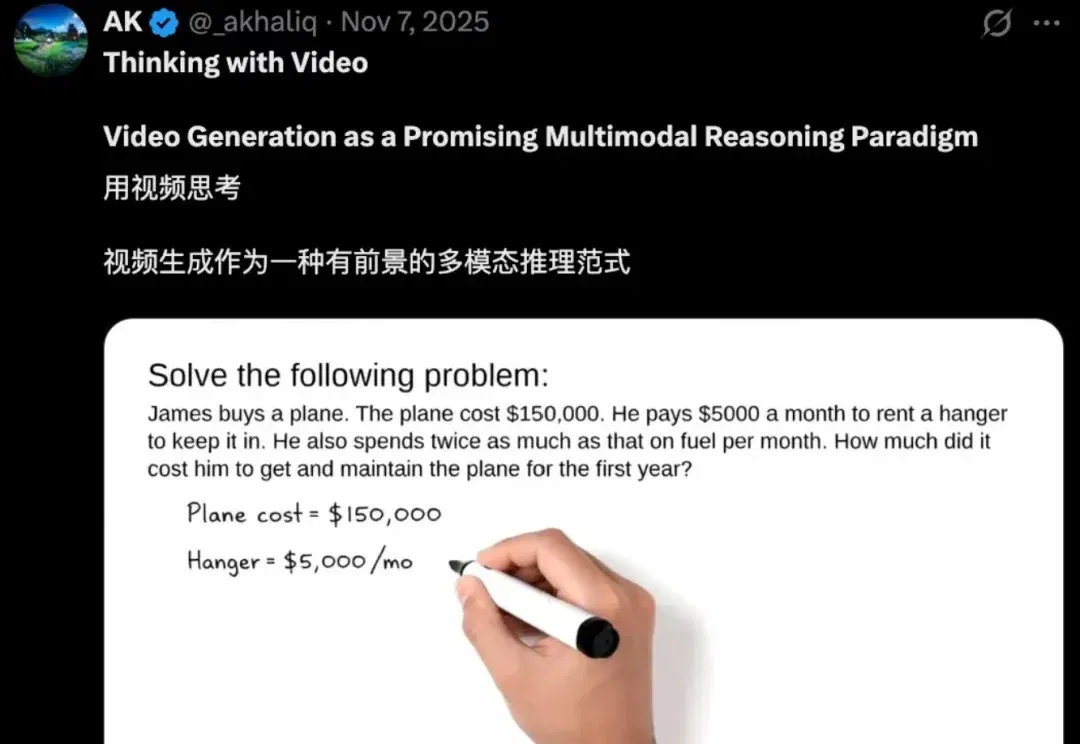
被CVPR 2026收录! 复旦邱锡鹏团队(OpenMOSS)首次提出Thinking with Video这一推理新范式: 借助视频生成模型,以视频帧为统一媒介进行多模态推理,打破视觉与文本的界限。 团队发现,Thinking with Text(基于文本的CoT推理)和Thinking with Images(在CoT中加上图像辅助推理)范式已大幅提升了LLMs和VLMs的推理能力。 但它们仍有局限:静态图像无法展现动态过程,文本与视觉模态的割裂阻碍了统一理解与生成。 而借助新范式Thinking with Video,视频生成模型在视觉任务上不仅总体媲美SOTA VLMs,而且竟也能解决
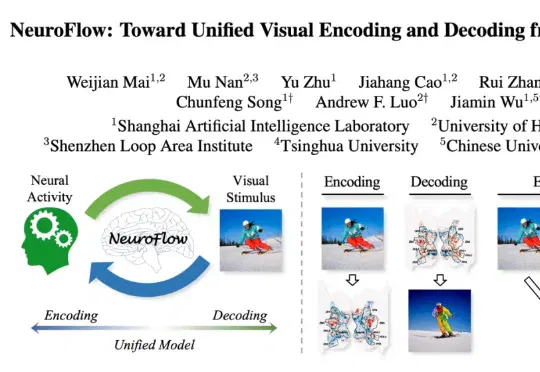
来自上海人工智能实验室、香港大学、香港中文大学等机构的研究团队,提出首个基于统一神经流模型的视觉-神经双向建模框架NeuroFlow,相关成果入选 CVPR 2026。它首次将视觉编码(写脑)与解码(读脑)整合到同一可逆流结构中,打通视觉感知与神经活动之间的双向通路,为理解人类视觉认知机制、构建下一代通用视觉假体与双向脑机接口提供了全新范式。
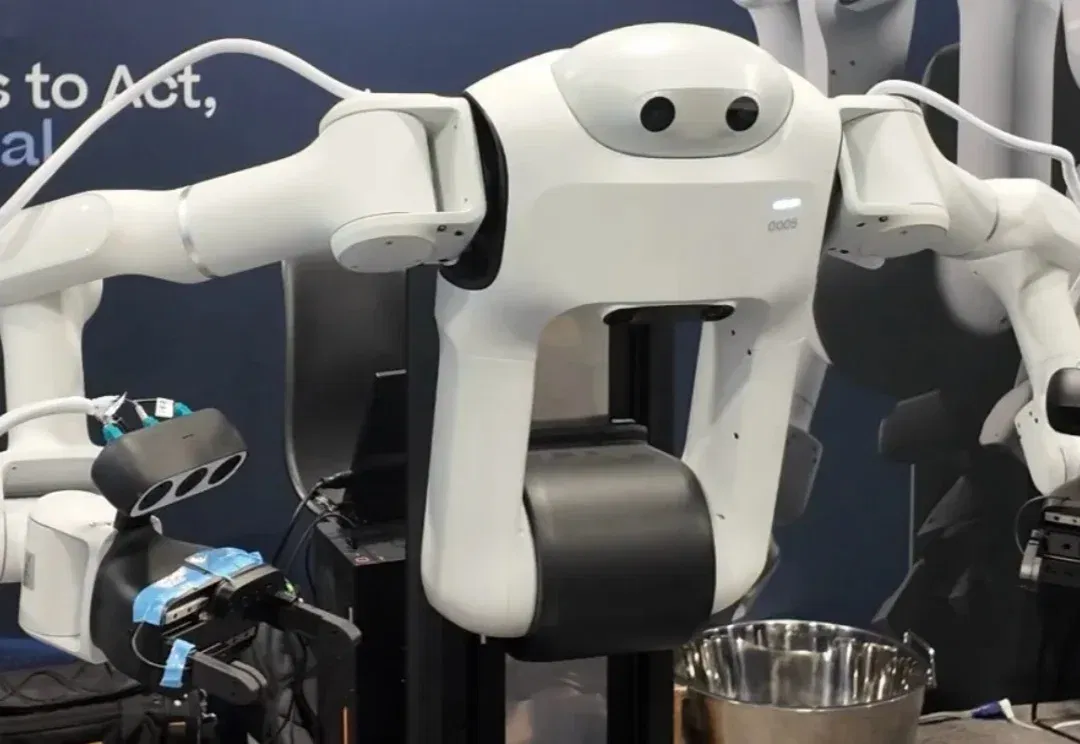
2026 年 6 月的科罗拉多州丹佛市,全球计算机视觉与模式识别领域的顶级学术盛会 CVPR 正在召开,最前沿的视觉模型、机器人技术、下一代智能系统全都在同一个舞台上被反复讨论和辩证。
CVPR 2026全部奖项揭晓!最佳学生论文荣誉提名颁给了ChordEdit,一作和通讯都是广东工业大学本科在读生。他们用一块7年半前的老Titan,跑完了全部实验。
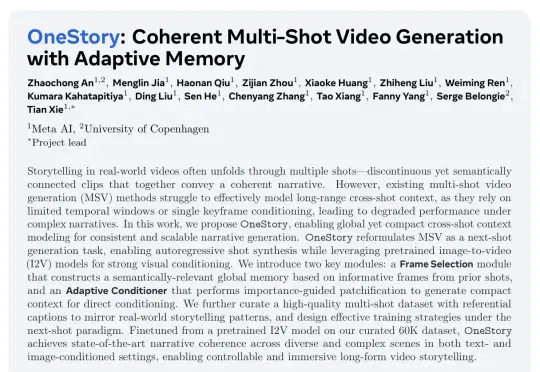
最近,来自Meta与University of Copenhagen的研究者提出了OneStory: Coherent Multi-Shot Video Generation with Adaptive Memory(收录于CVPR 2026)。这项工作聚焦于一个核心问题:如何在生成多镜头视频时,有效保留长程跨镜头上下文,从而实现更强的叙事一致性。