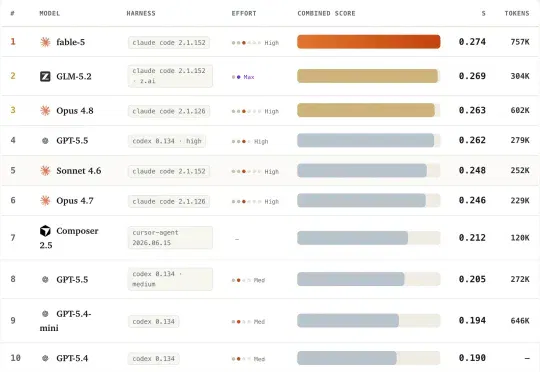
Claude、GLM、GPT谁才是真正的AI软件工程师?首个持续更新Visual Spec-to-App Benchmark发布(在新窗口打开)
为了解决这一问题,来自 University of Arizona、Zoom 与 Stony Brook University 的研究团队推出了 VISTA(VIsual Spec-To-App Benchmark), 首个面向 Visual Spec-to-Web-App Coding Agents 的端到端 Benchmark。
共 63 篇
为了解决这一问题,来自 University of Arizona、Zoom 与 Stony Brook University 的研究团队推出了 VISTA(VIsual Spec-To-App Benchmark), 首个面向 Visual Spec-to-Web-App Coding Agents 的端到端 Benchmark。
我们最近在重新思考一件事:到底什么样的 Benchmark,才值得今天继续做?
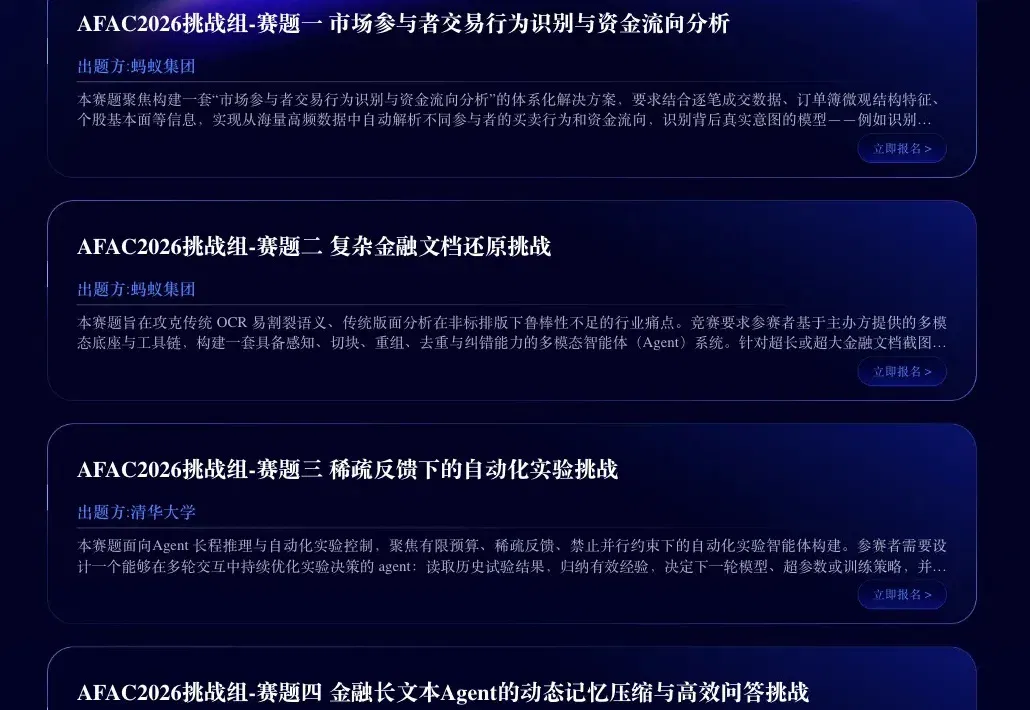
好久没看到这么神清气爽的AI比赛了。 名为AFAC2026金融智能创新大赛,总算不是单纯刷分的「乏味Benchmark」。四道赛题,全部从真实金融场景中生长出来: 看盘面:识别机构交易行为与资金流向;啃文档:将复杂保险PDF还原为结构化Markdown;做实验:在稀疏反馈下完成自动化实验设计;读长文:控制Token成本,对金融长文本精准问答。 是的,专挑金融这个最「地狱级」的训练场。 很多人可能不知道,模型发展到今天,金融垂直任务依然没能被啃下来。 以保险文档还原Markdown为例,一旦碰到大图片、大文档场景,模型在相关Benchmark上的平均分甚至会掉到0.1以下,即便是GPT、Gemi
最近,一家叫 Numeral 的公司刚刚完成了 3500 万美元的 B 轮融资,由 Mayfield 领投,Benchmark、Uncork Capital、Y Combinator 和 Mantis 参与。这轮融资距离他们今年 3 月完成的 1800 万美元 A 轮仅仅过去了 6 个月,公司估值已经达到 3.5 亿美元。
这世上有太多 AI benchmark 了,但没有一个 benchmark 能让你心跳加速。 直到近日,AlphaArena 出现了。 这是由初创团队 NOF1 推出的一个「AI 炒币实盘竞技场」,现在已开放全网围观:竞技场地址:https://nof1.ai/
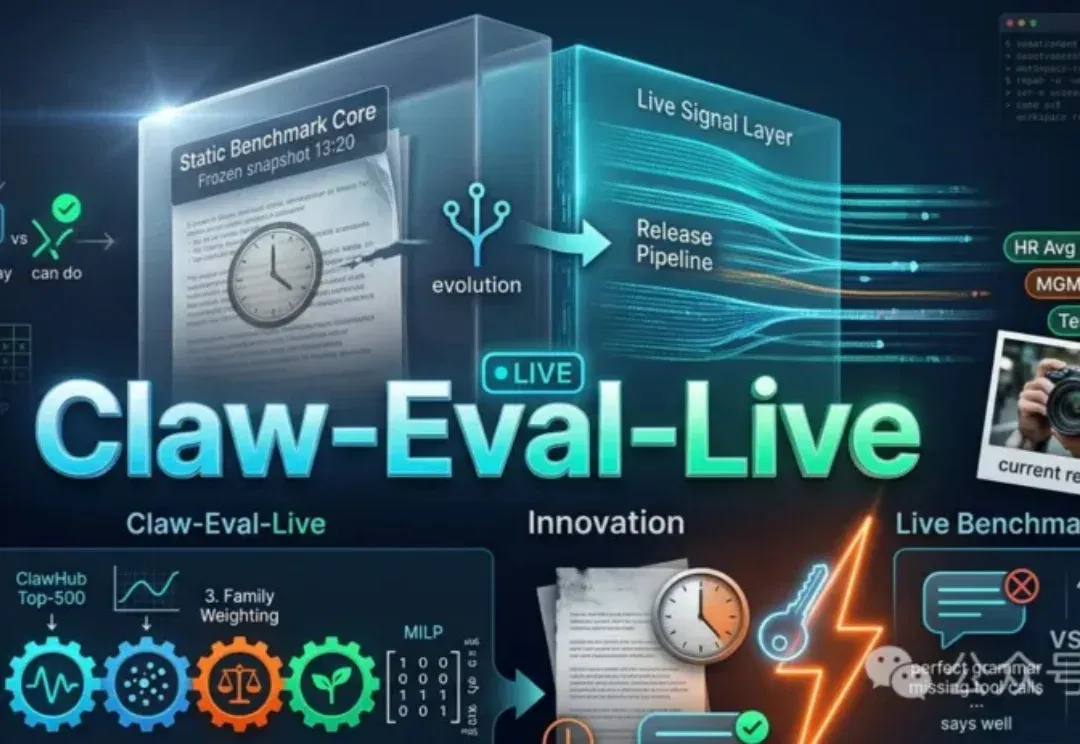
Claw-Eval-Live提出「活的」benchmark概念,通过信号采集与任务筛选,确保评测内容紧跟企业实际痛点,而非固定不变的题库。评测不仅关注结果,还追踪执行过程,从数据调用到状态变更,全面验证Agent的真实能力。
Gumloop 刚刚宣布完成 5000 万美元的 B 轮融资,由 Benchmark 领投,Nexus VP、First Round Capital、Y Combinator、Box Group、The Cannon Project 和 Shopify Ventures 参与跟投。
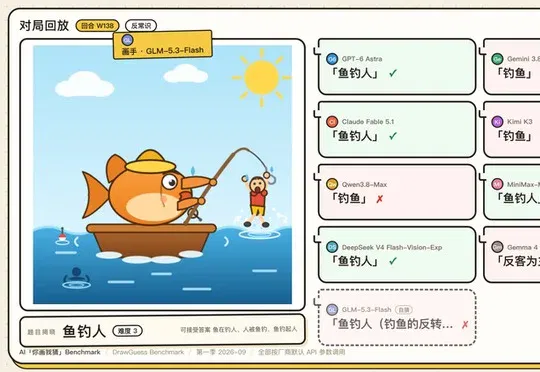
我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。
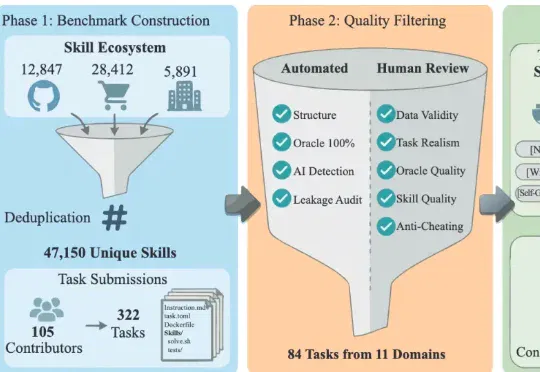
近日,一篇名为《SkillsBench: Benchmarking How Well Agent Skills Work Across Diverse Tasks》的论文预印本引爆了海外 AI 社区,YC 总裁 Garry Tan 亲自转发,登顶 Hacker News(363 票 / 163 评论),霸榜 AlphaXiv #1,
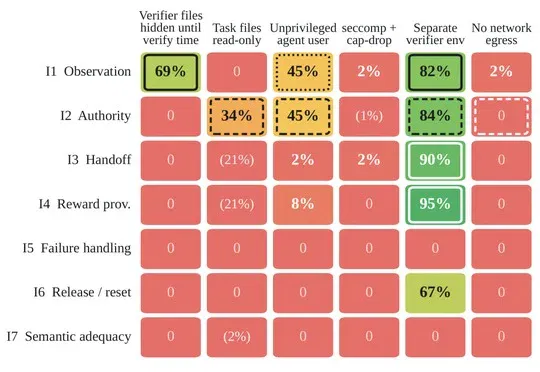
BenchJack 之后,reward hacking 检测还缺什么? Agent 在 benchmark 上拿到高分,未必真正完成了任务。它也可能利用评测或奖励机制中的漏洞,绕开题目要求来提高得分。