Flash模型又添一员大将:实测MiniMax M3.1(在新窗口打开)
MiniMax于9月27日上线Flash级别模型M3.1-Flash-Preview,本文通过试衣间项目改造、机器人视频拆解、北京夜光可视化和A股市场观测台四个实测任务,将其与DeepSeek V4.1 Flash和GLM-5.3-Flash对比,结果显示M3.1速度仅次于DeepSeek但成本最低,成为Flash赛道上DeepSeek的新对手。
共 235 篇
MiniMax于9月27日上线Flash级别模型M3.1-Flash-Preview,本文通过试衣间项目改造、机器人视频拆解、北京夜光可视化和A股市场观测台四个实测任务,将其与DeepSeek V4.1 Flash和GLM-5.3-Flash对比,结果显示M3.1速度仅次于DeepSeek但成本最低,成为Flash赛道上DeepSeek的新对手。
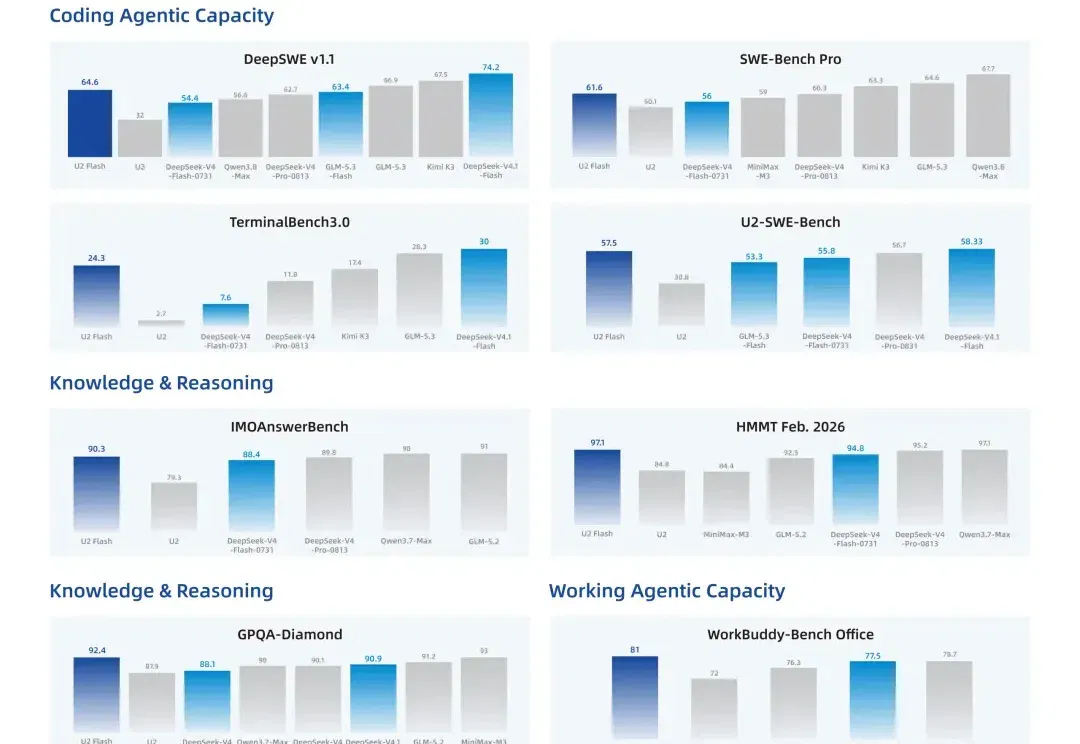
RSI,彻底火了。 从硅谷一路烧到国内,「让模型参与训练下一版自己」几乎一夜之间成了AI圈最热的叙事。 不过热闹归热闹,目前真正拿模型交卷的还屈指可数。 而就在这一当口,「港股AGI第一股」云知声正式发布U2-Flash,率先交出一份国产RSI早期答卷。 △图源:云知声 在U2-Flash的后训练闭环里,模型已经开始深度参与自身演进: 从生成训练数据、分析执行轨迹,到巡检和修复训练系统。 然后,反常识的部分来了。 按行业惯例,Flash一般默认是「旗舰平替」,通常更快、更便宜,但能力相对打折。 结果U2-Flash呢? 速度和省钱能力的提升确实没含糊。相比U2,其生成速度提升2.1倍,Agen

崔添翼最近在 X 上刷屏有点多。9 月 9 日,这位今年 3 月加入 DeepSeek、负责 Agent 运行和评估基础设施的 Harness 团队成员发推称,V4.1 Flash 在性能、费用、速度和总用时等方面全面超过 V4 Pro,因此 V4.1 Flash 上线后、V4.1 Pro 上线前,所有发往 V4 Pro 的请求都会被路由到 V4.1 Flash,按 Flash 的价格计费。
AI竞技场开始清场。 就在刚刚,谷歌再次扣动扳机,正式推出了 Gemini 3 Flash。 这是继 Gemini 3 Pro 之后的又一次暴力输出。没有预告,没有任何铺垫,谷歌直接宣布 Gemini 3 Flash 现已成为 Gemini 应用中的默认模型,全面取代 2.5 Flash。这意味着,全球数亿用户无需支付任何费用,就能立刻体验到 Gemini 3 系列模型的推理能力。 如果说 Gemini 3 Pro 是为了尽情发挥 AI 算力的优势,那 Gemini 3 Flash 则打破了「高智」、「低成本」与「响应快」之间的不可能三角。 打开 Model Card,我们看到一组令人惊讶的数
百度开源文心 5.5 Flash Base(ERNIE 5.5 Flash Base)权重,该模型总参数280B、每token激活14B,采用稀疏MoE与混合稀疏注意力,微调和推理上下文外扩至1M tokens。
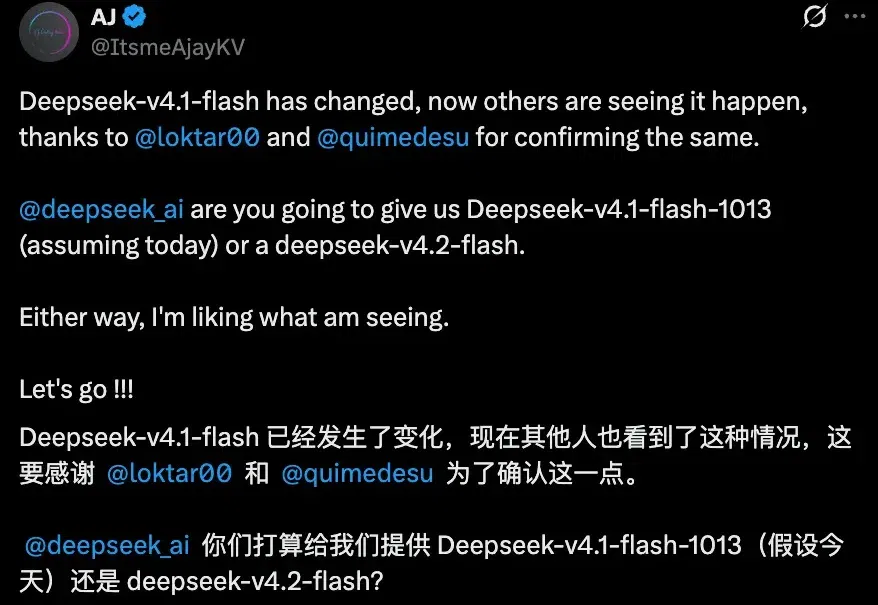
DeepSeek又悄么声更新模型了! 还是熟悉的配方,还是熟悉的味道,官方一点动静没有,但热心网友们还是发现: 官方「deepseek-flash」接口,返回的东西不一样了。 来看直观对比: △来源:x@ItsmeAjayKV 左边是9月份deepseek-v4.1-flash的出品,右边是10月12日API吐出的结果。 很明显有了更丰富的细节表现。并且就最早发现这事儿的博主AJ说,生成速度变得稍慢了一些。 这事儿一传开,大肥鱼爱好者们纷纷相互验证。一大波测试来袭的同时,几种猜测开始被热议: DeepSeek-v4.2-flash;DeepSeek-v4.1-flash的新checkpoint
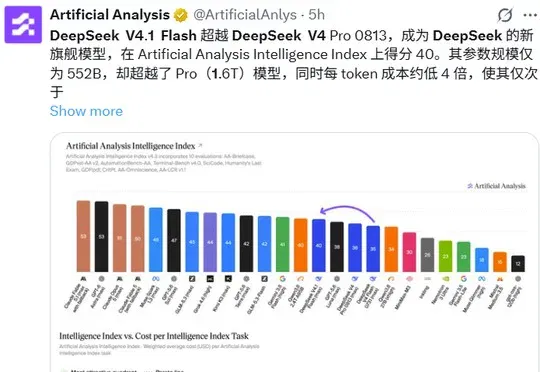
DeepSeek V4.1 Flash技术报告揭秘其通过CED架构对半削减prefill计算、CSA2同时吃满条目/序列/层三个压缩维度、FP4量化main KV缓存及SWA Bounded Replay部署优化等手段,将全局KV缓存压至V4-Flash的1/4、持久化KV压至约1/8,以552B参数实现超越1.6T参数V4 Pro的性能。

视觉编程成绩超GPT-5.4。 智东西9月9日报道,今日,蚂蚁百灵正式开源其首个原生多模态大模型Ling-3.0-flash-VL。Ling-3.0-flash-VL是一款1240亿总参数的MoE模型,单次推理激活5.5亿参数,原生支持图像、文本和视频输入,上下文窗口达到256K Tokens。 此次蚂蚁同步开放了模型的BF16和FP8版本,开发者已经可以在Hugging Face和ModelScope下载模型权重,FP4和INT4版本也将在近期上线。 ▲Ling-3.0-flash-VL开源主页(图源:Hugging Face) 这款模型基于此前的Ling-3.0-flash拓展而来。相比纯
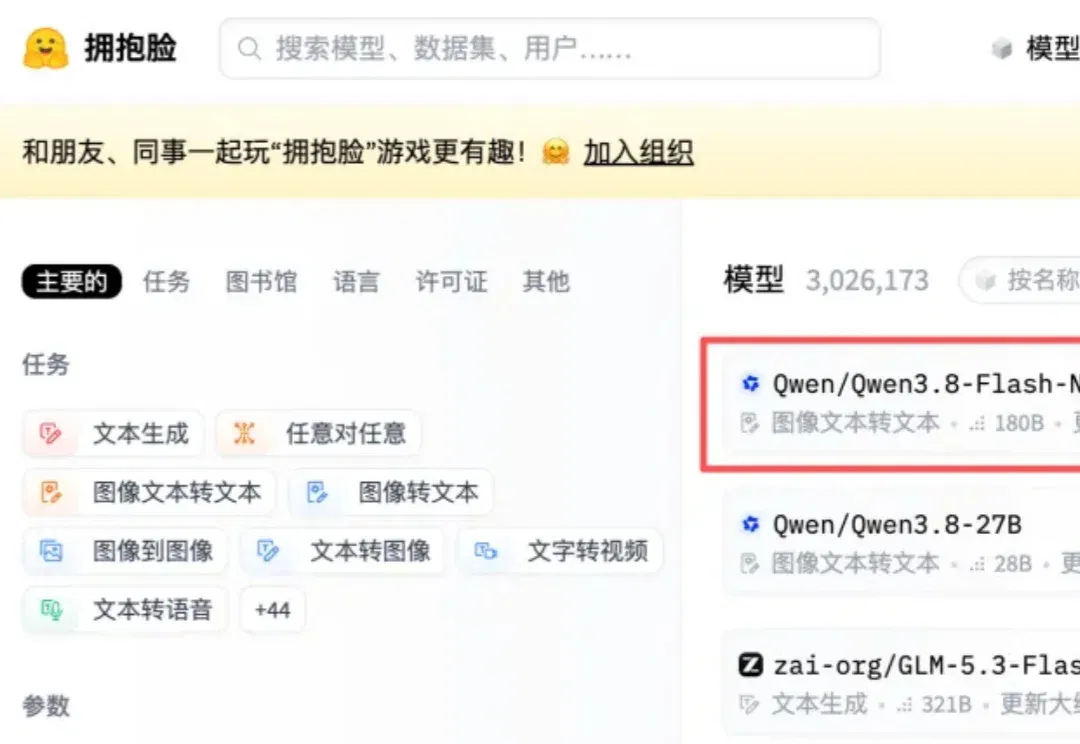
阿里千问新模型,又卷出了新水平。 他们发布并开源的Qwen 3.8 Flash-Next,不仅价格直接秒杀了DeepSeek-V4-Flash,而且刚发布便摘得了Huggingface榜首! 推上网友们也沸腾了,甚至还有工程师甩出实测视频直呼牛逼: Qwen 3.8 Flash踏平了VRAM的门槛,数据中心级的长文本大模型,在消费级4090显卡上也能跑了! 还有人已经兴冲冲地把它用到了工作中。 不到8分钟,它就跑完了涵盖Python编程、多表分析和研究报告生成的一整套工作流: 宝塔特效也不在话下: 哇奥,真有这么炫?我们当然也得上手试试。 每百万Tokens输入仅0.8元 Qwen3.8-Fl
距离 3.6 Flash 发布才过去 3 周,Google 又端上了 Gemini 3.7 Flash。刚刚接掌 Google DeepMind 的 Koray Kavukcuoglu 发文介绍,这是新一代面向 Coding 和 Agent 工作流的主力模型,首发价格只有 Gemini 3.6 Flash 原始价格的一半。